Mehr GPUs und günstigere Token allein machen KI noch nicht wirtschaftlich. Mit agentischen Anwendungen wächst der Aufwand für mehrstufige Prozesse, wechselnde Lasten und verlässliche Ergebnisse. Das Betriebsmodell der Token Factory verbindet Ressourcenmanagement, Inferenzoptimierung und Servicequalität. Für IT-Verantwortliche rückt damit eine andere Frage in den Mittelpunkt: Was kostet eine erfolgreich erledigte Aufgabe – und welche Architektur liefert sie zuverlässig? [1][2][3]
Management Summary
- Geschäftsergebnis statt Hardwarekennzahl: GPU-Auslastung und Token-Durchsatz zeigen technische Leistung, aber noch keinen wirtschaftlichen Nutzen. Maßgeblich sind verlässliche Ergebnisse innerhalb definierter Serviceziele. [1]
- Agenten verändern die Kostenrechnung: Wiederholte Modellaufrufe, längere Kontexte und zusätzliche Verarbeitungsschritte können Einsparungen je Token überkompensieren. Kostenkontrolle muss deshalb den vollständigen Workflow erfassen. [2][3]
- Die Token Factory braucht einen abgestimmten Betrieb: Ressourcenverteilung, Inferenzverarbeitung und Service-Governance müssen gemeinsam optimiert werden. Einzelne leistungsfähige Komponenten ersetzen keine durchgängige Betriebssteuerung. [1]
- Optimierung ist eine Frage des Workloads: Prefix-Caching kann wiederkehrende Eingaben beschleunigen; größere Batches und die Trennung von Prefill und Decode bringen jedoch Zielkonflikte mit sich. Entscheidend ist der Nutzen unter realen Last- und Latenzanforderungen. [1][4]
- FinOps wird zum Bestandteil der KI-Strategie: Unternehmen sollten Kosten je erfolgreichem Ergebnis, Qualität und Nutzung gemeinsam steuern. Das wirtschaftlich passende Modell ist nicht zwingend das größte, sondern das günstigste, das die Qualitätsanforderungen erfüllt. [3]
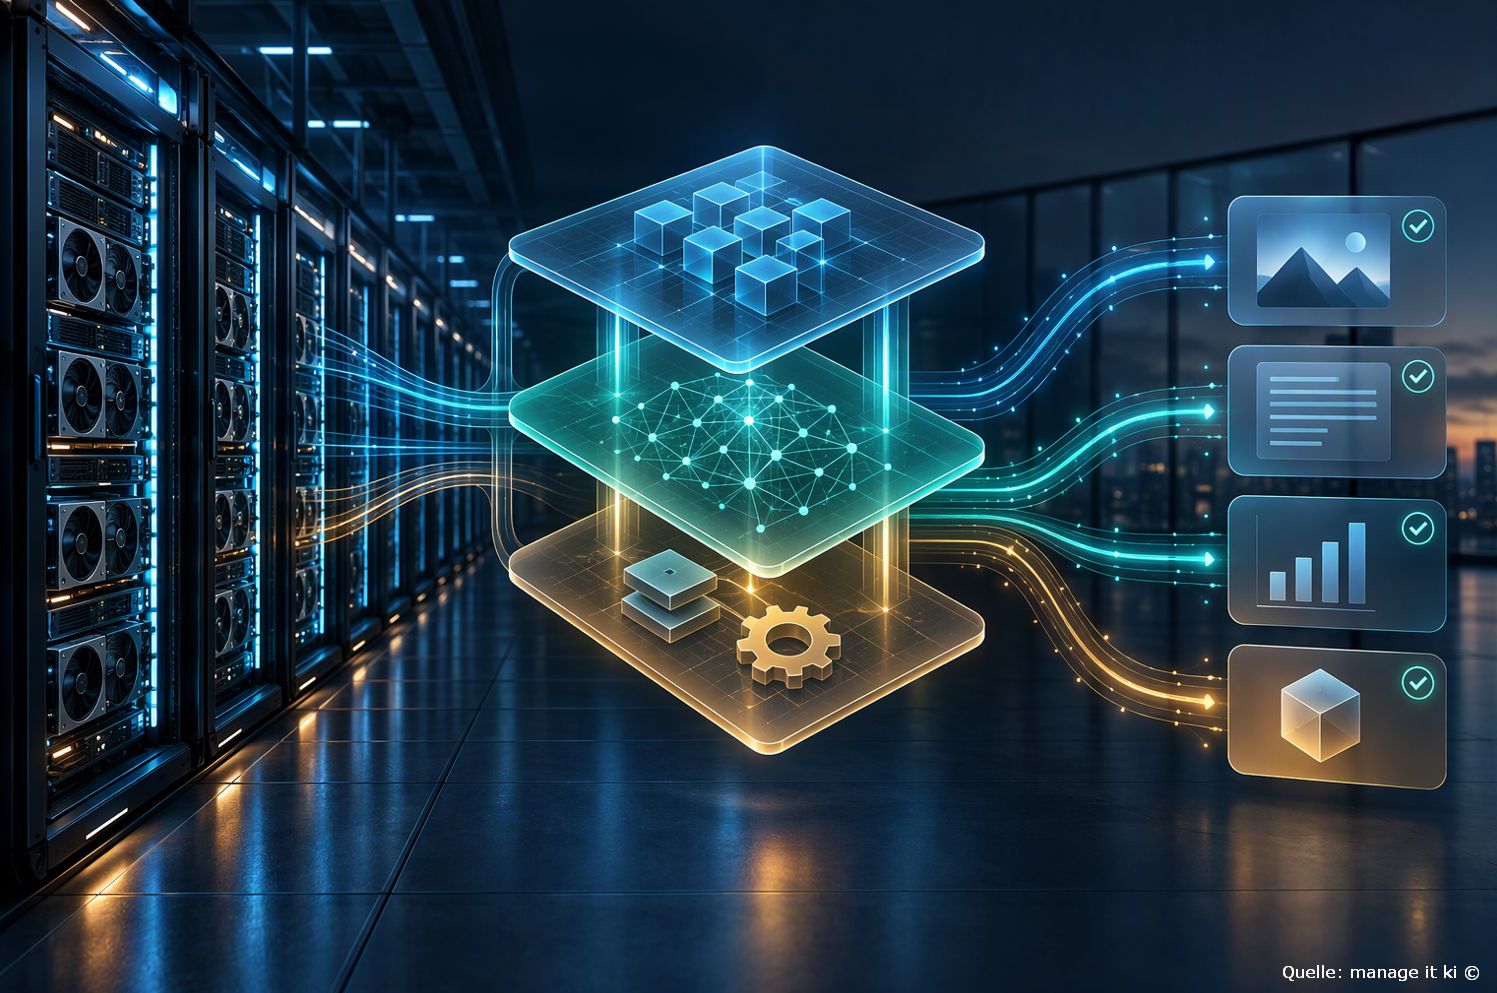
Illustration Absmeier
Vom GPU-Cluster zum nutzbaren Ergebnis: Eine Token Factory verbindet Infrastruktur, Inferenz und Servicebetrieb. KI-generierte Konzeptillustration, keine Darstellung eines konkreten Produkts.
Mit der zunehmenden Verbreitung von KI-Agenten verändern sich die Anforderungen an KI-Infrastrukturen. Neben GPU-Auslastung und Inferenzdurchsatz gewinnen Servicequalität, Ressourceneffizienz und kalkulierbare Betriebskosten an Bedeutung[i]. Denn agentische Anwendungen bearbeiten Aufgaben häufig in mehr als nur einem Schritt. Sie rufen KI-Modelle wiederholt auf, greifen auf externe Daten zu und nutzen andere Tools oder Anwendungen. Dadurch entstehen dynamische Workloads mit wechselndem Bedarf an Rechenleistung, Speicher und Parallelität. In einer Studie vom August 2026 prognostizierte Gartner, dass sich die Inferenzkosten eines einzelnen Agenten-Workflows bis 2028 mehr als verfünffachen werden[ii].
Infolgedessen entwickelt sich die GPU-Infrastruktur zunehmend zur sogenannten Token Factory weiter: einer Betriebsumgebung, die nicht nur Rechenleistung bereitstellt, sondern KI-Dienste zuverlässig und wirtschaftlich ausführt. Entscheidend ist dabei das Zusammenspiel von Ressourcenmanagement, Inferenzoptimierung und Servicebetrieb. In diesem Zusammenhang zeigt KI-Infrastrukturanbieter KAYTUS auf, dass nicht die Menge der verfügbaren KI-Rechenleistung über den wirtschaftlichen Erfolg entscheidet, sondern wie zuverlässig und kosteneffizient daraus nutzbare KI-Ergebnisse entstehen.
Neue Workloads verändern die Anforderungen
KI-Agenten unterscheiden sich von klassischen Modellabfragen durch ihre mehrstufige Arbeitsweise. Sie zerlegen Aufgaben in Teilschritte, verarbeiten umfangreiche Kontexte und lösen zusätzliche Modellaufrufe aus. Der Ressourcenbedarf hängt deshalb von Faktoren wie der Anzahl und Parallelität der Anfragen, der Komplexität der Aufgaben und der Kontextlänge sowie der Wiederverwendung bereits vorhandener Cache-Ergebnisse und Schwankungen der Lastprofile ab.
Damit verändern sich die Maßstäbe für die Leistungsbewertung. Eine hohe GPU-Auslastung bedeutet nicht automatisch, dass besonders viele Anfragen innerhalb definierter Serviceziele bearbeitet werden. Auch ein hoher Gesamtdurchsatz kann mit unzureichenden Antwortzeiten für einzelne Nutzer einhergehen.
Systemübergreifende Koordination
Die Effizienz einer Token Factory lässt sich nicht allein durch die Optimierung einzelner Hardware- oder Softwarekomponenten steigern. Ressourcenmanagement, Inferenzverarbeitung und Servicebetrieb müssen auf gemeinsame Ziele ausgerichtet werden. Entscheidend hierbei sind:
Das Ressourcenmanagement: Rechenkapazitäten sollten entsprechend dem tatsächlichen Bedarf verteilt werden. Dies beinhaltet etwa die gemeinsame Nutzung von GPU-Ressourcen, die dynamische Zuweisung von Kapazitäten und die Anpassung an wechselnde Lastprofile. Ziel ist es, ungenutzte Ressourcen zu reduzieren, Engpässe zu vermeiden und verfügbare Kapazitäten möglichst wirkungsvoll einzusetzen.
Die Optimierung der Inferenz: Die Inferenz umfasst unterschiedliche Verarbeitungsschritte. Die getrennte Steuerung der Verarbeitungsschritte »Prefill« und »Decode« kann helfen, unterschiedliche Ressourcenanforderungen gezielter zu bedienen, und zwischengespeicherte Informationen können bei wiederkehrenden Kontexten erneute Berechnungen vermeiden. Anfragen und Ressourcen können entsprechend Parallelität, Modellanforderungen und Servicezielen verteilt werden.
Der Servicebetrieb und die Governance: Neben der technischen Verarbeitung muss auch der laufende Betrieb berücksichtigt werden. So sind Mechanismen erforderlich, um Nutzung, Qualität und Kosten transparent zu steuern. Dazu zählen etwa einheitliche API für den Modellzugriff oder die Überwachung von Antwortzeiten, Durchsatz und Service-Level-Zielen (SLOs). Erst das Zusammenspiel aller Ebenen ermöglicht es, technische Optimierungen in eine bessere Gesamtleistung zu übersetzen.
Wirtschaftlichkeit der Token Factory
Um die Wirtschaftlichkeit einer Token Factory zu bewerten, müssen Durchsatz, Antwortzeiten, Zuverlässigkeit und Einzelkosten gemeinsam betrachtet werden. Einzelne Messwerte liefern nur ein unvollständiges Bild. So bedeuten etwa Einsparungen pro Token nicht automatisch, dass eine KI-Anwendung insgesamt günstiger wird. Bei agentischen Workflows können zusätzlich notwendige Modellaufrufe, Interaktionen mit anderen Anwendungen und erneute Versuche mögliche Einsparungen aufzehren, weil zwar die Kosten pro einzelnem Token sinken, die Zahl der insgesamt bis zur Aufgabenerledigung benötigten Token aber steigt. Deshalb rückt eine übergeordnete Kennzahl in den Fokus: die Gesamtkosten pro erfolgreich abgeschlossener Aufgabe. Sie berücksichtigt den Aufwand für ein Ergebnis, das die geforderten Qualitätskriterien erfüllt, statt lediglich die Kosten einzelner Token zu betrachten.
Die Token Factory als Betriebsmodell für skalierbare KI
Der Wandel von der GPU-Infrastruktur zur Token Factory beschreibt mehr als eine technische Weiterentwicklung. Im Mittelpunkt steht nicht mehr allein die Bereitstellung von Hardware, sondern der zuverlässige und wirtschaftliche Betrieb von KI-Diensten.
Dafür müssen drei Bereiche systematisch zusammenwirken:
- Infrastruktur: GPU-Ressourcen sollten bedarfsgerecht bereitgestellt und genutzt werden können.
- Inferenz: Modellverarbeitung, Speicherzugriffe und Anfragen sollten an die jeweiligen Workloads angepasst werden.
- Servicebetrieb: Es gilt, Qualität, Zugriff, Nutzung und Kosten transparent zu steuern.
»Integrierte KI-Entwicklungsplattformen wie MotusAI können diese drei Ebenen verbinden und eine gemeinsame Grundlage für Planung, Überwachung und Optimierung schaffen. Voraussetzung ist, dass technische Leistungsdaten mit den tatsächlichen Anforderungen der Anwendungen verknüpft werden«, erklärt Darren Cox, General Manager Europe bei KAYTUS. »Der entscheidende Fortschritt liegt somit nicht allein in mehr Rechenleistung oder einem höheren Token-Durchsatz. Er liegt in der Fähigkeit, KI-Dienste unter realen Bedingungen zuverlässig, skalierbar und wirtschaftlich zu betreiben.«
Die Token Factory entwickelt sich damit zu einem wichtigen IT-Architektur- und Betriebsmodell für den produktiven Einsatz agentischer KI. MotusAI und ähnliche Lösungen schaffen die Voraussetzungen dafür, indem sie Unternehmen sowie Neocloud-Anbietern ermöglichen, GPU-Management und Inferenzoptimierung in operative Fähigkeiten umzuwandeln, die notwendig sind, um Token-Services kontinuierlich bereitzustellen und effektiver zu konkurrieren.
Zusätzliche Informationen zu diesem Thema finden Sie auch unter: https://www.kaytus.com/blog/27831.html
[i] https://arxiv.org/abs/2608.15127?utm_source=chatgpt.com
[ii] https://www.gartner.com/en/newsroom/press-releases/2026-08-17-gartner-predicts-ai-inference-costs-per-agentic-workflow-will-increase-more-than-fivefold-through-2028
Tipps für die Praxis
Die folgenden Empfehlungen leiten sich aus den recherchierten Betriebs- und FinOps-Prinzipien ab. Sie sind keine Garantie für bestimmte Einsparungen.
- Erfolg vorab definieren — Qualität zuerst: Legen Sie mit dem Fachbereich fest, wann eine Aufgabe als erfolgreich abgeschlossen gilt. Vergleichen Sie Modelle und Architekturen nur bei gleichen Qualitätsanforderungen. [3]
- Kosten vollständig zuordnen — Den Workflow messen: Ordnen Sie Verbrauch und Ausgaben einem Anwendungsfall, Modell und Verantwortungsbereich zu. Berücksichtigen Sie neben Modellaufrufen auch gemeinsam genutzte Infrastruktur und unterstützende Dienste; dokumentieren Sie die Kostengrenzen. [1][3]
- Serviceziele verbindlich machen — Latenz und Durchsatz zusammen betrachten: Definieren Sie getrennte Ziele für interaktive und nicht zeitkritische Anwendungen. Prüfen Sie, wie viel Durchsatz tatsächlich innerhalb dieser Ziele erreicht wird, statt nur Spitzenwerte zu vergleichen. [1]
- Modelle aufgabenbezogen auswählen — Nicht automatisch das größte Modell: Testen Sie, welches Modell die erforderliche Qualität zu vertretbaren Kosten liefert. Nutzen Sie leistungsfähigere Modelle gezielt für Aufgaben, die sie benötigen. [2][3]
- Kontexte und Caches gezielt nutzen — Wiederholungen vermeiden: Prüfen Sie wiederkehrende Eingabepräfixe und messen Sie Cache-Treffer. Prefix-Caching hilft bei wiederverwendbarem Kontext, beschleunigt aber nicht automatisch die Ausgabe neuer Token. [4]
- Architektur unter Last prüfen — Zielkonflikte sichtbar machen: Testen Sie Batching, Routing und eine mögliche Trennung von Prefill und Decode mit repräsentativen Lastprofilen. Beachten Sie Warteschlangen, Kapazitätsbalance und den Aufwand für Cache-Transfers. [1]
- Governance mitplanen — Gemeinsame Plattform, klare Grenzen: Legen Sie Berechtigungen, Mandantentrennung, Quoten und Kostenverantwortung fest. Prüfen Sie bei gemeinsam genutzten Prefix-Caches zusätzlich die vorgesehenen Isolationsmechanismen. [1][5]
FAQ: Zehn Fragen zur Token Factory
1. Was ist eine Token Factory?
Der Begriff beschreibt hier ein Betriebsmodell, das GPU-Ressourcen, Modellbereitstellung, Inferenzoptimierung und Serviceverwaltung zusammenführt. Ziel ist nicht die Bereitstellung möglichst vieler GPUs, sondern ein verlässlicher KI-Dienst mit kontrollierbarer Leistung und Kostenstruktur. KAYTUS verwendet den Begriff für diesen Übergang von Rechenkapazität zu produktiven Token-Services; die Darstellung ist eine Herstellerperspektive. [1]
2. Warum können KI-Kosten steigen, obwohl Token günstiger werden?
Agentische Anwendungen benötigen häufig mehr Modellaufrufe und umfangreichere Verarbeitung als einfache Chatbot-Abfragen. Sinkende Stückpreise können deshalb von einem steigenden Verbrauch überlagert werden. Gartner bezeichnet dies als »Inference Paradox« und prognostiziert bis 2028 eine mehr als Verfünffachung der Inferenzkosten je agentischem Workflow. Das ist eine Prognose, kein bereits eingetretener oder für jedes Unternehmen geltender Kostenanstieg. [2]
3. Welche Kennzahlen sollten IT-Verantwortliche gemeinsam betrachten?
Zur technischen Sicht gehören GPU-Auslastung, Durchsatz und Antwortzeiten, insbesondere die Zeit bis zum ersten Token (Time to First Token, TTFT). Für den Servicebetrieb zählt, ob die festgelegten Serviceziele eingehalten werden. Die wirtschaftliche Sicht ergänzt Kosten je erfolgreichem Ergebnis und die dazugehörige Qualität. Ein hoher Spitzendurchsatz allein beantwortet weder die Service- noch die Kostenfrage. [1][3]
4. Wann lohnt sich die getrennte Steuerung von Prefill und Decode?
Die Trennung kann helfen, Ressourcen den unterschiedlichen Verarbeitungsphasen gezielter zuzuweisen. Sie ist aber kein Selbstläufer: Kapazitäten müssen ausbalanciert werden, und die Übertragung von Cache-Daten verursacht zusätzlichen Aufwand. Entscheidend ist deshalb ein Vergleich unter den tatsächlichen Lastprofilen und Servicezielen, nicht die Annahme, dass eine stärker aufgeteilte Architektur grundsätzlich effizienter ist. [1]
5. Was bringt Prefix-Caching – und wo liegen die Grenzen?
Prefix-Caching nutzt bereits berechnete Zustände wieder, wenn eine neue Anfrage mit einem vorhandenen Eingabepräfix übereinstimmt. Das kann beispielsweise bei wiederholten Fragen zu demselben Dokument helfen. Laut vLLM verkürzt es die Verarbeitung der Eingabe, nicht die Erzeugung neuer Ausgabetoken. Ohne gemeinsame Präfixe oder bei überwiegend langen Ausgaben fällt der Nutzen entsprechend geringer aus. [4]
6. Wie werden Kosten je erfolgreich abgeschlossener Aufgabe ermittelt?
Teilen Sie die dem Anwendungsfall zugeordneten Kosten eines Zeitraums durch die Zahl der Ergebnisse, die die vereinbarten Erfolgskriterien erfüllen. Legen Sie vorher fest, welche Infrastruktur-, Modell- und Servicekosten einbezogen werden. Fehlversuche dürfen nicht als erfolgreiche Ergebnisse zählen; ihre Kosten dürfen nicht aus der Betrachtung verschwinden. Die FinOps Foundation empfiehlt, Kosten je erfolgreichem Ergebnis zu messen und die Schwankungsbreite sichtbar zu machen. [3]
7. Ist ein kleineres Modell automatisch wirtschaftlicher?
Nein. Ein günstigeres Modell ist nur dann die bessere Wahl, wenn es die Qualitätsanforderungen der Aufgabe erfüllt. Niedrige Token-Preise allein reichen als Entscheidungskriterium nicht aus. FinOps empfiehlt das kostengünstigste Modell, das die geforderte Qualität erreicht; Gartner betont zudem die Bedeutung aufgabenbezogener Modellwahl und abgestimmter Orchestrierung. Die Entscheidung sollte deshalb anhand derselben Testaufgaben und Akzeptanzkriterien getroffen werden. [2][3]
8. Was ist bei gemeinsam genutzten KI-Diensten zu beachten?
Mehrere Teams oder Kunden benötigen kontrollierte Zugriffe, Quoten und eine nachvollziehbare Kostenzuordnung. Auch Caches müssen in das Sicherheitskonzept einbezogen werden. vLLM dokumentiert optionale anfragespezifische »Salts«, mit denen die Wiederverwendung von Prefix-Caches isoliert werden kann, und weist auf Risiken nicht kryptografisch sicherer Hash-Verfahren hin. Welche Trennung erforderlich ist, muss für die konkrete Betriebsumgebung geprüft werden. [1][5]
9. Wann ist Eigenbetrieb sinnvoller als eine Modell-API?
Eine allgemeingültige Volumenschwelle lässt sich aus den verwendeten Quellen nicht ableiten. Verglichen werden müssen unter anderem API-Verbrauch, GPU- und Rechenzentrumsaufwand, unterstützende Dienste und Betriebsanforderungen. Die FinOps Foundation beschreibt diese unterschiedlichen Ausgabenkanäle und betont die gemeinsame Bewertung von Kosten und erfolgreichen Ergebnissen. Praxisempfehlung: Prüfen Sie beide Varianten mit demselben Workload, denselben Qualitätszielen und einer offen dokumentierten Kostengrenze. [3]
10. Wie gelingt der Einstieg, ohne sofort die gesamte Infrastruktur umzubauen?
Die FinOps Foundation empfiehlt einen schrittweisen Aufbau: zunächst Ausgaben sichtbar machen und zuordnen, danach Modelle und Verbrauch optimieren; längerfristige Verpflichtungen erst bei stabiler Nutzung eingehen. Daraus folgt als Praxisempfehlung: Beginnen Sie mit einem klar abgegrenzten Anwendungsfall, erfassen Sie Qualität, Latenz und vollständige Kosten und prüfen Sie erst dann die Skalierung. Eine Plattform wie MotusAI sollte anhand nachgewiesener Betriebsfunktionen im eigenen Umfeld bewertet werden, nicht allein anhand des Begriffs »Token Factory«. [1][3]
Zusätzliche Informationen zu diesem Thema finden Sie auch unter: https://www.kaytus.com/blog/27831.html
[i] https://arxiv.org/abs/2608.15127?utm_source=chatgpt.com
[ii] https://www.gartner.com/en/newsroom/press-releases/2026-08-17-gartner-predicts-ai-inference-costs-per-agentic-workflow-will-increase-more-than-fivefold-through-2028
Quellen der redaktionellen Ergänzungen
Die Ziffern [1] bis [5] beziehen sich auf Vorspann, Management Summary, Praxistipps und FAQ. Die ursprünglichen Quellenverweise [i] und [ii] im Artikel bleiben unverändert. Abrufdatum der folgenden Internetquellen: 12. November 2026.
[1] KAYTUS: MotusAI: From GPU Infrastructure to Token Factories. Herstellerquelle, 6. November 2026.
https://www.kaytus.com/blog/27831.html
[2] Gartner: Gartner Predicts AI Inference Costs Per Agentic Workflow Will Increase More Than Fivefold Through 2028. Pressemitteilung und Prognose, 17. August 2026.
https://www.gartner.com/en/newsroom/press-releases/2026-08-17-gartner-predicts-ai-inference-costs-per-agentic-workflow-will-increase-more-than-fivefold-through-2028
[3] FinOps Foundation: FinOps for AI Overview. Praxisleitfaden zur Kosten- und Wertsteuerung von KI.
https://www.finops.org/wg/finops-for-ai-overview/
[4] vLLM: Automatic Prefix Caching. Technische Projektdokumentation zu Nutzen und Grenzen.
https://docs.vllm.ai/en/latest/features/automatic_prefix_caching/
[5] vLLM: Automatic Prefix Caching – Design. Technische Projektdokumentation zu Cache-Isolation und Hash-Verfahren.
https://docs.vllm.ai/en/latest/design/prefix_caching/
[6] manage it: Die Kosten von KI? Nicht, was Sie vermuten. Redaktionelles Stilvorbild für die managementorientierte Gliederung und die prägnanten Kernaussagen; nicht als technischer Beleg verwendet.
https://ap-verlag.de/die-kosten-von-ki-nicht-was-sie-vermuten/106754/
Management Summary, Tipps, FAQ und Bilder wurden mit Hilfe von KI erstellt
8239 Artikel zu „Kosten KI“
Digitale Transformation | Effizienz | Künstliche Intelligenz | Nachhaltigkeit | New Work | News | Tipps | Trends 2026 | Trends Geschäftsprozesse
Vom KI-Hype zur Wirkung: Kompetenzen, Kosten und Nachhaltigkeit im Fokus
Laut der TMC-Umfrage sehen nur 20 Prozent der befragten Hightech-Fachkräfte KI als Bedrohung. Für Entscheider steht damit nicht allein die Akzeptanz im Mittelpunkt, sondern die Frage nach dem konkreten Nutzen: Welche Aufgaben profitieren, welche Kompetenzen sind erforderlich und wie lassen sich Kosten und Ressourcenbedarf bewerten? Die genannten Umfragewerte sind hier nicht unabhängig bestätigt. Management Summary…
Business | Geschäftsprozesse | Künstliche Intelligenz | News | Strategien | Tipps | Whitepaper
KI-Monetarisierung 2027: Hybride Preismodelle setzen sich gegen die Kostenfalle durch
Bild: KI-Monetarisierung verlangt eine Balance zwischen Rechenkosten, planbaren Preisen und wirtschaftlichem Nutzen. Quelle: KI-generiert. KI verändert die Softwareökonomie, aber nicht so geradlinig wie erwartet: Anbieter integrieren neue Funktionen in Rekordtempo, während Kunden bei Nutzung und Budget vorsichtig bleiben. Gefragt sind deshalb Preismodelle, die Innovation, Kostentransparenz und Profitabilität miteinander verbinden – und belastbare Nutzungsdaten, die…
Effizienz | Favoriten der Redaktion | Geschäftsprozesse | Künstliche Intelligenz | New Work | News | Strategien | Tipps
KI-Agenten sind kein bloßes Instrument zur Kosteneinsparung: So lässt sich eine hybride Belegschaft nachhaltig gestalten

KI-Agenten verändern nicht nur Prozesse, sondern die Architektur von Arbeit. Wer sie vorschnell als Ersatz für Beschäftigte einplant, unterschätzt Kosten, Kontextbedarf und operative Risiken. Entscheidend ist ein gemeinsames Betriebsmodell, das menschliches Erfahrungswissen, belastbare Daten, klare Verantwortlichkeiten und nachvollziehbare Kontrollen zu einer hybriden Belegschaft verbindet. Management Summary Wertbeitrag statt Sparreflex: KI-Agenten sollten an Umsatz, Qualität, Geschwindigkeit…
Effizienz | Favoriten der Redaktion | Künstliche Intelligenz | News | Services | Strategien | Tipps
Das KI-Kostenparadox: Warum günstige Tokens Unternehmen teuer zu stehen kommen
Agentische Workflows treiben den Verbrauch trotz sinkender Modellpreise. Wie Unternehmen mit Cost per Result, Kontext-Engineering und Model Routing gegensteuern. Der Preis pro Token ist für die Wirtschaftlichkeit von KI nur ein Teil der Rechnung. Entscheidend ist, wie viel Kontext, Rechenaufwand, Validierung und Nacharbeit erforderlich sind, bis ein akzeptiertes Ergebnis vorliegt. Management Summary Ergebnis statt…
Business | Effizienz | Favoriten der Redaktion | Geschäftsprozesse | Künstliche Intelligenz | News | Strategien | Tipps
Kostenfalle im KI-Betrieb vermeiden: Neue Ansätze für die nachhaltige Wirtschaftlichkeit von KI
KI-Projekte scheitern im produktiven Betrieb selten an der Idee, sondern zunehmend an der Kostenlogik. Wer Inferenz, Infrastruktur und Governance frühzeitig zusammendenkt, verhindert, dass erfolgreiche Proofs of Concept später zur wirtschaftlichen Belastung werden. Management Summary Inferenz wird zum eigentlichen Kostentreiber: Nicht das Modelltraining, sondern jede produktive Nutzung entscheidet über die langfristige Wirtschaftlichkeit von KI. PoCs…
Business | Effizienz | Künstliche Intelligenz | News | Trends 2026 | Trends 2027 | Trends 2028 | Trends Wirtschaft
KI-Inferenzkosten pro agentenbasiertem Workflow steigen bis 2028 um mehr als das Fünffache

Agentenbasierte KI verspricht leistungsfähigere Anwendungen, verändert aber zugleich die Kostenlogik von KI-Produkten. Gartner warnt vor einem Inferenz-Paradoxon: Obwohl Token günstiger werden, steigen die Gesamtkosten, weil komplexere Workflows deutlich mehr und oft teurere Modellaufrufe benötigen. Management Summary: Gartner erwartet, dass die KI-Inferenzkosten pro agentenbasiertem Workflow bis 2028 um mehr als das Fünffache steigen. Sinkende Modell- und…
Business | Business Process Management | Effizienz | Favoriten der Redaktion | Künstliche Intelligenz | Nachhaltigkeit | News | Rechenzentrum
Die Kosten von KI? Nicht, was Sie vermuten
Weshalb die Operationalisierung von Unternehmensdaten die nächste wirtschaftliche Herausforderung für produktive KI darstellt. Management Summary KI-Kosten entstehen nicht nur bei der Inferenz: Sinkende Token-Preise sind wichtig, lösen aber nicht die eigentliche Kostenfrage produktiver Enterprise AI. Datenzugriff wird zum zentralen Engpass: Der wirtschaftliche Nutzen von KI hängt davon ab, ob relevante Unternehmensinformationen auffindbar, zugreifbar und…
Business | Business Process Management | Effizienz | Künstliche Intelligenz | News | Strategien | Tipps
Effizientes Datenmanagement: Warum KI-Kosten schon im Data Layer entschieden werden
Unternehmen optimieren bei KI häufig am Modell – und übersehen den eigentlichen Kostentreiber: die Datenarchitektur. Wer Token-Verbrauch, Kopien, Governance und Kontextbereitstellung früh kontrolliert, senkt nicht nur Ausgaben, sondern schafft auch die Grundlage für skalierbare, vertrauenswürdige KI-Anwendungen. Management Summary KI-Kosten entstehen nicht erst beim Modellaufruf, sondern bereits bei Datenaufbereitung, Kontextauswahl, Zugriffspfaden und Kopien. Agentische KI…
Business | Infrastruktur | News | Services | Tipps
Kompatible Toner im Unternehmen: Wie IT-Verantwortliche Druckkosten senken, ohne Qualität zu riskieren
Qualitätsgeprüfte kompatible Toner senken die Kosten pro Seite deutlich – bei vergleichbarer Reichweite und Druckqualität wie Originalkartuschen. Für IT-Verantwortliche mit großem Gerätepark ist der Umstieg deshalb ein schneller Hebel: rechtlich unbedenklich und ohne pauschales Garantierisiko für die Drucker. Denn Druckkosten sind in vielen Unternehmen ein unterschätzter Posten – und sie liegen fast vollständig im Verbrauchsmaterial.…
Ausgabe 5-6-2026 | Infrastruktur | Künstliche Intelligenz | Lösungen | News
Wie Unternehmen KI-Kosten im Griff behalten – Von Tokenmaxxing zu Kontext
Agentische KI ist der Trend in der Unternehmens-IT. Doch der zunehmende Einsatz autonomer Agentensysteme treibt den Ressourcenverbrauch in die Höhe. Kontextmodelle helfen KI-Agenten, schneller und effizienter ,ans Ziel zu kommen – und ermöglichen Unternehmen, ihre KI-Kosten im Griff zu behalten.
Business | Business Process Management | Geschäftsprozesse | Künstliche Intelligenz | News | Services
Kosten- und Qualitätssteuerung bei agentenbasierten KI-Workflows

Unternehmen stehen beim Einsatz agentenbasierter KI-Workflows vor zwei zentralen Herausforderungen: schwer kalkulierbaren Betriebskosten und schwankender Ergebnisqualität. Besonders bei Modellen mit nutzungsabhängiger Abrechnung können steigende Anfragevolumina und komplexe Verarbeitungsschritte zu erheblichen Mehrkosten führen. Gleichzeitig steigt mit wachsender Komplexität das Risiko inkonsistenter oder unzureichender Antworten. In der Praxis zeigt sich, dass viele Organisationen bei der Überführung…
Business | Favoriten der Redaktion | Geschäftsprozesse | Künstliche Intelligenz | News | Services | Tipps
Warum die Kosten der KI‑Nutzung steigen – und welche Rolle Tokens dabei spielen
Die wirtschaftliche Nutzung von KI erlebt 2026 eine Phase massiver Kostensteigerungen. Unternehmen, die KI ursprünglich als Effizienztreiber eingeführt haben, sehen sich nun mit Ausgaben konfrontiert, die in vielen Fällen die Personalkosten übersteigen. Ein zentraler Mechanismus hinter dieser Entwicklung ist das tokenbasierte Abrechnungsmodell moderner Sprachmodelle. Die Analyse zeigt: Die Kombination aus wachsendem Verbrauch, komplexeren Workflows und…
E-Commerce | Geschäftsprozesse | Kommentar | News | Services | Strategien
Zwischen KI-Hype und Kostenrealität: Trends im Retourenmanagement 2026

Kommentar von Artjom Bruch, CEO von Trusted Returns Schon seit Jahren wächst der Onlinehandel – doch 2026 steht der E‑Commerce unter ganz anderem Druck als noch in den letzten Jahren: Margen schrumpfen, Marktplätze gewinnen an Macht, KI verändert Einkaufspfade – und die Retourenabwicklung bleibt der teuerste blinde Fleck. Artjom Bruch, CEO von Trusted Returns,…
Business | Digitale Transformation | Favoriten der Redaktion | Künstliche Intelligenz | News | Tipps
Die Schattenkosten von KI-Investitionen und wie man sie sichtbar macht

In den vergangenen Jahren hat der Hype um künstliche Intelligenz zu Milliarden-Investitionen und großen Erwartungen geführt. Organisationen hoffen auf spürbare Effizienz- und Produktivitätssteigerungen sowie eine grundlegende Verbesserung ihrer Abläufe. In Deutschland erwarten laut der Bitkom-Studie »Künstliche Intelligenz in der deutschen Wirtschaft« 73 Prozent der Unternehmen eine Stärkung ihrer Wettbewerbsfähigkeit, 64 Prozent sinkende Kosten und 68…
Cloud Computing | Künstliche Intelligenz | News | Strategien | Trends 2025 | Trends Wirtschaft
Das Cloud-Kosten-Dilemma: Steigende Ausgaben behindern KI-Innovation in Europa
Während Unternehmen in ganz Europa weiterhin stark in KI investieren, zeigt sich eine harte Realität: Die mit der Cloud-Infrastruktur verbundenen Kosten steigen rasant an und zwingen Unternehmen dazu, schwierige Entscheidungen über die Verteilung ihrer IT-Budgets zu treffen. In meiner Rolle habe ich die Herausforderungen aus erster Hand erlebt, mit denen Unternehmen konfrontiert sind, wenn es…
Business | Künstliche Intelligenz | News | Trends 2025 | Trends Services | Trends Wirtschaft
Zwei Drittel der Unternehmen nutzen kostenpflichtige KI-Dienste

Unternehmen, die KI einsetzen, sind zumeist bereit dafür zu zahlen. KI findet Einzug in Produkte und Dienstleistungen – wird aber auch für die Verbesserung des eigenen Geschäftsbetriebs genutzt. Mit dem KI-Chat eine Antwortmail entwerfen, lange Texte zusammenfassen oder in der Entwicklungsabteilung Softwarecode schreiben: Unternehmen, die künstliche Intelligenz nutzen, setzen dabei überwiegend auf kostenpflichtige Dienste.…
Business | Digitalisierung | Künstliche Intelligenz | New Work | News | Trends 2025 | Trends Wirtschaft
Unternehmen setzen verstärkt auf KI, um Personalmangel und steigende Kosten zu kompensieren

62 % der deutschen Unternehmen blicken optimistisch auf das Jahr 2025 – dennoch bleiben Inflation, hohe Energiekosten und der Fachkräftemangel große Herausforderungen, insbesondere aufgrund der damit verbundenen finanziellen Belastungen. Über die Hälfte (55 %) der deutschen Unternehmen gibt an, dass steigende Lohn- und Sozialabgaben sowie andere Faktoren sie eher dazu veranlassen, auf künstliche Intelligenz (KI)…
Cloud Computing | News | Services | Trends Cloud Computing | Trends Services | Whitepaper
KI-Boom und Kostendruck geben AWS-Partnergeschäft starke Wachstumsimpulse

ISG hat 47 Dienstleister untersucht, die im deutschen Teil des Ökosystems von Amazon Web Services tätig sind. Gute Marktchancen haben Provider, die Beratungs-, Migrations- und Betriebsleistungen aus einer Hand bieten. Auch hierzulande zählt Amazon Web Services (AWS) zu den wichtigsten Anbietern von Public Cloud Services für Geschäftskunden. Dank dessen anhaltend hoher Innovationskraft, etwa bei…
Business | Effizienz | Favoriten der Redaktion | Künstliche Intelligenz | News | Whitepaper
KI und Kosten-Nutzen-Rechnung: Wenn ein Wunderkind erwachsen werden soll

Für den kosteneffizienten Einsatz von KI braucht es mehr als die Technologie selbst. Fünf Mythen, bei denen Finanzdienstleister aufhorchen sollten. Der Siegeszug der KI: Von Marketing bis Marktforschung, Big-Data-Analyse bis Betrugsprävention integrieren Finanzdienstleister künstliche Intelligenz (KI) in ihre Geschäftsprozesse. In der Regel arbeiten sie dabei mit den marktbeherrschenden Public-Cloud-Anbietern zusammen. Aber auch mittelständische Private-Cloud-Dienstleister…