Illustration Absmeier foto ki
Zwei Ausfälle innerhalb von 48 Stunden haben vergangene Woche weltweit die Arbeit sowie den Reiseverkehr in den gesamten USA lahmgelegt. Keiner der Ausfälle war ein Angriff, beide waren selbstverschuldet. Wenn Routineänderungen Microsoft 365 oder den amerikanischen Luftraum in derselben Woche in die Knie zwingen können, sollte man sich fragen, was böswillige Täter anrichten könnten. Resilienz ist spätestens jetzt kein Notfallplan mehr. Sie ist ein Mandat für das C-Level.
Management Summary
- Weckruf statt Einzelfall: Die Ausfälle von Microsoft 365 und der FAA binnen 48 Stunden waren hausgemacht, kein Angriff – und zeigen, wie verwundbar vernetzte Geschäftsprozesse sind.
- Risiko steigt, Kosten auch: Schwerwiegende Cloud-Ausfälle nahmen 2022 bis 2024 um 52 Prozent zu; der Microsoft-Ausfall könnte allein rund 7 Milliarden US-Dollar Produktivität kosten.
- Drei Treiber: Anbieterkonzentration, schnelle Änderungen an komplexen Systemen sowie KI-Agenten als neue Last und neues Risiko.
- Backups gehören woandershin: Daten, Backups und Wiederherstellungspfad dürfen nicht beim selben Anbieter liegen; Container, Infrastructure as Code und entkoppelte Daten machen Multi-Cloud-Resilienz für kritische Services erreichbar.
- Handlungsauftrag für CISOs und Vorstände: Abhängigkeiten der zehn wichtigsten Services kartieren, Wiederherstellung unangekündigt testen und KI-Agenten wie Produktionssysteme behandeln.
Microsoft-Ausfall November 2026: Letzte Woche war die Generalprobe
Ausfälle sind Alltag. ThousandEyes verzeichnete Anfang 2026 weltweit 200 bis 400 Netzwerkausfälle pro Woche, ohne dass jemand sie bemerkte. Alltägliche Ausfälle scheinen zwar seltener zu werden: Das Uptime Institute weist seit fünf Jahren in Folge sinkende Ausfallraten pro Standort aus. Die großen folgenschweren Ausfälle werden dagegen häufiger.
Kritische Ausfälle bei den drei größten Cloud-Anbietern stiegen zwischen 2022 und 2024 um 52 Prozent, die Zahl der verlorenen Stunden nahm um 51 Prozent auf 221 pro Jahr zu. Zwar war 2025 stabiler, 2026 aber mit drei Microsoft-365-Ausfällen, einem landesweiten Groundstop bei noch sechs Wochen Jahresrestzeit dagegen alles andere als beruhigend.
Nichtverfügbarkeit wird zudem teuer. Ein schlechter Tag kostete früher Millionen. Das fehlerhafte Update von CrowdStrike im Juli 2024 kostete die Fortune 500 schätzungsweise 5,4 Milliarden US-Dollar. Über die Global 2000 hinweg beziffern Splunk und Oxford Economics die jährlichen Kosten von Ausfallzeiten 2024 auf 400 Milliarden US-Dollar, rund 9 Prozent der Gewinne. Der Microsoft-Ausfall von Freitag, dem 13.11.2026, könnte allein an verlorener Produktivität sieben Milliarden US-Dollar kosten. Versicherungen übernehmen nur einen Bruchteil der Schäden. Nach dem CrowdStrike-Vorfall deckten die Policen schätzungsweise 10 – 20 Prozent der Verluste der Fortune 500.
Folgenschwere Ausfälle werden immer häufiger. Dafür gibt es drei Gründe:
- Anbieterkonzentration: AWS, Microsoft und Google halten 61 Prozent des Cloud-Marktes mit einem Gesamtvolumen von 168 Milliarden US-Dollar pro Quartal. Drittanbieter sind für rund zwei Drittel der öffentlich gemeldeten Ausfälle der vergangenen neun Jahre verantwortlich. Ausfälle eines Anbieters ziehen auch andere Anbieter in Mitleidenschaft.
- Hohes Änderungstempo: Die Ausfälle begannen mit absichtlichen Änderungen: ein Netzwerk-Upgrade bei Microsoft, neue Ausrüstung bei der FAA. Laut Uptime Institute sind Fehler bei Konfiguration und Change-Management die häufigste Ursache. Die IT verändert komplexe Systeme schneller, Effekte von Änderungen sind schwerer zu verstehen.
- KI als neues Risiko: Die Cloud-Ausgaben stiegen im vergangenen Quartal um 55 Prozent und KI macht inzwischen etwa ein Drittel davon aus. Ein Ergebnis ist mehr Last auf derselben gemeinsam genutzten Infrastruktur. Zudem handelt es sich um eine neue Art von Workload: Agenten, die in eigener Verantwortung auf Produktivsysteme zugreifen. Gartner erwartet, dass fehlkonfigurierte KI in cyberphysischen Systemen bis 2028 die nationale kritische Infrastruktur in einem G20-Land lahmlegt.
Professionelle Cyberkriminelle, die kritische Infrastruktur angreifen, haben gerade beobachtet, wie weit sich ein einzelner Ausfall ausbreiten kann. Die Verteidigung ist in beiden Fällen dieselbe: Eine Architektur, die sich von einem fehlerhaften Update erholen kann, muss sich auch von einem Angriff erholen können.
Daten für die Ausfallsicherheit verteilen
Darüber hinaus zeigen die Beispiele, wie wichtig es ist, Backups zu diversifizieren. IT-Teams müssen sich jetzt folgende Frage stellen: Wenn die primäre Cloud ausfällt: Woraus stellen wir wieder her, und wohin? Für viele Unternehmen lautet die ehrliche Antwort: „In dieselbe Cloud“. Daten, Backups und der Wiederherstellungspfad liegen alle bei einem einzigen Anbieter. Wenn dieser Anbieter ausfällt, bleibt nichts anderes übrig als zu warten.
Wichtig sind daher Cloud-Lösungen, die so gebaut sind, dass es immer einen anderen Ort gibt, aus dem sich wiederherstellen lässt, und einen anderen, wohin sich wiederherstellen lässt: über Clouds hinweg, von On-Premises in die Cloud und von der Cloud zurück zu On-Premises.
Sicherheit durch Verteilung hat aber auch Nachteile: Jede zusätzliche Kopie kostet Geld, jede zusätzliche Umgebung erhöht die Komplexität. Die meisten Unternehmen, die sich als Multi-Cloud bezeichneten, betrieben in Wirklichkeit unterschiedliche Workloads in unterschiedlichen Clouds und echte Portabilität war selten und teuer. Das mag früher der richtige Ansatz gewesen sein.
Mittlerweile haben sich aber die Grundlagen verschoben. Workloads, die auf Containern und Kubernetes basieren, deren Infrastruktur als Code definiert ist und deren Daten von der darunterliegenden Plattform entkoppelt sind, lassen sich in einer zweiten Cloud oder in einem Rechenzentrum hochfahren, ohne neu gebaut zu werden. Nicht jeder Workload ist diesen Aufwand wert. Aber für die Handvoll Services, ohne die ein Unternehmen nicht arbeiten kann, ist Multi-Cloud-Resilienz heute besser erreichbar als je zuvor. Angesichts der aktuellen Ausfallereignisse lassen sich Folgekosten leichter als Argumente für diversifizierte Backups in Stellung bringen.
Drei Hausaufgaben für CISOs und Vorstände
Die neuen Ausfälle bringen die Notwendigkeit einer Inventur der IT-Infrastruktur auf die Agenda. Spätestens jetzt sollten sich alle wieder Gedanken machen, wo ihre kritischen Daten liegen und ob sie geschützt und gesichert sind. Die Transparenz aller Assets schafft dabei eine Grundlage für folgende Aufgaben:
- Herausfinden, was gemeinsam ausfällt: Unternehmen sollten ihre zehn wichtigsten Geschäftsservices definieren und für jeden die Abhängigkeiten von der Cloud bis hin zum Anbieter des jeweiligen Identitätsmanagements verfolgen, von denen er abhängt. Liegen Backups und dadurch geschützte Systeme in derselben Cloud? Lassen sich die Backups an einer anderen Stelle, einer anderen Cloud wiederherstellen? Entscheider müssen wissen, welcher Anbieterausfall was wie lange lahmlegt.
- Die Wiederherstellungszeit im echten Test messen: IT-Teams sollten festlegen, welche Services nach einem Tag wieder laufen müssen und welche Kosten jede Stunde Ausfall verursacht. Dann sollten sie unangekündigt einmal pro Quartal im Ernstfall – und nicht als geplante Übung – einen Anbieter ausfallen lassen und die Mean Time to Clean Recovery messen.
- KI-Agenten wie Produktionssysteme behandeln: KI ist mittlerweile für alle Firmen ein zentrales Asset. Unternehmen sollten daher auch ihre Agenten kennen. Sie müssen wissen, auf welche Daten sie zugreifen und was sie ändern können. Teams sollten mit einem Audit-Trail die Möglichkeit einfordern, sowohl den Agenten als auch alles, was er angefasst hat, zurückzurollen. Ohne Transparenz und die Möglichkeit des Zurückspulens darf ein Agent keine großen Aufgaben haben.
Vor dem nächsten Mal
Die Ereignisse der letzten Woche waren eine Generalprobe. Niemand wollte der IT bewusst schaden, und trotzdem haben die beiden Vorfälle Schäden in Milliardenhöhe verursacht. Beim nächsten Mal versucht es vielleicht jemand absichtlich, oder ein KI-Agent nimmt Änderungen vor. Unternehmen sollten sich darauf vorbereiten und jetzt ein Konzept für kontinuierliche Wiederherstellung einrichten.

foto (c) commvault
Pranay Ahlawat, Chief Technology and AI Officer bei Commvault
Tipps für die Praxis
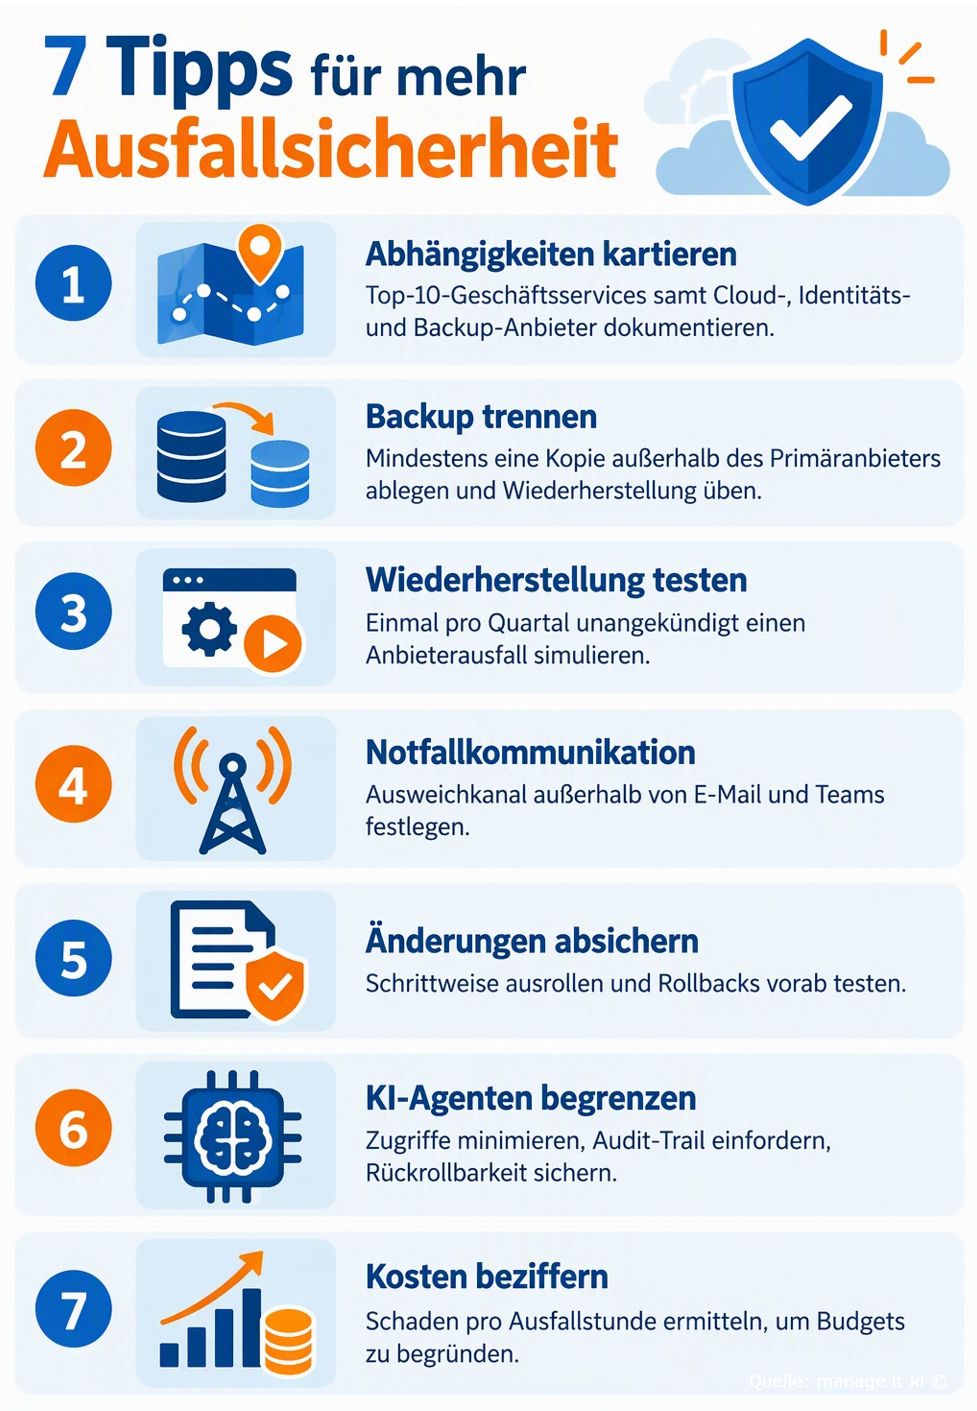
Notfallplan bei Cloud-Ausfällen: Maßnahmen im Überblick
|
Maßnahme |
Verantwortlich |
Frist |
|
Top-10-Geschäftsservices und deren Abhängigkeiten dokumentieren |
CIO / IT-Architektur |
30 Tage |
|
Backup-Kopie außerhalb des Primäranbieters einrichten |
Leiter Infrastruktur / Backup |
90 Tage |
|
Ausweichkanal für Krisenkommunikation festlegen |
CISO / Krisenstab |
30 Tage |
|
Wiederherstellungsziele (RTO/RPO) und Ausfallkosten pro Stunde festlegen |
CIO / CFO |
60 Tage |
|
Unangekündigten Wiederherstellungstest durchführen und Recovery-Zeit messen |
Leiter Betrieb / CISO |
Quartalsweise |
|
Zugriffe und Rückrollbarkeit von KI-Agenten prüfen |
CISO / KI-Verantwortlicher |
90 Tage |
|
Notfallplan prüfen und dem Vorstand berichten |
CISO |
Halbjährlich |
Die Verantwortlichen und Fristen sind Vorschläge und an die eigene Organisation anzupassen.
Ausführliche Tipps mit Praxisbeispielen
Beispiele mit Quellenangabe stammen aus den Vorfällen im November 2026, als fiktiv gekennzeichnete Beispiele dienen nur der Veranschaulichung.
1. Abhängigkeiten kartieren
Erfassen Sie für die zehn wichtigsten Geschäftsservices jede Abhängigkeit: Cloud-Anbieter, Identitätsmanagement, Netzwerk, Backup-Ziel und Drittdienste. Legen Sie fest, wer die Karte pflegt, und aktualisieren Sie sie bei jeder größeren Änderung.
Praxisbeispiel: Am 12. November 2026 fielen Exchange Online und mehrere Dienste aus, die darauf zugreifen, darunter Teams-Kalender, Copilot und Defender. [1][2] Wer vorher wusste, welche Prozesse an Exchange hängen, konnte schneller entscheiden, welche Abläufe auf Ausweichwege umgestellt werden müssen.
2. Backup trennen
Bewahren Sie mindestens eine Kopie kritischer Daten außerhalb des Primäranbieters auf, in einer zweiten Cloud oder On-Premises. Prüfen Sie, dass Sie die Wiederherstellung auch ohne Zugriff auf den Primäranbieter starten können, zum Beispiel mit separaten Zugangsdaten.
Praxisbeispiel (fiktiv): Ein Mittelständler sichert seine Microsoft-365-Postfächer zusätzlich täglich in ein Rechenzentrum. Fällt der Cloud-Dienst aus, bleiben die Mails lesbar, und der Vertrieb kann Angebote über eine Notfall-Mailbox versenden.
3. Wiederherstellung unangekündigt testen
Simulieren Sie einmal pro Quartal den Ausfall eines Anbieters im Ernstfall und nicht als geplante Übung. Messen Sie die Zeit bis zur sauberen Wiederherstellung (Mean Time to Clean Recovery) und halten Sie Abweichungen vom Plan fest.
Praxisbeispiel: Bei Workday war ein Backup-Test die Ursache einer Störung, weil die Sicherungsumgebung während des Tests mit produktiven Datenbanken verbunden war. [4] Tests brauchen daher klare Abgrenzung zur Produktion, einen Abbruchplan und eine Freigabe durch den Betrieb.
4. Notfallkommunikation vorhalten
Definieren Sie einen Kommunikationskanal, der nicht vom selben Anbieter abhängt wie Ihre Alltagswerkzeuge. Hinterlegen Sie Kontaktlisten offline und üben Sie die Alarmierung des Krisenstabs.
Praxisbeispiel: Als Exchange Online weltweit ausfiel, standen Outlook und Teams-Kalender nicht zur Verfügung. [1][2] Ein Krisenstab, der nur per E-Mail erreichbar ist, wäre in dieser Lage handlungsunfähig gewesen. Eine SMS-Alarmkette oder ein zweiter Messenger schließt diese Lücke.
5. Änderungen absichern
Rollen Sie Änderungen schrittweise aus, testen Sie Rollbacks vorab und prüfen Sie, ob Wartungsarbeiten gleichzeitig Kapazität reduzieren. Legen Sie Änderungsfenster fest und pausieren Sie Deployments bei Störungen.
Praxisbeispiel: Bei Microsoft trafen ein im Juli eingeführter Fehler, zusätzlicher Teams-Verkehr und rund 14 Prozent wegen Wartung fehlende Gateway-Kapazität zusammen. [1][6] Beim FAA-Groundstop war ein Router während eines Netzwerk-Upgrades der Auslöser. [4] Beide Fälle zeigen, dass die Kombination mehrerer Änderungen das Risiko erhöht.
6. KI-Agenten wie Produktionssysteme behandeln
Führen Sie ein Inventar aller Agenten mit Datenzugriffen und Schreibrechten. Vergeben Sie nur minimale Rechte, protokollieren Sie jede Aktion in einem Audit-Trail und stellen Sie sicher, dass Änderungen eines Agenten zurückgerollt werden können.
Praxisbeispiel (fiktiv): Ein Agent bereinigt automatisch Kundendatensätze. Weil er nur auf eine Testkopie schreiben darf und jede Änderung protokolliert wird, lässt sich ein fehlerhafter Lauf innerhalb weniger Minuten zurücknehmen.
7. Kosten beziffern
Ermitteln Sie pro Service die Kosten je Ausfallstunde, getrennt nach entgangenem Umsatz, Produktivitätsverlust und Folgekosten. Nutzen Sie die Werte, um Budgets für Backup-Diversifizierung und Übungen gegenüber der Geschäftsleitung zu begründen.
Praxisbeispiel: Die Anderson Economic Group schätzt den Produktivitätsverlust des Microsoft-Ausfalls auf etwa 7 Milliarden US-Dollar. [1] Ein Unternehmen mit 2.000 Beschäftigten kann analog den Verlust pro Stunde aus Personalkosten und betroffenen Prozessen herleiten (fiktives Rechenbeispiel, Werte anpassen).
FAQ: Zehn Fragen zum Ausfall
- Was ist am 12./13. November 2026 bei Microsoft 365 passiert?
Exchange Online war weltweit nicht erreichbar, betroffen waren auch Teams-Kalender, Copilot, SharePoint und Defender. Microsoft verfolgte den Vorfall unter EX1550543 und MO1550821. [1][2]
- Wie lange dauerte der Ausfall?
Laut Microsofts vorläufigem Bericht dauerte er von 12. November 10:05 UTC bis 13. November 16:10 UTC, vollständig wiederhergestellt war er bis zum Morgen des 14. November. [1][2]
- Was war die technische Ursache?
Drei Faktoren trafen zusammen: ein im Juli eingeführter Fehler in Gateway-Servern, mehr Last durch verlagerten Teams-Verkehr und rund 14 Prozent Kapazität, die wegen Wartung fehlten. Die Server fielen kaskadenartig aus. [1][6]
- War es ein Cyberangriff?
Nein. Microsoft nannte weder einen Angriff noch KI-Agenten als Ursache, sondern einen Infrastruktur- und Softwarefehler. [1][2]
- Warum dauerte die Wiederherstellung so lange?
Zurückgeholte Server wurden vom aufgestauten Verkehr sofort wieder überlastet, und der auslösende Fehler stammte aus dem Juli, sodass automatische Rollbacks nicht griffen. [1][6]
- Wie hoch sind die wirtschaftlichen Schäden?
Die Anderson Economic Group schätzt den Produktivitätsverlust auf etwa 7 Milliarden US-Dollar. Es handelt sich um eine Schätzung. [1]
- Gab es weitere Ausfälle in derselben Woche?
Ja, unter anderem Workday, der landesweite FAA-Groundstop, AWS us-east-1, Chase und United Airlines. Die Unternehmen nannten jeweils unterschiedliche Ursachen. [4]
- Werden Ausfälle insgesamt häufiger?
Laut Uptime Institute sinkt die Ausfallrate pro Standort im fünften Jahr in Folge, das Tempo der Verbesserung nimmt aber ab. Externe Infrastrukturfehler werden bei öffentlich gemeldeten Ausfällen wichtiger. [3]
- Welche Rolle spielen Drittanbieter?
Cloud-, Internet-, Telekommunikations- und Colocation-Anbieter machen laut Uptime Institute über neun Jahre etwa zwei Drittel der öffentlich gemeldeten Ausfälle aus. [3]
- Was können Admins bei einem Microsoft-365-Ausfall konkret tun?
Den Service Health im Admin Center und die öffentliche Statusseite verfolgen, Anwender über einen Ausweichkanal informieren und keine hektischen Änderungen vornehmen, da die Postfachdaten nach bisherigem Kenntnisstand intakt waren. [5]
Quellen
[1] https://en.wikipedia.org/wiki/2026_Microsoft_outage
[2] https://www.recoveryfix.com/blog/microsoft-365-outage-cyberattack-november-2026/
[3] https://uptimeinstitute.com/about-ui/press-releases/uptime-announces-annual-outage-analysis-report-2026
[4] https://applescoop.org/story/every-major-outage-november-2026-timeline-faa-microsoft-chase-united
[5] https://www.der-windows-papst.de/2026/11/13/microsoft-365-stoerung-november-2026-verlauf-ursache-und-was-admins-tun-sollten/
[6] https://lycoristechnologies.com/blog/microsoft-365-outage-november-2026/
Management Summary, Tipps, FAQ und Bilder wurden mit Hilfe von KI erstellt
Übersichten:
Übersicht 1: Große Ausfälle und Groundstops seit Juli 2024.
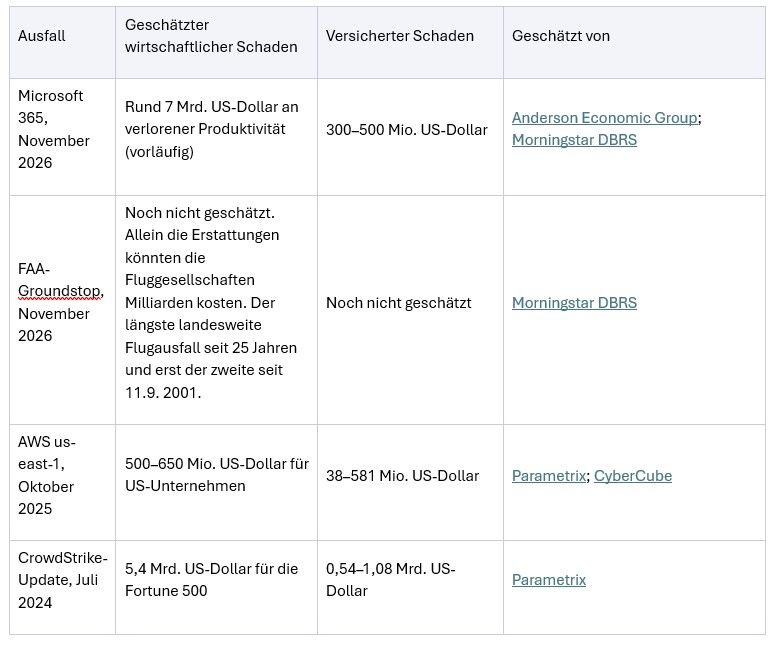
Quellen zum Übersichtsdiagramm:
Anderson Economic Group: https://edition.cnn.com/2026/11/12/business/live-news/microsoft-global-outage-intl-hnk.
Morningstar DBRS: https://www.newsdrum.in/business/microsoft-services-back-after-38-hour-outage-7-billion-productivity-hit-estimated-12809623.
Parametrix: https://www.parametrixinsurance.com/reports-white-papers/aws-us-east-1-outage—what-parametrix-monitored-in-real-time.
CyberCube: https://riskandinsurance.com/aws-outage-loss-estimates-range-from-38m-to-581m-as-cyber-insurers-face-moderate-impact/
Übersicht 2: Diversifizierung tut not.
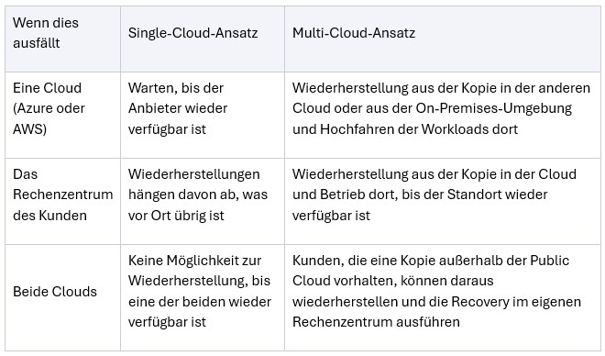
Bildquelle Abbildungen: Commvault.
1014 Artikel zu „Notfall Plan“
Business Process Management | IT-Security | News | Services | Strategien | Trends 2026 | Trends Security
Resilient gegen Cyberangriffe: Deutsche Wirtschaft setzt auf Notfallpläne

Repräsentative Studie zeigt positive Entwicklung und gleichzeitig organisatorische Lücken. Notfallpläne sind in der deutschen Unternehmenslandschaft etabliert: 97 Prozent der Firmen setzen auf einen elementaren Fahrplan für den Fall eines erfolgreichen Cyberangriffs. Das ist ein Ergebnis der repräsentativen Studie »Cybersicherheit in Zahlen« von G DATA CyberDefense, Statista und brand eins [1]. Die Hälfte der befragten…
IT-Security | News | Services | Tipps
Wenn der Notfallplan versagt: Was Unternehmen bei Cyberattacken besser machen müssen

Management Summary Cyberangriffe bleiben ein geschäftskritisches Risiko: Unternehmen müssen Incident Response, Business Continuity und Disaster Recovery als integrierte Management-Aufgabe verstehen. Die größten Schwachstellen liegen weniger in einzelnen Technologien als in fehlenden Notfallplänen, unklaren Zuständigkeiten, mangelnder Übung und unvollständiger Dokumentation. Regelmäßige Tests inklusive Backup- und Recovery-Prozessen sind entscheidend, um im Ernstfall schnell, koordiniert und mit…
Business | IT-Security | News | Trends 2026 | Trends Security | Trends Wirtschaft
Notfallpläne für den Kriegsfall
Für eine wirksame Abschreckung gegenüber Russland muss auch die Wirtschaft eingebunden sein. Doch bislang sind nur wenige auf Ausfälle der Infrastruktur oder der Lieferketten vorbereitet, wie eine Studie des Instituts der deutschen Wirtschaft (IW) zeigt. Anders sieht es bei Cybergefahren aus. Viele Unternehmen in Deutschland sind nur bedingt auf einen möglichen Kriegsfall vorbereitet. Wie eine…
Business | Favoriten der Redaktion | Geschäftsprozesse | IT-Security | News | Strategien | Trends Security | Trends Wirtschaft
Unternehmen haben keine konkreten Notfallpläne für Krisen in der Schublade

Nur rund die Hälfte von 600 weltweit befragten Unternehmen verfügt über einen Notfallplan im Falle einer Cyberattacke (56 Prozent), eines Lieferkettenausfalls (58 Prozent) oder des Angriffs eines aktivistischen Investors (54 Prozent). Es gibt erkennbare Unterschiede zwischen nordamerikanischen und europäischen Unternehmen – besonders Unternehmen in Europa sowie weiteren Ländern im Nahen und Mittleren Osten und in…
Ausgabe 5-6-2020 | Business | Digitalisierung | News | Strategien
Corona infiziert Weltwirtschaft – Digitalisierung als Impfstoff: Digitaler Notfallplan

In Krisenzeiten ist die Einrichtung eines Notfallplans die Strategie der Stunde. Hierbei spielt die IT eine wichtige Rolle. Innovation und Digitalisierung sind es, die Unternehmen handlungsfähig halten.
Business | Favoriten der Redaktion | IT-Security | News | Trends 2019 | Trends Security | Trends Wirtschaft
Cyberresilienz: Erhebliche Defizite bei der Notfallplanung

Mehr als die Hälfte der deutschen Unternehmen testen ihre Notfallpläne nicht. Automatisierung verbessert die Erkennung und Eindämmung von Cyberangriffen in Deutschland um 46 Prozent. Die Ergebnisse der vierten, jährlichen Benchmark-Studie zur Cyberresilienz, vom Ponemon Institute durchgeführt und von IBM Resilient gesponsert, sind veröffentlicht worden. In »The 2019 Cyber Resilient Organization« wird untersucht, inwieweit Unternehmen…
IT-Security | News | Trends 2019 | Trends Security
IT-Security-Studie 2019: Immer mehr Unternehmen planen für den IT-Notfall

90 Prozent der Unternehmen empfinden die Bedrohungslage als wachsend und stellen sich mit Notfallplänen darauf ein. Die Bedrohungslage im Bereich IT-Sicherheit steigt weiter an. Dies sagen 90 Prozent der befragten Sicherheitsexperten laut der Studie IT-Sicherheit 2019 [1] des eco – Verbands der Internetwirtschaft e. V. Die Unternehmen in Deutschland reagieren darauf mit Notfallplänen. 57 Prozent…
IT-Security | News | Strategien | Trends 2017 | Trends Security
Unternehmen fehlt Notfallplan nach Hackerangriffen

Studie: Firmen registrieren Zunahme von Angriffen mit Phishing-E-Mails, Fake-Identitäten und Ransomware. Nur 19 Prozent der Unternehmen besitzen eine Cyber-Resilience-Strategie zum Management von Cyberattacken. Unternehmen in Deutschland sind auf Angriffe von Hackern nicht ausreichend vorbereitet. Lediglich 19 Prozent der Firmen besitzen eine Cyber-Resilience-Strategie und damit einen Notfallplan, wie sie nach Attacken auf ihre IT-Systeme handlungsfähig bleiben…
Business | Effizienz | IT-Security | News | Rechenzentrum | Services | Trends 2017 | Trends Security | Trends Services
Notfallplanung spart Unternehmen Zeit und Geld

Weltweite Studie zeigt: Betriebliches Kontinuitätsmanagement (BCM) senkt die Kosten pro Datenpanne um bis zu 600.000 US-Dollar. Unternehmen, die betriebliches Kontinuitätsmanagement (BCM) betreiben, handeln bei Datenpannen schneller und sparen somit Zeit und Geld. Das hat eine globale Studie des Ponemon Instituts in Zusammenarbeit mit IBM ergeben [1]. So entdecken diese Unternehmen Datenpannen früher und zahlen im…
Cloud Computing | Infrastruktur | IT-Security | News | Rechenzentrum | Strategien | Tipps
Notfallplan für die Wiederherstellung: Oftmals vernachlässigt – bis zur Katastrophe

Vier Möglichkeiten, um einen »desaströsen« Disaster-Recovery-Plan zu vermeiden. Eine Katastrophe kann jedem Unternehmen jederzeit passieren. Murphys Gesetz geht sogar so weit, dass Katastrophen meistens zu den ungünstigen Zeiten auftreten, doch unabhängig davon: Um die Geschäftskontinuität angesichts potenzieller Risiken zu gewährleisten, ist es wichtig, einen umfassenden und konsistenten Plan für Disaster Recovery (DR), also Notfall-Wiederherstellung, vorzuhalten.…
Geschäftsprozesse | IT-Security | Kommunikation | News | Services | Strategien | Tipps
Plan B für die Kommunikation: Wie Organisationen den Ausfall von Outlook & Teams überbrücken

Wenn Outlook und Teams gleichzeitig stillstehen, zeigt sich, wie abhängig Behörden und Unternehmen von einem einzigen Anbieter sind. Wer jetzt zu privaten Messengern greift, riskiert Datenabfluss und Kontrollverlust. Der Beitrag erläutert, wie sich Abhängigkeiten erfassen, Prioritäten setzen, abgestufte Fallback-Pläne definieren und Ausweichplattformen so testen lassen, dass die Kommunikation auch im Ernstfall sicher weiterläuft. Management Summary…
Business | Effizienz | IT-Security | Kommentar | News | Services | Tipps
Cyberresilienz statt Krisenmodus: Warum Ausfallplanung zur Chefsache wird
Vernetzte Produktion, intelligente Energieversorgung und digitale Gesundheitsdienste erhöhen die Abhängigkeit von IoT- und OT-Systemen. Damit rückt eine Managementfrage in den Mittelpunkt: Wie bleibt das Unternehmen handlungsfähig, wenn ein Angriff Geräte, Netze oder Lieferketten trifft? Entscheidend sind nicht nur technische Schutzmaßnahmen, sondern klare Zuständigkeiten, belastbare Wiederanlaufpläne, geübte Meldewege und Sicherheit über den gesamten Produktlebenszyklus. Management Summary…
IT-Security | News | Trends 2026 | Trends Security
95 % der Sicherheitsteams entdecken schwerwiegende oder kritische Schwachstellen außerhalb geplanter Tests
Ganze 79 % ergreifen keine Maßnahmen aufgrund KI-generierter Ergebnisse ohne menschliche Validierung. Nur 15 % bezeichnen ihre Programme für Sicherheitstests und -validierung als kontinuierlich. Synack, Anbieter des ersten KI-gestützten, kontinuierlichen Penetrationstests für Unternehmen, hat die Studie »The State of Continuous Security Validation« veröffentlicht [1]. Sie basiert auf einer Befragung von Führungskräften und Fachleuten im…
Infrastruktur | News | Services | Tipps
Datensicherung bei Geschäftsumzügen planen

Bei Geschäftsumzügen steht die IT-Infrastruktur vor besonderen Herausforderungen. Während Möbel und Akten relativ unkompliziert transportiert werden können, erfordert die Sicherung sensibler Unternehmensdaten eine sorgfältige Planung. Besonders kleine und mittelständische Unternehmen unterschätzen häufig die Risiken, die ein Standortwechsel für ihre Datenbestände mit sich bringt. Die temporäre Auslagerung von Servern und Speichermedien während eines Umzugs stellt…
IT-Security | Kommunikation | News | Tipps
Wenn Bits zu Bomben werden: Von Notfall-Website bis Flipchart
Cyberangriff auf ein Schweizer Unternehmen – ein Krisenmanagementbericht. Wenn Bits zu Bomben werden, muss die IT-Welt einige Aspekte und Faktoren neu denken. In einer Zeit, in der Cyberangriffe längst keine Ausnahme mehr sind, sondern zur Realität digital vernetzter Unternehmen gehören, rückt eine oft unterschätzte Kompetenz in den Vordergrund: Kommunikation. Während Firewalls und Notfallpläne auf technischer…
IT-Security | News | Whitepaper
Warum IT-Teams eine digitale Notfalltasche brauchen

Beim Notfall-Einsatz zählt jede Sekunde. Ersthelfer suchen dann nicht erst ihre Ausrüstung zusammen, sondern haben bereits alles in ihrer Notfalltasche, um sofort loszulegen. Gleiches gilt heute für IT-Security-Teams. Denn inzwischen ist der Angriffsfall nur noch eine Frage der Zeit. Dann müssen sie alles Notwendige in einer digitalen Notfalltasche haben, damit sie die Attacke möglichst schnell…
Business Process Management | Geschäftsprozesse | IT-Security | News | Tipps
Checkliste für den Business Continuity Plan

Angesichts der steigenden Cyberrisiken und dem zunehmenden Einsatz von KI bei Attacken, sollte die Gewährleistung der Geschäftskontinuität für jeden IT-Experten in Unternehmen Priorität haben. Eine unabhängige globale Forschungsstudie von Arcserve zeigt, dass 80 Prozent der befragten Unternehmen von Ransomware betroffen sind und dass sich fast jeder Dritte (30 Prozent) nach einem erfolgreichen Ransomware-Angriff nicht erholen…
Cloud Computing | Digitalisierung | Favoriten der Redaktion | Industrie 4.0 | Lösungen | News | Rechenzentrum
Bosch migriert Lösung zur Produktionsplanung auf eine resiliente und effiziente Anwendungsplattform

Bosch hat seine Softwarelösung ProCon für die Produktionsplanung, die von 90 Werken genutzt wird, erfolgreich auf die Bosch Private Cloud migriert, die auf der Technologie von Red Hat basiert. Die Umstellung erfolgte nahtlos in einem einjährigen Migrationsprojekt und führte zu einer gesteigerten betrieblichen Effizienz sowie zu erheblichen Verbesserungen bei der Skalierbarkeit und Ausfallsicherheit. Zudem wurden…
Ausgabe 7-8-2024 | IT-Security | News | Security Spezial 7-8-2024
In zehn Schritten zur Business Continuity – Checkliste für ein belastbares Notfallmanagement

Die Einführung eines Business Continuity Management (BCM) ist komplex und zeitaufwendig. Der BSI-Standard 200-4 dient als Hilfestellung, um zielgerichtet und effektiv vorzugehen. Wichtig ist, vorhandene Datenbestände geschickt zu nutzen und bei der Toolauswahl die richtigen Schwerpunkte zu setzen, um in kurzer Zeit ein Notfallmanagement zu etablieren.
News | Services | Strategien
Notfall- und Krisenmanagement mit digitalen Tools: Die Handlungszeit verkürzen
Krisen und Notfälle gefährden Unternehmen und ihren Bestand und machen gerade in Zeiten, in denen sich Informationen digital rasend schnell verbreiten, eine hohe Reaktionsfähigkeit notwendig. Unternehmen müssen ihr Notfall- und Krisenmanagement deswegen digitalisieren. Dies geht weit über das Installieren eines Tools hinaus: Erfahrene Berater stellen sicher, dass nicht nur Tools implementiert werden, sondern dass der…