Illustration Absmeier foto ki designer
Technisch korrekte Daten sind noch keine verlässliche Entscheidungsgrundlage. Erst wenn Definitionen, Kontext und konkrete Geschäftsfragen zusammengeführt werden, entstehen Informationen, die Führungskräfte, Prozesse und KI-Anwendungen tatsächlich nutzen können. Unternehmen müssen ihre Datenstrategie deshalb vom Anwendungsfall her denken – und Datenqualität nicht nur an Regeln, sondern an ihrer Wirkung messen.
Management Summary
- Technische Qualität ist nur die Basis: Genauigkeit, Vollständigkeit und Konsistenz machen Daten prüfbar, aber noch nicht automatisch geschäftlich nutzbar.
- Kontext entscheidet über den Wert: Einheitliche Begriffe, nachvollziehbare Zusammenhänge und klar definierte Anwendungsfälle übersetzen Daten in belastbare Entscheidungen.
- KI legt Schwächen offen: Fehlende Relevanz, unklare Definitionen und ungeeignete Datengrundlagen wirken direkt auf Zuverlässigkeit und Skalierbarkeit von KI-Anwendungen.
- Business und Datenteams tragen gemeinsam Verantwortung: Fachbereiche müssen Anforderungen, Qualitätsmaßstäbe und gewünschte Ergebnisse von Beginn an mitbestimmen.
- Wirkung wird zur Leitkennzahl: Datenqualität sollte zusätzlich daran gemessen werden, ob sie Entscheidungszeiten verkürzt, Risiken reduziert und nachweisbaren Geschäftsnutzen unterstützt.
Von technisch aufbereiteten zu geschäftstauglichen Daten: weshalb Genauigkeit allein nicht ausreicht
Viele Unternehmen verfügen über Daten, die technisch korrekt und qualitativ hochwertig sind und dennoch keine Antworten auf zentrale Geschäftsfragen liefern. Wie kommt es, dass Daten Audits bestehen, sämtliche technischen Anforderungen erfüllen und Führungskräfte trotzdem genau dann im Stich lassen, wenn belastbare Entscheidungen gefragt sind? Messen wir womöglich die falschen Dinge oder verwechseln wir technische Qualität mit tatsächlichem Geschäftsnutzen?
Ich habe mit zahlreichen Führungskräften gesprochen, die vor demselben Problem stehen: Unternehmen investieren massiv in Modernisierung, KI, Analytics und neue Plattformen in der Hoffnung, dass sich mit der Behebung ihrer Datenprobleme zugleich viele ihrer geschäftlichen Herausforderungen lösen lassen. Entsprechend hoch sind die Erwartungen. Doch nach der Investition bleiben die Ergebnisse häufig hinter diesen Erwartungen zurück. Der Grund: Die Daten sind technisch zwar verfügbar und aufbereitet, aber nicht konsequent an den tatsächlichen Arbeitsweisen, Entscheidungsprozessen und Anforderungen des Unternehmens ausgerichtet.
Die entscheidende Frage lautet: Wenn unsere Daten tatsächlich gut sind, weshalb treffen wir dann nicht automatisch bessere und schnellere Entscheidungen?
Der Grund liegt häufig tiefer. Teams verbringen wertvolle Zeit damit, über Zahlen und deren Bedeutung zu diskutieren, weil Definitionen nicht einheitlich sind und entscheidender Kontext fehlt. Reichen die verfügbaren Erkenntnisse für eine belastbare Entscheidung nicht aus, verlassen sich Führungskräfte am Ende eher auf Erfahrung und Bauchgefühl als auf tatsächliche Daten. Die Folge: KI-Initiativen geraten ins Stocken, bevor sie ihren Mehrwert entfalten können.
Hier zeigt sich, dass technisch aufbereitete Daten nicht automatisch geschäftstaugliche Daten sind. Doch genau diese Gleichsetzung führt in vielen Unternehmen zu falschen Erwartungen und letztlich zu Entscheidungen, die hinter ihren Möglichkeiten zurückbleiben.

Illustration Absmeier infografik ki magnific designer
Die Illusion »sauberer« Daten
Im vergangenen Jahrzehnt haben Unternehmen massiv in Datenqualität, Data Governance, Master Data und Cloud-Migrationen investiert. Diese Maßnahmen sind wichtig und bilden eine wesentliche Grundlage für den professionellen Umgang mit Daten. Sie lösen jedoch nicht automatisch ein grundlegendes Problem: technisch hochwertige Daten sind nicht zwangsläufig geschäftlich nutzbare Daten.
Ein Datensatz kann korrekt, standardisiert, validiert und regelkonform sein und dennoch keine verlässliche Antwort auf zentrale Geschäftsfragen liefern. Das gilt etwa mit Blick auf Fragen zu Kunden, Risiken, Lieferketten, Profitabilität oder auch strategischen Investitionen.
Ein Beispiel aus dem Einzelhandel verdeutlicht dieses Problem: eine Bestellung kann erfolgreich in das ERP-System eines Unternehmens übernommen werden und sämtliche technischen Validierungen bestehen. Ist die zugehörige Artikelnummer jedoch nicht in den Stammdaten hinterlegt, kann das Unternehmen den Artikel später möglicherweise weder nachbestellen noch die benötigten Ersatzteile beschaffen. Die Daten sind zugänglich, sauber und technisch korrekt. Es fehlt jedoch der geschäftliche Kontext, der notwendig ist, um daraus verlässliche Entscheidungen und Prozesse abzuleiten.
Das ist der wesentliche Unterschied zwischen technisch aufbereiteten und geschäftstauglichen Daten: technische Genauigkeit schafft Vertrauen in den Datensatz. Geschäftstauglichkeit schafft Vertrauen in die Entscheidung.
Die Lücke zwischen Genauigkeit und Wirkung
Die Ursache des Problems liegt häufig bereits in der Konzeption der Datenstrategie von Unternehmen. Die meisten Datenpipelines werden mit den besten Absichten entwickelt, doch Datenmodelle orientieren sich vor allem an Systemen und nicht an den Entscheidungen, die auf Basis der Daten getroffen werden sollen. Pipelines werden auf die zuverlässige Aufnahme und Transformation von Daten optimiert, während sich Data Governance vor allem auf Kontrolle, Qualität und Standardisierung konzentriert. All das ist wichtig, greift jedoch zu kurz.
Fachanwender denken nicht in Datenstrukturen, sondern in Ergebnissen: Kunden verstehen, Risiken bewerten, Chancen priorisieren und Entscheidungen treffen. Wenn Daten nicht auf diese Anforderungen ausgerichtet sind, entsteht eine Lücke zwischen dem, was technisch korrekt ist, und dem, was im Geschäft tatsächlich Wirkung entfaltet. Und in dieser Lücke geht Wert verloren.
Wie KI das Problem sichtbar macht
KI macht die Qualität der Datengrundlage sichtbar wie kaum eine andere Technologie. Sie erzeugt nicht automatisch Mehrwert, nur weil Daten organisiert sind. Im Gegenteil: KI verstärkt, was in den Daten steckt, und macht damit auch fehlenden Kontext, Inkonsistenzen sowie Schwächen besonders deutlich.
Modelle schaffen nicht allein deshalb Mehrwert, weil Daten sauber, vollständig oder umfangreich sind. Sie benötigen einheitliche Definitionen und einen geschäftlichen Zusammenhang, der in den Daten verankert ist. Wird KI mit Daten trainiert, die zwar technisch korrekt, für das Geschäft aber wenig relevant sind, wird dadurch keine zusätzliche Klarheit geschaffen. Stattdessen können Verwirrung, Verzerrungen und irreführende Erkenntnisse entstehen. Besonders problematisch wird es, wenn daraus selbstbewusst formulierte Antworten hervorgehen, die plausibel klingen, aber in die falsche Richtung weisen.
Genau deshalb schaffen es viele KI-Initiativen nicht über die eigentliche Pilotphase hinaus. Begrenzende Faktoren sind dabei häufig weder die Modelle noch die Algorithmen. Es sind die Daten, oder genauer gesagt: das Fehlen geschäftstauglicher Daten.
Von Datenpipelines zu Entscheidungspipelines
Was muss sich also ändern? Ein neuen Ansatz ist erforderlich. Unternehmen müssen mehr von ihren Daten erwarten. Statt primär in Datenpipelines zu denken, sollten sie Entscheidungspipelines entwickeln: Prozesse, die aus Daten konsistente, vertrauenswürdige und unmittelbar nutzbare Erkenntnisse erzeugen und diese in großem Maßstab für insgesamt effektivere Entscheidungen bereitstellen.
Die entscheidenden Fragen lauten deshalb: Wie werden die Daten genutzt? Von wem? In welchem Zusammenhang?
Geschäftstaugliche Daten bilden ab, wie eine Organisation tatsächlich funktioniert. Sie machen sichtbar, wie sich Kunden verhalten, wie Prozesse ineinandergreifen, wo Risiken entstehen und an welchen Stellen Wert geschaffen (oder aber vernichtet) wird.
Datenmodelle sollten deshalb von realen Anwendungsfällen her gedacht werden: von den Fragen, die Teams beantworten müssen, und von den Entscheidungen und Maßnahmen, die sich daraus ableiten lassen. Dafür ist eine engere Zusammenarbeit zwischen Datenteams und Führungskräften aus dem Geschäftsbereich erforderlich, und zwar nicht als nachträgliche Ergänzung, sondern als Ausgangspunkt. Geschäftliche Anforderungen müssen von Anfang an bestimmen, welche Daten gebraucht werden, wie sie aufbereitet werden und welchen Zweck sie schlussendlich erfüllen sollen.
Daten tatsächlich geschäftstauglich machen
Über verschiedene Branchen und Anwendungsfälle hinweg haben sich aus meiner Sicht einige Prinzipien besonders bewährt. Der geschäftliche Kontext sollte von Anfang an in die Datenmodelle einfließen. Datenpipelines sollten sich an konkreten Entscheidungen und Arbeitsabläufen orientieren. Gleichzeitig ist eine enge Zusammenarbeit zwischen Business- und Datenteams erforderlich. Beide tragen gemeinsam die Verantwortung dafür, dass Daten in belastbare Erkenntnisse übersetzt werden und messbaren geschäftlichen Mehrwert schaffen.
Darüber hinaus ist es entscheidend, Daten kontinuierlich mit Blick auf ihre tatsächliche Wirkung zu bewerten, statt ihre Qualität ausschließlich daran zu bemessen, wie viele Validierungsregeln sie erfüllen. Damit verändert sich auch der Maßstab für Datenqualität: im Mittelpunkt stehen nicht mehr allein technische Kennzahlen, sondern der konkrete Beitrag zum Geschäft. Denn letztlich zählt nicht, wie sauber Daten verarbeitet werden, sondern was Unternehmen mit ihnen tatsächlich erreichen.
Geschäftstaugliche Daten als Wettbewerbsvorteil
Unternehmen erzeugen keinen Wettbewerbsvorteil allein dadurch, dass ihre Daten korrekt sind. Entscheidend ist, ob die Daten die tatsächliche Funktionsweise des Unternehmens abbilden und damit schnellere und fundiertere Entscheidungen ermöglichen.
In einer von KI geprägten Welt markiert der Unterschied zwischen technisch aufbereiteten und geschäftstauglichen Daten die Grenze zwischen Experiment und Umsetzung, zwischen Erkenntnis und konkretem, zielorientiertem Handeln. Saubere Daten stellen einen wichtigen Ausgangspunkt dar, aber sie sind nicht ausreichend. Erst geschäftstaugliche Daten schaffen die Grundlage für echten Mehrwert.
Unternehmen, die diesen Unterschied erkennen und ihre Daten konsequent an geschäftlichen Entscheidungen und Ergebnissen ausrichten, werden nicht nur insgesamt über bessere Daten verfügen. Sie werden auch bessere Entscheidungen treffen, schneller handeln und mit ihren Investitionen messbare Ergebnisse erzielen.
René Haag, VP MEE, Syniti, ein Unternehmen von Capgemini
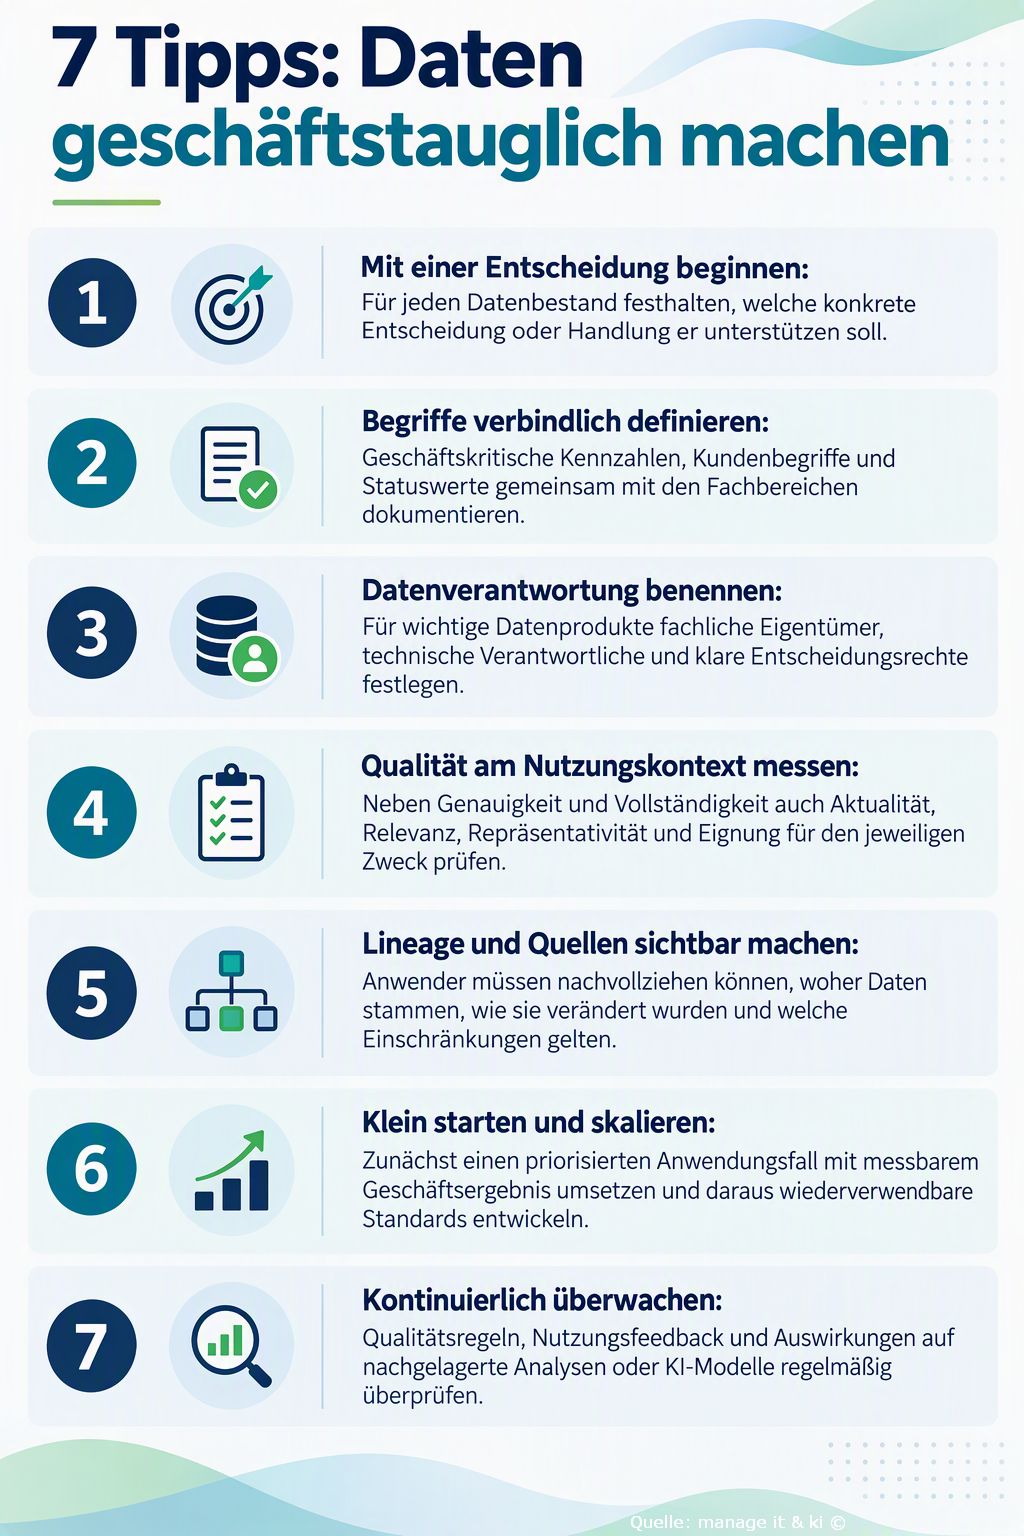
Illustration Absmeier ki designer
Tipps: Daten geschäftstauglich machen
- Mit einer Entscheidung beginnen: Ausgangspunkt sollte nicht der verfügbare Datenbestand, sondern eine konkrete geschäftliche Entscheidung sein. Unternehmen sollten zunächst festlegen, welche Frage beantwortet, welche Handlung ausgelöst und welches Ergebnis verbessert werden soll. Anschließend lässt sich bestimmen, welche Daten dafür tatsächlich erforderlich sind, wie aktuell und detailliert sie vorliegen müssen und welche Qualitätsmängel die Entscheidung beeinträchtigen würden. So werden unnötige Datenaufbereitung und technisch aufwendige Lösungen ohne klaren Geschäftsnutzen vermieden.
- Begriffe verbindlich definieren: Geschäftskritische Kennzahlen, Kundenbegriffe, Statuswerte und Berechnungslogiken sollten gemeinsam mit den Fachbereichen eindeutig beschrieben werden. Dabei ist festzuhalten, welche Datenquellen gelten, wie Kennzahlen berechnet werden, welche Ausnahmen zulässig sind und für welchen Zeitraum eine Definition verwendet wird. Ein zentral gepflegtes Geschäfts- und Datenvokabular reduziert Interpretationsspielräume und sorgt dafür, dass Berichte, Analysen und KI-Anwendungen dieselben Begriffe konsistent verwenden.
- Datenverantwortung benennen: Für wichtige Datenprodukte und geschäftskritische Datenelemente sollten fachliche Eigentümer, technische Verantwortliche und klare Entscheidungsrechte festgelegt werden. Der fachliche Eigentümer verantwortet Bedeutung, Nutzung und Qualitätsanforderungen; die technische Seite sorgt für Verfügbarkeit, Verarbeitung und Kontrollen. Ergänzend braucht es definierte Eskalationswege, Fristen für die Fehlerbehebung und transparente Zuständigkeiten, damit Qualitätsprobleme nicht zwischen Abteilungen liegen bleiben.
- Qualität am Nutzungskontext messen: Genauigkeit und Vollständigkeit allein reichen als Qualitätsmaßstab nicht aus. Abhängig vom Anwendungsfall sollten Unternehmen zusätzlich Aktualität, Relevanz, Repräsentativität, Granularität und Eignung für den vorgesehenen Zweck bewerten. Für einen operativen Prozess kann beispielsweise die zeitnahe Verfügbarkeit entscheidend sein, während bei einem KI-Modell ausgewogene und repräsentative Trainingsdaten im Mittelpunkt stehen. Qualitätsgrenzen sollten deshalb pro Anwendung definiert und mit messbaren Akzeptanzkriterien verknüpft werden.
- Lineage und Quellen sichtbar machen: Anwender müssen nachvollziehen können, aus welchen Systemen Daten stammen, wie sie transformiert wurden, welche Regeln angewendet wurden und welche Einschränkungen bestehen. Eine dokumentierte Data Lineage schafft Transparenz vom Ursprung bis zum Bericht, Datenprodukt oder KI-Modell. Ergänzende Metadaten zu Aktualisierungszeitpunkt, Verantwortlichkeit und Qualitätsstatus helfen, die Verlässlichkeit einer Information vor ihrer Nutzung einzuschätzen und Fehlerquellen schneller einzugrenzen.
- Klein starten und skalieren: Statt alle Datenbestände gleichzeitig zu bereinigen, sollten Unternehmen einen priorisierten Anwendungsfall mit klarem Geschäftswert auswählen. Geeignet sind Vorhaben, deren Ergebnis innerhalb eines überschaubaren Zeitraums messbar ist, etwa weniger manuelle Nacharbeit, schnellere Entscheidungen oder geringere Fehlerkosten. Die dabei entwickelten Definitionen, Rollen, Qualitätsregeln und technischen Bausteine sollten dokumentiert und anschließend als wiederverwendbare Standards auf weitere Bereiche übertragen werden.
- Kontinuierlich überwachen: Datenqualität ist kein einmaliges Bereinigungsprojekt, sondern eine dauerhafte Managementaufgabe. Qualitätsregeln sollten automatisiert überwacht, Abweichungen priorisiert und ihre Auswirkungen auf Geschäftsprozesse, Analysen und KI-Modelle regelmäßig bewertet werden. Nutzungsfeedback aus den Fachbereichen, Veränderungen an Quellsystemen und neue regulatorische oder geschäftliche Anforderungen müssen in die Kontrollen einfließen. Ein regelmäßiges Reporting mit wenigen aussagekräftigen Kennzahlen macht Fortschritte und Handlungsbedarf sichtbar.
FAQ: Geschäftstaugliche Daten
- Was unterscheidet technisch saubere von geschäftstauglichen Daten?
Technisch saubere Daten erfüllen formale Qualitätskriterien wie Genauigkeit, Vollständigkeit, Konsistenz, Aktualität, Gültigkeit und Eindeutigkeit. Geschäftstauglich sind sie erst, wenn sie zusätzlich für einen klaren Anwendungsfall relevant, verständlich und entscheidungsfähig sind. [1]
- Warum genügt hohe Genauigkeit allein nicht?
Ein korrekter Einzelwert kann im falschen Bezugsrahmen zu einer ungeeigneten Schlussfolgerung führen. Entscheidend sind daher auch Definition, Zeitraum, Datenherkunft, Granularität und der konkrete Nutzungskontext.
- Welche Rolle spielen Fachbereiche bei der Datenqualität?
Fachbereiche definieren Geschäftsbegriffe, Prioritäten und Akzeptanzkriterien. Datenteams übersetzen diese Anforderungen in Modelle, Regeln und technische Kontrollen. Gartner hebt hervor, dass rein technische Datenqualitätsprogramme häufig die Verbindung zu Geschäftsergebnissen verfehlen. [2]
- Was ist eine Entscheidungspipeline?
Der Begriff beschreibt einen End-to-End-Prozess, der Daten nicht nur aufnimmt und transformiert, sondern sie mit Kontext, Regeln, Verantwortlichkeiten und einer konkreten Handlungsoption verbindet.
- Warum ist Geschäftskontext für KI besonders wichtig?
KI-Systeme benötigen Daten, die zum Einsatzkontext passen. Das NIST betont, dass Vertrauenswürdigkeit abhängig vom Nutzungskontext bewertet und über die Funktionen Govern, Map, Measure und Manage operationalisiert werden sollte. [3]
- Welche zusätzlichen Qualitätsmerkmale sind für KI relevant?
Neben klassischen Kriterien gewinnen Repräsentativität, Verzerrungen, Label-Qualität, Rauschen, Herkunft und Eignung über den gesamten KI-Lebenszyklus an Bedeutung. [4]
- Wie lässt sich Geschäftstauglichkeit messen?
Mögliche Kennzahlen sind kürzere Entscheidungszeiten, weniger manuelle Abstimmung, sinkende Fehlerquoten, höhere Nutzungsraten, geringere Nacharbeit und messbare Beiträge zu Umsatz, Kosten, Risiko oder Servicequalität.
- Muss ein Unternehmen zuerst alle Daten bereinigen?
Nein. Ein priorisierter Ansatz beginnt bei wertvollen Anwendungsfällen und den dafür kritischen Datenelementen. McKinsey empfiehlt, Governance auf konkrete Wertschöpfungsdomänen auszurichten und iterativ auszubauen. [5]
- Wie helfen Datenprodukte?
Datenprodukte bündeln Daten, Metadaten, Qualitätsregeln, Zugriffswege und Verantwortlichkeiten für definierte Nutzergruppen. Dadurch lassen sich vertrauenswürdige Grundlagen über mehrere Anwendungsfälle hinweg wiederverwenden.
- Was ist der wichtigste erste Schritt?
Unternehmen sollten eine geschäftskritische Entscheidung auswählen, die benötigten Daten und Begriffe gemeinsam definieren sowie einen verantwortlichen fachlichen Eigentümer benennen. Erst danach werden passende technische Kontrollen und Erfolgskennzahlen festgelegt.
Quellen
-
[1] IBM: Data Quality Dimensions. https://www.ibm.com/think/topics/data-quality-dimensions
-
[2] Gartner: 12 Actions Data and Analytics Leaders Can Take to Improve Data Quality. https://www.gartner.com/en/documents/5609291
-
[3] NIST: Artificial Intelligence Risk Management Framework (AI RMF 1.0). https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-ai-rmf-10
-
[4] IBM: Why AI Data Quality Is the Key to AI Success. https://www.ibm.com/think/topics/ai-data-quality
-
[5] McKinsey & Company: Designing Data Governance That Delivers Value. https://www.mckinsey.com/capabilities/tech-and-ai/our-insights/designing-data-governance-that-delivers-value
Management Summary, FAQ und Bild wurden mit Hilfe von KI erstellt
9140 Artikel zu „Daten KI Geschäft“
Business | Business Process Management | Geschäftsprozesse | Künstliche Intelligenz | News
Von Daten zu Deals: KI treibt den Geschäftserfolg
Management Summary KI ist in Unternehmen nicht länger ein Experimentierfeld, sondern entwickelt sich zum operativen Werttreiber. Entscheidend ist nicht mehr, welche Technologie getestet wird, sondern welcher messbare Beitrag zu Umsatz, Produktivität, Risikosteuerung, Customer Experience und Innovation entsteht. Vom Pilotprojekt zum Business Impact: KI-Initiativen werden zunehmend an konkreten Ergebnissen, Verantwortlichkeiten und ROI gemessen. Produktivität durch autonome…
Business | Künstliche Intelligenz | News | Trends 2024 | Trends Services
Vorhersagen 2024: Daten und KI, Schlüssel zu Geschäftsleistungen und -ergebnissen
Das Jahr 2023 stand im Zeichen großer Veränderungen in der IT mit dem Aufkommen von ChatGPT und anderen generativen KI-Tools, die in vielen Sektoren, auch in der Datenverarbeitung, eine neue Rolle spielen. Diese Innovationen haben die IT-Landschaft und ihre Regeln deutlich verändert und sollten von Unternehmen berücksichtigt werden, die wachsen, Vorschriften einhalten und ihre Leistung…
Business | Künstliche Intelligenz | News | Trends 2022 | Trends Wirtschaft
Mehr als 460 Milliarden Dollar zusätzlicher Gewinn durch bessere Datenpraktiken, Vertrauen in künstliche Intelligenz (KI) und Geschäftsintegration

Gemeinsam besser: Studie zeigt, dass Unternehmen KI und Daten bündeln müssen, um einen strategischen Wert zu schaffen. Nach der neuen Studie des Infosys Knowledge Institute, dem Thought-Leadership- und Forschungszweig von Infosys, können Unternehmen über 460 Milliarden US-Dollar an zusätzlichen Gewinnen erwirtschaften, wenn sie die drei nachfolgenden Dinge beherzigen: Datenpraktiken verbessern, auf künstliche Intelligenz (KI)…
Business Process Management | Favoriten der Redaktion | Geschäftsprozesse | IT-Security | Künstliche Intelligenz | News | Tipps | Trends 2026 | Trends Security | Whitepaper
Vertrauen endet beim Handeln: Verbraucher setzen KI-Agenten enge Grenzen

Zwischen digitaler Assistenz und autonomem Handeln liegen kontrollierte Zugriffsrechte, Identitätsprüfung und menschliche Freigaben. KI darf beraten – doch sobald sie selbstständig handelt, sinkt die Akzeptanz deutlich. Die Consumer Survey 2026 von Ping Identity zeigt, wie eng Verbraucher die Befugnisse digitaler Agenten begrenzen wollen [1]. Für Unternehmen wird damit nicht nur die Leistungsfähigkeit der Systeme,…
IT-Security | News | Veranstaltungen
it-sa 2026: Cybersecurity zwischen KI, Regulierung und digitaler Souveränität
Die it-sa Expo&Congress 2026 wird größer, internationaler und strategischer. Zwischen KI-gestützten Angriffen, regulatorischem Umsetzungsdruck und der Absicherung vernetzter Produktionsumgebungen verschiebt sich der Fokus von isolierten Sicherheitsprodukten hin zu belastbaren Betriebsmodellen. Der Meldungsüberblick zeigt, welche Anbieter, Technologien und Managementfragen vom 27. bis 29. Oktober in Nürnberg im Mittelpunkt stehen – und wie CIOs, CISOs und Geschäftsleitungen…
Business | Künstliche Intelligenz | News | Trends 2026 | Trends Wirtschaft
KI-Patente: China dominiert die Masse, die USA die Wirkung

Bild: Der globale KI-Wettbewerb wird nicht nur über Patentzahlen entschieden, sondern über Wirkung, Kapital, Rechenleistung und industrielle Umsetzung. China vereint inzwischen fast drei Viertel der weltweit erteilten KI-Patente auf sich. Doch die Zahl allein entscheidet nicht über technologische Führung: Die USA bleiben bei Spitzenmodellen, privatem Kapital und der Wirkung ihrer Schutzrechte stark, während Europa mit…
Business | Digitale Transformation | Favoriten der Redaktion | IT-Security | Lösungen | News | Strategien | Tipps
Post-Quantum Security und Krypto-Migration bis 2030: Was Geschäftsführung und CIO jetzt entscheiden müssen
Management Summary Das Risiko ist bereits real: »Harvest Now, Decrypt Later« gefährdet Daten, die noch über Jahre geschützt bleiben müssen. Die Technik ist verfügbar: NIST hat 2024 die ersten drei PQC-Standards finalisiert; Unternehmen können mit der Migration beginnen. Inventarisierung hat Vorrang: Ohne Transparenz über Algorithmen, Schlüssel, Zertifikate, Protokolle und Lieferanten fehlt die Grundlage für Prioritäten…
Business | Business Process Management | Digitale Transformation | Effizienz | Favoriten der Redaktion | Künstliche Intelligenz | New Work | News | Strategien | Whitepaper
Vom Experiment zum Ergebnis: Der ROI-Fahrplan für KI im Mittelstand
KI ist im Mittelstand angekommen – doch zwischen Pilotprojekt und belastbarem Geschäftsnutzen liegt die eigentliche Managementaufgabe. Entscheidend sind nicht möglichst viele Tools, sondern klar priorisierte Prozesse, messbare Ziele, tragfähige Daten und eine Governance, die Skalierung ermöglicht. Der ROI-Kompass zeigt, wie Unternehmen Investitionen vom Geschäftsproblem her planen und aus einzelnen Anwendungen produktive Wertschöpfung entwickeln. Management Summary…
Business | Business Process Management | Digitalisierung | Effizienz | ERP | Geschäftsprozesse | Künstliche Intelligenz | News | Tipps | Trends 2026 | Trends Geschäftsprozesse
Agentic AI braucht Prozesswissen: Warum KI-Piloten an der Betriebsrealität scheitern
Prozesskontext verbindet Daten, Regeln, Rollen und Kontrollen – damit KI-Agenten nicht nur handeln, sondern innerhalb definierter Leitplanken handeln. Unternehmen mit starkem Prozessverständnis erzielen 5-mal häufiger erfolgreiche KI-Ergebnisse Management Summary Prozesswissen entscheidet über den KI-Erfolg: Unternehmen mit ausgeprägtem Prozesskontext berichten laut der von ARIS und The Hackett Group veröffentlichten Studie fünfmal häufiger von sehr erfolgreichen KI-Ergebnissen.[1]…
Business | Business Process Management | Geschäftsprozesse | IT-Security | News | Tipps | Trends 2026 | Trends Security | Trends Services
KI-Betrug setzt Banken unter Druck – Verbraucher akzeptieren strengere Kontrollen
Management Summary Sicherheit schlägt Geschwindigkeit: 78 Prozent der Befragten akzeptieren langsamere Identitätsprüfungen, wenn diese das Betrugsrisiko deutlich reduzieren. Transparenz wird zum Erfolgsfaktor: 62 Prozent erwarten eine Erklärung für zusätzliche Sicherheitsmaßnahmen; in Deutschland sind es 71 Prozent. Junge Erwachsene stehen besonders im Fokus: 30 Prozent der 18- bis 24-Jährigen berichten von mutmaßlich KI-generierten Betrugsversuchen. Vertrauen und…
IT-Security | News | Tipps | Trends 2026 | Trends Security
Ransomware 2026: Wenn gestohlene Daten zum schärfsten Druckmittel werden
Management Summary Daten statt Verschlüsselung: Ransomware-Gruppen erhöhen den Erpressungsdruck zunehmend durch den Abfluss großer Datenmengen; ThreatLabz beziffert das beobachtete Volumen auf 896,2 Terabyte. Führungskräfte werden zum Einfallstor: 62 Prozent der erfassten Opfer bekleideten laut Report mindestens eine Managementposition – privilegierter Zugriff und geschäftlicher Einfluss machen sie besonders attraktiv. Vertrauenswürdige Werkzeuge werden missbraucht: Angriffe über Microsoft…
Business Process Management | Geschäftsprozesse | IT-Security | Künstliche Intelligenz | News | Trends 2026 | Trends Security
87 Prozent betroffen: Wenn KI-Agenten ihre Zugriffsgrenzen überschreiten
KI-Agenten erhalten Zugriff auf Daten, Anwendungen und Entwicklungsumgebungen – doch vielerorts endet die Kontrolle nach der Anmeldung. Der Delinea-Report zeigt, wie weit Richtlinien und technische Durchsetzung auseinanderliegen. Für CIOs und CISOs folgt daraus eine klare Priorität: Berechtigungen müssen kurzlebig, kontextbezogen und bis zur einzelnen Aktion nachvollziehbar sein. Management Summary Governance-Lücke: Formale KI-Richtlinien sind nahezu flächendeckend…
Business Process Management | Geschäftsprozesse | IT-Security | News | Tipps
Cyberangriff auf die LMU: Wenn 50 Jahre Studierendendaten zum Risiko werden
Der Angriff zeigt, wie technische Schwachstellen und jahrzehntealte Datenbestände zu einem langfristigen Risiko für Hochschulen und Betroffene werden. Der Angriff auf das Zulassungssystem der Ludwig-Maximilians-Universität München macht aus einem IT-Vorfall ein langfristiges Datenschutzproblem: Rund 600.000 Datensätze aus fünf Jahrzehnten können betroffen sein. Während die forensische Aufklärung weiterläuft, verschiebt sich der Schwerpunkt von der akuten Abwehr…
Business | Business Process Management | Digitale Transformation | Favoriten der Redaktion | IT-Security | Künstliche Intelligenz | News | Services | Strategien | Tipps
Vom Garagenprojekt zum Milliardengeschäft – der Aufstieg von Open Source
Linux begann 1991 als unfertiger Kernel für wenige Rechner. Heute trägt Open Source Rechenzentren, Clouds, Behördenportale und KI-Plattformen. Der offene Code allein erklärt diesen Erfolg jedoch nicht. Entscheidend waren professionelle Betriebsmodelle, verlässlicher Support und die Erkenntnis, dass technologische Wahlfreiheit einen messbaren strategischen Wert besitzt. Für CIOs lautet die Kernfrage deshalb nicht mehr, ob Open Source…
Business Process Management | Geschäftsprozesse | IT-Security | News | Services | Tipps | Trends 2026 | Trends Security
Die nächste Stufe der Cyberbedrohung: KI-Agenten greifen zunehmend autonom an
KI-Agenten beschleunigen Angriff und Verteidigung – entscheidend sind kontrollierte Identitäten, begrenzte Rechte und nachvollziehbare Entscheidungen. KI verändert die Kräfteverhältnisse in der Cybersicherheit: Angriffe werden schneller, skalierbarer und zunehmend autonom. Der Microsoft Digital Defense Report 2026 beschreibt eine Lage, in der Identitäten, KI-Systeme und Lieferketten zugleich zur Angriffsfläche werden. Für Unternehmen folgt daraus eine Managementaufgabe:…
News | Services | Trends 2026 | Trends 2027 | Trends Services | Whitepaper
KI verändert IT-Sourcing: Wandel zu ergebnisorientierten Verträgen und KI-gestützten Liefermodellen
KI verändert Verträge, Preise und Zusammenarbeit mit IT-Dienstleistern Zunehmende Bedeutung von Managed Services und KI-gestützten Liefermodellen KI führt zu Neubewertung von Offshoring-Modellen Neue Lünendonk-Studie ab sofort verfügbar Künstliche Intelligenz (KI) verändert die Leistungs- und Vertragslogik im IT-Sourcing grundlegend. Viele IT-Provider investieren bereits stark in KI und passen ihre Leistungserbringung entsprechend an. Gleichzeitig steigen auch…
Business | Business Process Management | Geschäftsprozesse | IT-Security | Künstliche Intelligenz | News
KI-Governance umsetzen: Wie CIOs Richtlinie, Rechte und Nachweise zusammenbringen
KI-Governance entscheidet sich nicht im Richtliniendokument, sondern an den technischen Kontrollpunkten. CIOs müssen Regeln, Zuständigkeiten, Zugriffsrechte und Nachweise so verbinden, dass der KI-Einsatz steuerbar und prüfbar wird. Der Beitrag zeigt, wie Unternehmen vom KI-Inventar über SSO und rollenbasierte Berechtigungen bis zum Logging eine belastbare Governance-Struktur aufbauen – und welche Zeit-, Kosten- und Anbieteroptionen sie dabei…
IT-Security | Künstliche Intelligenz | News | Tipps
KI-Agenten absichern: Sechs Bausteine für eine belastbare Architektur

Mit KI-Agenten wird aus einer fehlerhaften Antwort schnell eine geschäftskritische Aktion. Unternehmen brauchen deshalb mehr als Modellschutz: Gefragt ist eine Sicherheitsarchitektur, die Identitäten, Daten, Berechtigungen, Endgeräte, Überwachung und Wiederherstellung miteinander verzahnt – und autonome Systeme jederzeit kontrollierbar hält. Management Summary KI-Sicherheit ist Architekturaufgabe: Schutz muss Infrastruktur, Modelle, Daten, Identitäten, Anwendungen und Endgeräte durchgängig umfassen. Agenten…
Business | Digitale Transformation | Effizienz | Geschäftsprozesse | Künstliche Intelligenz | New Work | News | Strategien
Die Rolle des CIO/CAIO wandelt sich: Mein neuer Mitarbeiter, der KI-Agent
Digitale Belegschaft unter Aufsicht: KI-Agenten brauchen klare Rollen, begrenzte Rechte und messbare Ziele. Management Summary KI-Agenten sind keine klassische Software: Sie bearbeiten Aufgaben eigenständig, benötigen dafür aber klare Ziele, belastbaren Kontext und definierte Entscheidungsgrenzen. Der CIO wird zum Orchestrator digitaler Arbeitskräfte: Auswahl, Onboarding, Rollenverteilung und laufende Kontrolle von Agenten werden zu einer Führungs- und…
Business | Geschäftsprozesse | IT-Security | News | Services | Tipps
Cyberrisiken und Managementhaftung: Was Geschäftsführer jetzt beschließen müssen
Management Summary Cyberrisiken gehören auf die Agenda der Geschäftsleitung: Persönliche Haftung entsteht vor allem dann, wenn Risikobild, Zuständigkeiten, Entscheidungen und Kontrollen fehlen oder nicht dokumentiert sind. NIS2 verschärft die Verantwortung: Betroffene Leitungsorgane müssen angemessene Risikomanagementmaßnahmen umsetzen, überwachen und sich regelmäßig schulen lassen. Im Vorfall laufen mehrere Fristen parallel: Die Meldewege nach BSIG, DSGVO, Versicherungsvertrag und…