Wird 2027 zum Wendepunkt für den Betrieb künstlicher Intelligenz? Paul Speciale, CMO von Scality, erwartet eine stärkere Verlagerung der Inferenz auf eigene Infrastruktur und eine neue Rolle für Storage. Seine neun Prognosen richten den Blick auf Kostenkontrolle, digitale Souveränität und Wiederherstellbarkeit. Für IT-Entscheider stellt sich damit eine konkrete Frage: Welche KI-Workloads gehören in die Cloud, welche ins eigene Rechenzentrum – und wie lässt sich diese Entscheidung belastbar begründen?
Management Summary
- Die Betriebsentscheidung gehört auf die Managementagenda. Aus den Prognosen ergibt sich als Prüfauftrag, API-Nutzung, Eigenbetrieb und hybride Modelle anhand von Gesamtkosten, Datenanforderungen und Servicequalität zu vergleichen – nicht allein anhand des Tokenpreises.
- Kontextwiederverwendung ist ein dokumentierter Optimierungshebel. OpenAI, Anthropic und vLLM beschreiben Verfahren zum Wiederverwenden identischer Prompt-Präfixe. Preisvorteile und technische Voraussetzungen unterscheiden sich; ein allgemeiner Einsparfaktor lässt sich daraus nicht ableiten. [1–3]
- Souveränität braucht überprüfbare Kriterien. Als redaktionelle Empfehlung sollten Unternehmen Verarbeitungsorte, Aufbewahrung, Zugriffsrechte, Modellwechsel und Exit-Möglichkeiten getrennt bewerten. Anbieterunterlagen und BSI-Empfehlungen liefern hierfür Ansatzpunkte. [4, 5]
- Leistung am Geschäftsprozess messen. GPU-Auslastung sollte durch Antwortqualität, Zeit bis zum ersten Token, Gesamtlatenz und erfolgreich abgeschlossene Vorgänge ergänzt werden. vLLM dokumentiert entsprechende technische Messgrößen. [6]
- Wiederherstellung und Governance gemeinsam planen. Für geschäftskritische KI-Anwendungen empfiehlt sich ein getesteter Wiederanlauf einschließlich Modellen, Konfigurationen und relevanten Datenbeständen. BSI, NIST und CISA bieten dafür übergreifende Sicherheits- und Risikomanagementgrundlagen. [5, 7, 8]
Illustration Absmeier foto ki designer
Bild: KI-generierte Symbolillustration zu hybrider KI-Infrastruktur, geschützten Daten und vernetztem Storage. Keine Darstellung einer konkreten Installation.
 Künstliche Intelligenz entwickelt sich rasant. Mit zunehmender Nutzung rücken die wirtschaftlichen, technologischen und regulatorischen Herausforderungen immer stärker in den Fokus. 2027 könnte dabei einen Wendepunkt markieren: Unternehmen werden verstärkt hinterfragen, wie abhängig sie von externen KI-Diensten sein wollen und wer letztendlich die Kontrolle über Kosten, Daten und Inferenz behält. Paul Speciale, CMO von Scality, zeigt in seinen neun Prognosen auf, warum die Zukunft der KI zunehmend von eigener Infrastruktur, digitaler Souveränität sowie einer leistungsfähigen, sicheren Storage-Architektur geprägt sein wird.
1. Die KI-API-Rechnung wird 2027 zur neuen Egress-Gebühr: Die erste Welle der Inferenz-Rückverlagerung
Finanzvorstände werden die tokenbasierte Abrechnung von KI-APIs künftig ähnlich kritisch bewerten wie noch vor fünf Jahren die Egress-Kosten in der Cloud: als einen Kostenfaktor, der mit wachsender Nutzung kontinuierlich steigt und sich nur schwer verlässlich kalkulieren lässt. Daher werden Unternehmen Inferenz-Workloads mit hohem, kontinuierlichem Datenaufkommen zunehmend auf die eigene Infrastruktur verlagern. APIs bleiben hingegen vor allem für die Abdeckung von Lastspitzen und den Zugriff auf besonders leistungsfähige Modelle relevant.
Erste Belege dafür gibt es bereits: ein veröffentlichter Open-Source Benchmark für den Betrieb von DeepSeek kam auf Kosten von 0,20 US-Dollar pro 1 Million generierter Output-Tokens. Die Listenpreise führender kommerzieller APIs liegen mehr als zehnmal so hoch.
2. Der KV-Cache entwickelt sich zum wichtigsten neuen Storage-Workload in Unternehmen
2026 rückten die Kosten pro Token (Cost per Token) zunehmend in den Fokus. 2027 wird sich zeigen, dass ein erheblicher Teil dieser Kosten auf die wiederholte Berechnung von Kontext entfällt, der bereits zuvor verarbeitet wurde. Das Kontextgedächtnis wird daher zunehmend aus dem GPU-Speicher in eine gemeinsam genutzte Storage-Ebene ausgelagert. Damit verschiebt sich auch die Bedeutung von „Storage für KI“: statt primär Trainingsdaten zu speichern, geht es künftig vor allem darum, das laufende Inferenzgedächtnis effizient bereitzustellen.
Unsere eigenen Labortests liefern dafür konkrete Anhaltspunkte: Eine einzelne GLM-5.2-Sitzung erzeugte 189 GB KV-Cache. Bei 10.000 vergleichbaren Sitzungen wären rund 1,9 PB erforderlich. Das erneute Auslesen des Kontexts war 14- bis 72-mal schneller als dessen Neuberechnung. Anthropic und OpenAI berechnen für gecachte Input-Tokens höchstens ein Zehntel des Preises für nicht gecachte Tokens. Das zeigt: Die großen Anbieter wirtschaften bereits nach den Prinzipien der Cache-Ökonomie.
3. Souveränität ohne Kontrolle über die Inferenz ist reine Inszenierung
Wer seine Daten zwar im eigenen Land speichert, zugleich aber sämtliche Prompts, abgerufenen Dokumente und Ausgaben von Agenten an eine ausländische API übermittelt, wird 2027 einer umfassenden Compliance-Prüfung kaum standhalten. „Sovereign Inference“ wird sich daher zu einem festen Kriterium bei der Beschaffung von IT-Lösungen entwickeln, insbesondere im europäischen öffentlichen Sektor sowie in den Bereichen Verteidigung, Finanzwesen und Telekommunikation.
Digitale Souveränität reicht jedoch weit über die Kontrolle von Daten hinaus. Sie ist längst nicht mehr nur ein europäisches Thema oder auf den öffentlichen Sektor beschränkt. Jedes Unternehmen, das KI-Inferenz einsetzt, muss sowohl die Kosten als auch die Wahl und den Betrieb der verwendeten Modelle selbst kontrollieren können, unabhängig von seinem Standort.
Diese Kontrolle setzt voraus, dass Unternehmen drei Bereiche selbst beherrschen:
- Datensouveränität: Der Kontext verbleibt unter der eigenen Rechtshoheit. Jede Agentenanfrage umfasst den relevanten Code-Bestand, abgerufene Dokumente sowie die Ergebnisse sämtlicher aufgerufener Tools. Führende kommerzielle APIs speichern diesen Kontext standardmäßig 30 bis 55 Tage lang. Eine Speicherung von null Tagen muss ausdrücklich beantragt und genehmigt werden. Hinzu kommt die rechtliche Zuständigkeit des Anbieters: der US-amerikanische CLOUD Act ermöglicht es US-Behörden, von einem US-Anbieter die Herausgabe von Daten zu verlangen, selbst wenn diese im Ausland gespeichert sind.
- Kostensouveränität: Unternehmen bestimmen selbst, welche Kosten pro Anfrage entstehen, und in der Folge auch ihre Margen. Die tokenbasierte Abrechnung steigt gerade dann besonders stark, wenn KI intensiv genutzt wird. Selbst gecachter Kontext wird bei jeder neuen Interaktion erneut berechnet. Bei Betrieb auf eigener Infrastruktur steht das Budget bereits vor der ersten Anfrage fest. Je intensiver die Teams die Infrastruktur nutzen, desto geringer fallen die Kosten pro Token aus.
- Inferenzsouveränität: Unternehmen entscheiden selbst, welches Modell eingesetzt und wie es bereitgestellt wird. Führende API-Anbieter kündigen die Abschaltung eines Preview-Modells mitunter nur zwei Wochen im Voraus an. Bei allgemein verfügbaren Modellen können es bis zu sechs Monate sein. Auch das Modell hinter einem Alias kann sich ändern, ohne dass der Name des Endpunkts angepasst wird. Wer Modellversion und Quantisierung selbst festlegt, kann sicherstellen, dass ein im März validiertes Ergebnis auch im September reproduzierbar bleibt.
Datensouveränität ohne Kosten- und Inferenzsouveränität ist letztlich nur ein Souveränitätsversprechen ohne Substanz. Die Daten verbleiben im eigenen Land, doch über die Rechnung und das eingesetzte Modell entscheidet weiterhin ein Dritter.
4. Storage wird künftig daran gemessen, wie gut es die GPUs auslastet
Im vergangenen Jahr haben wir prognostiziert, dass ergebnisorientierte Kennzahlen die IOPS als zentrale Bewertungsgröße ablösen werden. 2027 rückt dabei eine Kennzahl besonders in den Mittelpunkt: die GPU-Auslastung. Ungenutzte Beschleuniger gehören zu den teuersten Kostenpositionen eines KI-Budgets. Storage ist einer der wesentlichen Gründe dafür, dass GPUs nicht kontinuierlich ausgelastet werden. Künftig wird sich die Leistungsfähigkeit einer Storage-Lösung daher auch daran messen, wie effektiv sie die Leerlaufzeiten der GPUs reduziert.
5. Inferenz benötigt eine eigene Backup-Strategie
Inferenz-Assets (darunter Modelle, Agentengedächtnis sowie KV-Caches) werden 2027 zu geschäftskritischen Datenbeständen. Unternehmen müssen sie deshalb genauso schützen wie alle anderen Daten, auf deren Verlust sie sich nicht einlassen können. Diese Assets sind sowohl potenzielle Ziele von Ransomware-Angriffen als auch Gegenstand von Audits. Entsprechend erforderlich sind Unveränderbarkeit, Versionierung und regelmäßig getestete Wiederherstellungsprozesse. Ein Unternehmen ohne Wiederherstellungsplan für seine Inferenz-Umgebung wird künftig ähnlich verwundbar erscheinen wie ein Unternehmen ohne Backup-Strategie.
6. Das Gedächtnis von KI-Agenten wird zu regulierten Daten
2026 stand die Nachvollziehbarkeit der Herkunft und Verarbeitung von Trainingsdaten im Mittelpunkt. 2027 wird sich diese Anforderung auf den Kontext verlagern: welche Informationen hat ein Agent gesehen, welche davon gespeichert und auf welcher Grundlage hat er gehandelt?
Aufsichtsbehörden und Prozessparteien werden zunehmend entsprechende Nachweise verlangen. Unternehmen können diese jedoch kaum bereitstellen, wenn die betreffenden Informationen ausschließlich in der Cloud eines externen Anbieters liegen.
7. 2027 wird es erstmals zu einem größeren, KI-bedingten Betriebsausfall kommen
Ein Ausfall beim KI-Anbieter, eine Drosselung der API-Nutzung oder geänderte Nutzungsrichtlinien können künftig ganze Geschäftsprozesse zum Erliegen bringen, da KI-Agenten zunehmend geschäftskritische Workflows steuern. Damit gewinnt die Diskussion um das Konzentrationsrisiko im KI-Bereich an Bedeutung, vergleichbar mit der Abhängigkeit von einzelnen Cloud-Anbietern. Diese Entwicklung wird die Verbreitung von hybriden KI-Strategien weiter beschleunigen, bei denen Inferenz sowohl On-Prem als auch in der Cloud ausgeführt wird.
8. Ransomware mit KI: Angriffe in Maschinengeschwindigkeit, Schutz durch unveränderbare Daten
KI-Agenten werden künftig komplette Ransomware-Angriffe autonom orchestrieren, von der Aufklärung über die Vorbereitung bis hin zur Verschlüsselung. Das geschieht schneller, als Sicherheitsteams reagieren können. Die Entwicklung hat bereits begonnen: Bei einem der ersten öffentlich dokumentierten KI-gesteuerten Cyberangriffe übernahm die KI laut Anthropic (2025) 80 bis 90 Prozent der Arbeit. Auch Backups bleiben ein vorrangiges Angriffsziel: bereits 89 Prozent der Unternehmen waren mit Angriffen auf ihre Datensicherungen konfrontiert (Veeam, 2025). Wenn Erkennungssysteme mit der Geschwindigkeit der Angriffe nicht mehr Schritt halten können, bleibt eine Verteidigungsmaßnahme entscheidend: Daten, die niemand löschen kann, weder ein Angreifer noch ein Administrator (noch ein KI-Agent). Die entscheidende Frage in den Vorstandsetagen wird daher nicht mehr lauten: „Können Sie einen Angriff erkennen?“, sondern: „Können Sie Ihre Daten und Systeme wiederherstellen?“
9. Unternehmen wollen die Kontrolle über Software-Stacks behalten, unabhängig vom GPU-Anbieter
Proprietäre, vertikal integrierte Komplettlösungen für KI-Fabriken werden zunehmend auf Widerstand stoßen, ähnlich wie es zuvor bei proprietären Storage-Arrays der Fall war. Unternehmen werden offene Software-Stacks bevorzugen, deren Fehlerbehebungen direkt in die jeweiligen Upstream-Projekte einfließen und die ohne herstellerspezifische Forks auskommen. Das Ziel: Ein Wechsel der GPU- beziehungsweise Accelerator-Plattform soll nicht länger bedeuten, dass die gesamte Softwareumgebung neu aufgebaut werden muss.
 Paul Speciale, CMO, Scality
Paul Speciale ist Chief Marketing Officer (CMO) bei Scality, einem Unternehmen, das sich auf cyberresistente Datenspeicherlösungen spezialisiert hat. In dieser Funktion leitet er die globale Marketingorganisation des Unternehmens, die sowohl das Produkt- als auch das Unternehmensmarketing umfasst. Er verfügt über mehr als 20 Jahre Branchenerfahrung und hatte zuvor Führungspositionen bei Unternehmen wie Appcara, Amplidata und Savvis inne.
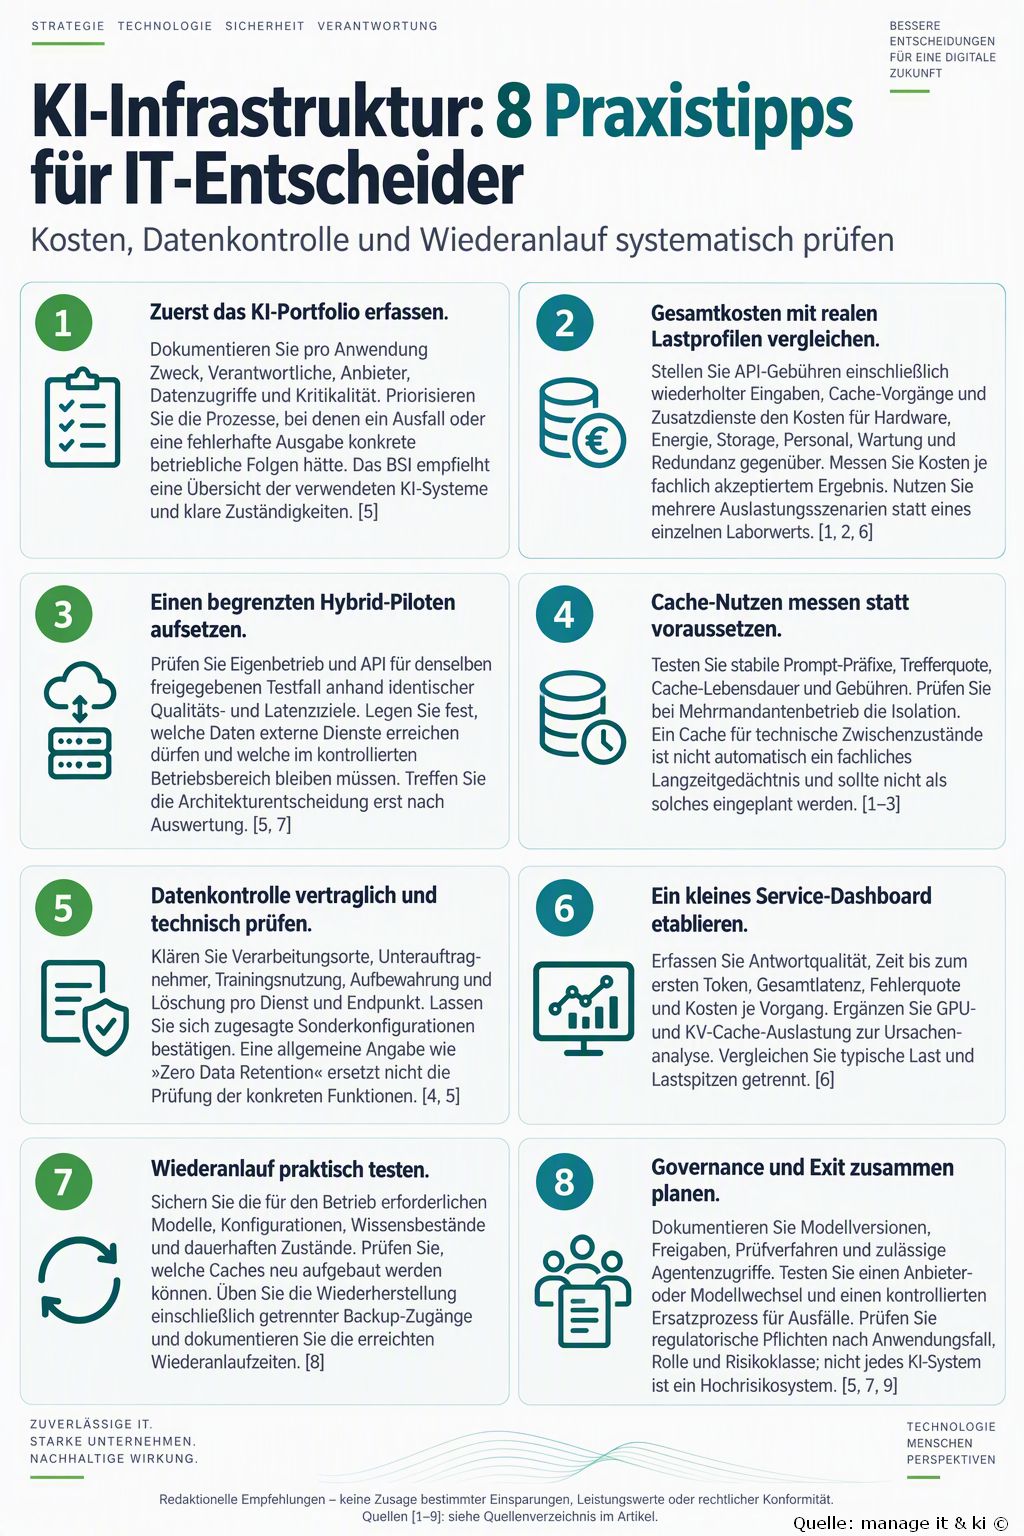
Praxistipps für IT-Entscheider
Die folgenden Tipps sind redaktionelle Empfehlungen auf Basis des Artikels und der angegebenen Quellen. Sie sind keine Zusage bestimmter Einsparungen, Leistungswerte oder rechtlicher Konformität.
.
Ausführliche Tipps mit Praxisbeispielen
[Inference] Die folgenden Umsetzungsvorschläge vertiefen die acht Tipps. Alle Praxisbeispiele sind ausdrücklich fiktiv und dienen der Veranschaulichung; sie beschreiben keine überprüften Unternehmensprojekte. Prüfkriterien und Zuständigkeiten sind Vorschläge, keine verbindlichen Vorgaben. Die Quellenbezugszeichen verweisen auf das bestehende Quellenverzeichnis.
1. KI-Portfolio erfassen: Aus Einzelprojekten eine steuerbare Übersicht machen
[Inference] Umsetzung: Beginnen Sie mit einem gemeinsamen Register von IT, Fachbereichen, Informationssicherheit und Datenschutz. Erfassen Sie nicht nur eigenständige KI-Anwendungen, sondern auch aktivierte KI-Funktionen in bestehenden Softwareprodukten. Tragen Sie Zweck, fachliche Verantwortung, technischen Betrieb, verwendete Modelle, Datenquellen, externe Verbindungen und zulässige Aktionen ein. Kennzeichnen Sie, ob die Anwendung lediglich Entwürfe liefert oder Änderungen an Geschäftssystemen auslösen darf. Bewerten Sie anschließend Ausfallfolgen, Schutzbedarf und vorhandene Ersatzprozesse. Eine knappe, regelmäßig gepflegte Übersicht ist als Startpunkt sinnvoller als ein umfangreiches Register ohne Verantwortliche.Fiktives Praxisbeispiel: Ein Maschinenbauunternehmen erfasst einen internen Wissensassistenten, eine KI-Funktion im Ticketsystem und einen Assistenten für Angebotsentwürfe. Für den Wissensassistenten wird dokumentiert, welche Handbücher zugänglich sind. Beim Angebotsassistenten wird festgehalten, dass Preise und Lieferzusagen vor Versand fachlich freigegeben werden müssen. Das Register macht damit unterschiedliche Kontrollanforderungen sichtbar, ohne alle Anwendungen gleich zu behandeln.
Prüfkriterium: Für jede freigegebene Anwendung sind eine verantwortliche Stelle, zulässige Daten und Aktionen sowie ein Ersatzprozess dokumentiert. Änderungen an Integrationen lösen eine erneute Prüfung aus. Vorgeschlagene Federführung: IT-Governance gemeinsam mit den Fachbereichen. Quellenbezug: [5].
2. Gesamtkosten vergleichen: Den akzeptierten Geschäftsvorgang als Maßstab nutzen
[Inference] Umsetzung: Definieren Sie zunächst, was ein erfolgreiches Ergebnis ist: etwa eine fachlich freigegebene Zusammenfassung oder ein korrekt zugeordnetes Ticket. Erfassen Sie für einen repräsentativen Zeitraum Anfragen, Kontextlängen, Wiederholungen, Fehler und Nachbearbeitung. Stellen Sie für API, Eigenbetrieb und Hybridmodell dieselben Qualitäts- und Verfügbarkeitsanforderungen gegenüber. Berücksichtigen Sie beim Eigenbetrieb auch ungenutzte Kapazität, Betriebsaufwand, Wartung, Energie und Redundanz; bei APIs Gebühren für Ein- und Ausgaben, Cache-Vorgänge und Zusatzdienste. Halten Sie einmalige Einführungskosten getrennt von laufenden Kosten fest. Rechnen Sie mit niedriger, typischer und hoher Last, statt einen einzelnen günstigen Lastpunkt zur Entscheidungsgrundlage zu machen.Fiktives Praxisbeispiel: Ein technischer Kundendienst vergleicht zwei Betriebsoptionen für Ticketzusammenfassungen. Die Auswertung zählt nicht nur generierte Zusammenfassungen, sondern solche, die ohne wesentliche Korrektur übernommen werden können. Ein günstigeres Angebot mit häufigerer Nachbearbeitung wird deshalb nicht automatisch bevorzugt. Beschaffung und Fachbereich dokumentieren gemeinsam, welche Kostenpositionen gemessen und welche lediglich geschätzt wurden.
Prüfkriterium: Die Entscheidungsvorlage zeigt Gesamtkosten, Auslastungsannahmen, Qualitätsniveau und Kosten je akzeptiertem Ergebnis. Unsichere Annahmen sind ausdrücklich markiert; eine Sensitivitätsanalyse zeigt, wann sich die Rangfolge der Optionen ändert. Vorgeschlagene Federführung: IT-Controlling und Serviceverantwortliche. Quellenbezug: [1, 2, 6].
3. Hybrid-Pilot begrenzen: Vergleichbare Bedingungen vor Architekturentscheidungen schaffen
[Inference] Umsetzung: Wählen Sie einen überschaubaren Anwendungsfall mit klaren Eingaben und überprüfbaren Ergebnissen. Verwenden Sie für beide Betriebsoptionen denselben freigegebenen Testsatz und dokumentieren Sie Modellversionen und Einstellungen. Definieren Sie vor dem Test die Qualitätsanforderungen, zulässigen Datenwege, erwarteten Lasten und Abbruchkriterien. Starten Sie ohne automatische Änderungen an produktiven Geschäftssystemen. Prüfen Sie anschließend, ob der mögliche Nutzen zusätzlichen Aufwand für Routing, Monitoring und Betrieb rechtfertigt. Die Freigabe für einen Pilotversuch sollte nicht mit der Freigabe für einen flächendeckenden Einsatz gleichgesetzt werden.Fiktives Praxisbeispiel: Ein Ersatzteilanbieter testet die Suche in freigegebenen Produktinformationen. Eine Variante nutzt eine externe API mit öffentlichen Daten; die andere läuft in einer internen Testumgebung. Interne Preislisten bleiben außerhalb des externen Tests. Der Fachbereich beurteilt beide Varianten anhand derselben Fragen und Quellen. Erst nach der Auswertung wird entschieden, ob eine hybride Aufteilung fachlich und betrieblich sinnvoll ist.
Prüfkriterium: Das Pilotprotokoll enthält Datenfreigabe, Testbedingungen, Ergebnisse, Betriebsaufwand und eine begründete Entscheidung: ausbauen, nachbessern oder beenden. Vorgeschlagene Federführung: IT-Architektur mit Fachbereich und Informationssicherheit. Quellenbezug: [5, 7].
4. Cache-Nutzen prüfen: Wiederverwendung, Kosten und Datenabgrenzung gemeinsam testen
[Inference] Umsetzung: Untersuchen Sie, welche Teile Ihrer Anfragen tatsächlich unverändert wiederkehren. Trennen Sie stabile Vorgaben und freigegebene Referenzinformationen von wechselnden Nutzereingaben. Vergleichen Sie Testläufe mit und ohne aktivierte Cache-Nutzung bei identischen Bedingungen. Erfassen Sie Treffer, Schreib- und Lesevorgänge, Gesamtkosten sowie Antwortlatenzen. Prüfen Sie, welche Auswirkungen Ablaufzeiten und Änderungen der Referenzinformationen haben. Dokumentieren Sie die Trennung zwischen Mandanten beziehungsweise Berechtigungsbereichen. Fachlich dauerhaft benötigte Informationen gehören in einen dafür vorgesehenen Datenbestand, nicht allein in einen technischen Cache.Fiktives Praxisbeispiel: Ein Serviceportal verwendet wiederkehrende Anweisungen zur Struktur von Antwortentwürfen. Das Team testet, ob ihre Wiederverwendung messbare Vorteile bringt. Nach einer Änderung der freigegebenen Produktinformationen kontrolliert es zusätzlich die Versionierung und Aktualisierung der verwendeten Referenzen. Ein gesonderter Test mit getrennten Testkonten prüft die vorgesehene Mandantentrennung.
Prüfkriterium: Ein Messbericht weist den Nutzen unter den getesteten Lastbedingungen aus und dokumentiert Isolation und Aktualisierung. Aussagen über technische Wiederverwendung basieren hier auf den im Ausgangstext referenzierten Implementierungs- und Beobachtungsmustern, nicht auf einem universellen Verhalten aller Sprachmodelle. Vorgeschlagene Federführung: Plattformbetrieb und Anwendungsentwicklung. Quellenbezug: [1–3].
5. Datenkontrolle nachweisen: Verträge, Einstellungen und reale Datenwege abgleichen
[Inference] Umsetzung: Erstellen Sie für jede Anwendung eine Datenflussübersicht vom Ursprung der Informationen bis zur Ausgabe und möglichen Protokollierung. Prüfen Sie dabei auch angebundene Tools, Telemetrie und Supportzugänge. Gleichen Sie vertragliche Zusagen mit den tatsächlich aktivierten Funktionen ab. Dokumentieren Sie Verarbeitungsorte, Unterauftragnehmer, Trainingsnutzung, Aufbewahrung und Löschverfahren getrennt. Lassen Sie Sondervereinbarungen der konkreten Umgebung zuordnen. Verwenden Sie für Funktions- und Löschtests freigegebene Testdaten. Offene Punkte sollten vor der Verarbeitung schutzbedürftiger Inhalte geklärt werden; eine Produktbezeichnung allein ist kein Prüfprotokoll.Fiktives Praxisbeispiel: Ein Unternehmen plant einen Assistenten für vertrauliche technische Dokumentationen. Einkauf prüft die Vertragsunterlagen, Datenschutz die Datenkategorien und IT die aktivierten Speicher- und Protokollierungsfunktionen. Eine zusätzliche Analyse zeigt, welche Informationen an ein angebundenes Suchwerkzeug übermittelt würden. Diese Verbindung wird erst nach gesonderter Freigabe in den Test einbezogen.
Prüfkriterium: Für jeden Datenweg sind Zweck, Empfänger, Freigabe und Löschregel dokumentiert. Vertragliche Zusagen und technische Konfigurationen werden bei relevanten Änderungen erneut abgeglichen. Vorgeschlagene Federführung: Datenschutz und Informationssicherheit mit Einkauf und IT-Betrieb. Quellenbezug: [4, 5]. Diese Empfehlung ersetzt keine Einzelfallprüfung.
6. Service-Dashboard aufbauen: Geschäftliche Qualität und technische Ursachen verbinden
[Inference] Umsetzung: Beschränken Sie das erste Dashboard auf wenige entscheidungsrelevante Größen: akzeptierte Ergebnisse, Fehler, Zeit bis zum ersten Token, Gesamtlatenz und Kosten je Vorgang. Ergänzen Sie technische Messwerte zur Erklärung von Abweichungen, etwa Warteschlangen, GPU- und Cache-Auslastung. Betrachten Sie neben Durchschnittswerten auch langsamere Anfragen, beispielsweise das 95. Perzentil: den Wert, unter dem 95 Prozent der gemessenen Latenzen liegen. Definieren Sie, welche Messperiode und Lastbedingungen gelten. Qualität sollte anhand eines freigegebenen Prüfschemas erfasst werden; ein schnell erzeugter, unbrauchbarer Entwurf ist kein erfolgreicher Vorgang.Fiktives Praxisbeispiel: Ein interner Wissensdienst zeigt im Mittel kurze Antwortzeiten. Im Pilot werden zusätzlich Lastspitzen nach Schichtbeginn ausgewertet. Das Team untersucht langsame Vorgänge getrennt nach Dokumentensuche, Wartezeit und Antworterzeugung. Der Fachbereich prüft eine Stichprobe der Ergebnisse auf Quellenbezug und Verwendbarkeit. So entsteht eine gemeinsame Grundlage für Optimierung, statt ausschließlich die Hardwareauslastung zu diskutieren.
Prüfkriterium: Jede Kennzahl hat eine Definition, einen Verantwortlichen und ein vereinbartes Reaktionsverfahren bei Abweichungen. Beobachtungen werden nicht ohne Prüfung als Ursache interpretiert. Vorgeschlagene Federführung: Servicebetrieb mit fachlicher Qualitätssicherung. Quellenbezug: [6].
7. Wiederanlauf üben: Die gesamte Anwendung statt nur einzelne Dateien betrachten
[Inference] Umsetzung: Listen Sie Voraussetzungen für einen funktionsfähigen Wiederanlauf auf: Modellartefakte beziehungsweise verfügbare Ersatzmodelle, Anwendungskonfiguration, freigegebene Wissensbestände, nötige Zustände sowie Zugriffs- und Abhängigkeitskonfigurationen. Legen Sie mit dem Fachbereich fest, wie lange der Dienst ausfallen darf und welcher Datenverlust tolerierbar wäre. Unterscheiden Sie gesicherte Bestände von solchen, die neu aufgebaut werden können. Üben Sie die Wiederherstellung in einer isolierten Testumgebung und prüfen Sie anschließend auch die fachliche Funktion. Beziehen Sie getrennte Backup-Zugänge, erreichbare Wiederherstellungsunterlagen und einen kontrollierten Ersatzprozess ein.Fiktives Praxisbeispiel: Ein Wartungsassistent wird in einer Testumgebung vollständig neu bereitgestellt. Das Team stellt die freigegebenen Handbücher und Anwendungskonfiguration wieder her, baut den Suchindex neu auf und verzichtet auf die Wiederherstellung rekonstruierbarer Caches. Danach prüft der Fachbereich bekannte Testfragen und die vorgesehenen Leserechte. Das Protokoll hält tatsächliche Zeiten und fehlende Voraussetzungen fest, ohne einen erfolgreichen Dateirestore bereits als vollständigen Service-Wiederanlauf zu werten.
Prüfkriterium: Ein nachvollziehbares Restore-Protokoll bestätigt technische und fachliche Tests. Abweichungen werden mit Verantwortlichen und Nachtesttermin dokumentiert. Vorgeschlagene Federführung: IT-Betrieb und Business Continuity Management. Quellenbezug: [8].
8. Governance und Exit planen: Wechselbarkeit praktisch nachweisen
[Inference] Umsetzung: Halten Sie Modell- und Anwendungsversionen, Freigaben, Prüfsätze und erlaubte Aktionen in einem kontrollierten Änderungsverfahren fest. Prüfen Sie vor einem Wechsel Qualität, Schnittstellen, Datenwege, Lizenzbedingungen und Betriebsaufwand. Exportierbare Konfigurationen sind dabei nur ein Teil der Vorbereitung; die Anwendung muss mit der Alternative auch fachlich funktionieren. Definieren Sie einen Ersatzbetrieb für Ausfälle und einen Rückweg bei fehlgeschlagenen Änderungen. Lassen Sie regulatorische Pflichten nach konkretem Anwendungsfall und Unternehmensrolle prüfen, statt sie allein aus der Verwendung eines KI-Agenten abzuleiten.Fiktives Praxisbeispiel: Ein Assistent für Angebotsentwürfe verarbeitet ausschließlich freigegebene Vorlagen; der Versand bleibt eine menschlich freigegebene Aktion. Vor einem Modellwechsel werden alternative Entwürfe anhand derselben Testfälle auf Pflichtangaben und zulässige Formulierungen geprüft. Zusätzlich übt das Team die Weiterarbeit mit einem klassischen Vorlagenprozess, falls der KI-Dienst nicht verfügbar ist. Der Wechsel wird erst nach fachlicher und technischer Abnahme freigegeben.
Prüfkriterium: Ein dokumentierter Wechseltest zeigt Funktionsumfang, Qualität, offene Abhängigkeiten und Rückfallverfahren. Das Management erhält einen belegten Prüfstatus statt einer pauschalen Zusicherung von Anbieterunabhängigkeit. Vorgeschlagene Federführung: IT-Governance und Fachbereich mit Einkauf und Rechtsfunktion. Quellenbezug: [5, 7, 9]. Diese Empfehlung ist keine Rechtsberatung.
FAQ: KI-Inferenz, Souveränität und Storage
Die folgenden Antworten ergänzen den Prognosetext durch öffentlich zugängliche Primärquellen. Anbieterangaben sind als solche bezeichnet; daraus abgeleitete Bewertungen und Empfehlungen sind gekennzeichnet. Rechtliche Hinweise dienen der allgemeinen Einordnung, nicht der Prüfung eines konkreten Einzelfalls.
1. Endet 2027 tatsächlich die Ära gemieteter KI?
[Unverified] Die Jahreszahl ist Teil der Prognose im Ausgangstext. Die recherchierten technischen Dokumentationen belegen verfügbare Caching-Verfahren und die NIST-Publikation einen Rahmen für KI-Risikomanagement, nicht das Ende API-basierter KI im Jahr 2027. Ich kann das nicht überprüfen. [1–3, 7] Für eine Beschaffungsentscheidung empfiehlt sich deshalb ein Vergleich der konkreten Betriebsoptionen statt einer Festlegung anhand dieser Zukunftsthese.2. Wann lohnt sich eigene Inferenz gegenüber einer API?
Eine allgemeingültige Schwelle lässt sich aus den recherchierten Quellen nicht ableiten. Vergleichen Sie Gesamtkosten bei gleicher Ergebnisqualität, Verfügbarkeit und Latenz: Beim Eigenbetrieb zählen auch Auslastung, Personal und Redundanz; bei APIs auch Cache-Schreibvorgänge, wiederholte Kontexte und Zusatzfunktionen. Die Anbieter dokumentieren unterschiedliche Cache- und Abrechnungsmechanismen, vLLM unterschiedliche Leistungsmetriken. [1, 2, 6] [Unverified] Den im Artikel angeführten Wert von 0,20 US-Dollar pro Million Output-Tokens habe ich nicht unabhängig bestätigt. Ich kann das nicht überprüfen.
3. Was ist ein KV-Cache – und ist er ein Agentengedächtnis?
OpenAI beschreibt den KV-Cache als gespeicherte Key-Value-Zwischenzustände für ein wiederverwendbares Prompt-Präfix, nicht als Speicherung der Tokens selbst. vLLM dokumentiert die Wiederverwendung entsprechender Cache-Blöcke bei übereinstimmenden Präfixen. [1, 3] Daraus folgt für die Architekturplanung: Technischen KV-Cache, Gesprächsverlauf und dauerhaftes fachliches Agentengedächtnis getrennt behandeln. Sie erfüllen unterschiedliche Zwecke und sollten nicht pauschal dieselben Aufbewahrungs- und Backup-Regeln erhalten.
4. Macht Prompt-Caching jede KI-Anfrage günstiger und schneller?
OpenAI und Anthropic dokumentieren die Wiederverwendung übereinstimmender Prompt-Präfixe; Anthropic unterscheidet automatische Cache-Steuerung und explizite Cache-Grenzen sowie standardmäßig fünf Minuten Cache-Lebensdauer. OpenAI weist auf modellabhängige Preise hin. [1, 2] Die tatsächliche Wirtschaftlichkeit hängt damit von Wiederverwendung, Trefferquote, Lebensdauer und Gebühren ab. Ein pauschaler Preisvorteil für jede Anfrage ist durch diese Unterlagen nicht belegt. Die technische Beschreibung beruht auf dokumentierten Implementierungs- und Beobachtungsmustern, nicht auf einem universellen Verhalten aller Sprachmodelle.
5. Bleiben API-Daten grundsätzlich 30 bis 55 Tage beim Anbieter?
Diese pauschale Frist bestätigt die recherchierte OpenAI-Dokumentation nicht. OpenAI unterscheidet Missbrauchsüberwachungsprotokolle und gespeicherte Anwendungszustände. Für Überwachungsprotokolle nennt der Anbieter standardmäßig bis zu 30 Tage mit beschriebenen Ausnahmen; Anwendungszustände hängen von der Funktion ab. Zero Data Retention und Modified Abuse Monitoring erfordern eine vorherige Genehmigung, und nicht alle Funktionen sind für Zero Data Retention geeignet. Laut OpenAI werden API-Daten ohne ausdrückliche Zustimmung nicht zum Modelltraining verwendet. [4] Prüfen Sie diese Punkte deshalb pro Produkt, Endpunkt und Vertrag statt mit einer branchenweiten Frist zu rechnen.
6. Reicht ein Rechenzentrum in Deutschland für digitale Souveränität?
Das BSI empfiehlt neben dem Serverstandort unter anderem Transparenz des Anbieters, datensparsame Konfigurationen, rechtliche Prüfung, Löschfristen und ein Berechtigungskonzept. [5] Ein Standortmerkmal allein ist daher kein hinreichender Nachweis umfassender Kontrolle. Für eine betriebliche Prüfung sollten auch externe API-Aufrufe, Unterauftragnehmer, administrative Zugänge und Wechselmöglichkeiten erfasst werden. [Unverified] Ob eine konkrete Installation diese Anforderungen erfüllt, kann ich ohne ihre technischen und vertraglichen Unterlagen nicht überprüfen.
7. Muss künftig jedes Agentengedächtnis vollständig protokolliert werden?
Eine solche allgemeine Pflicht nennt die FAQ der Europäischen Kommission nicht. Sie unterscheidet Pflichten nach Risikoklasse und Rolle. Für Anbieter von Hochrisiko-KI-Systemen nennt sie unter anderem Risikomanagement, Protokollierung, Daten-Governance und menschliche Aufsicht. Für Systeme mit Transparenzrisiken gelten andere Anforderungen; für Minimalrisikosysteme beschreibt sie keine entsprechenden spezifischen Pflichten des AI Acts. [9] Protokollierung sollte daher an Anwendungsfall, einschlägigen Regeln und Prüfzweck ausgerichtet werden, nicht pauschal an der Bezeichnung »Agentengedächtnis«. Dies ist keine Rechtsberatung.
8. Welche Kennzahlen gehören neben GPU-Auslastung ins Dashboard?
vLLM dokumentiert unter anderem Zeit bis zum ersten Token, Inter-Token-Latenz, Gesamtlatenz, abgeschlossene Anfragen, Tokenmengen, KV-Cache-Belegung und Cache-Treffer. [6] Ergänzen Sie diese Betriebsmetriken um fachliche Antwortqualität, Fehlerquote und Kosten je akzeptiertem Geschäftsvorgang. Setzen Sie Zielwerte pro Anwendung und messen Sie unter realistischer gleichzeitiger Last. So wird die Hardwareauslastung zu einer Diagnosegröße innerhalb eines Serviceprofils, nicht zum alleinigen Erfolgskriterium.
9. Müssen alle KV-Caches dauerhaft gesichert werden?
Der CISA-Leitfaden empfiehlt für kritische Daten offline gehaltene, verschlüsselte Backups und regelmäßige Tests ihrer Verfügbarkeit und Integrität. Er enthält keine allgemeine Pflicht zur dauerhaften Sicherung jedes KI-KV-Caches. [8] Entscheidend ist, welche Bestände für einen fachlich korrekten Wiederanlauf nötig sind: Modelle, Konfigurationen, Wissensquellen und dauerhafte Zustände können andere Anforderungen haben als rekonstruierbare technische Caches. Prüfen Sie Wiederaufbaukosten und Wiederanlaufzeit. Unveränderbarkeit sollte als Schutzschicht bewertet werden, nicht als Ersatz für Isolation, Berechtigungen und Restore-Tests.
10. Wie lässt sich die Abhängigkeit von einem KI-Anbieter reduzieren?
NIST stellt mit dem Generative AI Profile einen freiwilligen, branchenübergreifenden Rahmen für das Risikomanagement generativer KI bereit. Das BSI empfiehlt klare Zuständigkeiten und die Integration von KI in das IT-Sicherheitsmanagement. [5, 7] Als praktische Ableitung sollten Unternehmen Schnittstellen und Konfigurationen dokumentieren, Datenexporte prüfen, alternative Modelle mit einem gemeinsamen Testsatz bewerten und einen Ersatzprozess für Ausfälle erproben. Offene Komponenten können dabei eine Option sein; tatsächliche Portabilität ist erst durch einen getesteten Wechsel nachgewiesen.
Quellen der redaktionellen Ergänzungen
Recherchestand: 2. November 2026. Die Bezugszeichen beziehen sich auf die neu ergänzte Management Summary, die Praxistipps und die FAQ. Der ursprüngliche Gastbeitrag bleibt unverändert. Anbieterbeschreibungen sind keine unabhängigen Leistungsnachweise; Dokumentationen und Konditionen können sich ändern.
[1] OpenAI: Prompt caching. https://developers.openai.com/api/docs/guides/prompt-caching
[2] Anthropic: Prompt caching. https://platform.claude.com/docs/en/build-with-claude/prompt-caching
[3] vLLM: Automatic Prefix Caching. https://docs.vllm.ai/en/stable/design/prefix_caching/
[4] OpenAI: Data controls in the OpenAI platform. https://developers.openai.com/api/docs/guides/your-data
[5] BSI: Sichere generative KI in Organisationen und Unternehmen. https://www.bsi.bund.de/SharedDocs/Downloads/DE/BSI/Publikationen/Broschueren/Management_Blitzlicht/Management_Blitzlicht_Generative-KI.pdf?__blob=publicationFile&v=3
[6] vLLM: Metrics, Version 0.29.0. https://docs.vllm.ai/en/v0.29.0/design/metrics/
[7] NIST: Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile, NIST AI 600-1. https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence
[8] CISA: #StopRansomware Guide. https://www.cisa.gov/sites/default/files/2025-03/StopRansomware-Guide%20508.pdf
[9] Europäische Kommission, AI Act Service Desk: What are the obligations for high-risk, transparency-risk, and minimal-risk AI systems? https://ai-act-service-desk.ec.europa.eu/en/ai-act/faq/what-are-obligations-high-risk-transparency-risk-and-minimal-risk-ai-systems
[Unverified] Einordnung: Die Aussagen über 2027 im Ausgangstext sind Prognosen von Paul Speciale, CMO von Scality, keine bestätigten Entwicklungen. Den genannten DeepSeek-Kostenbenchmark sowie die Scality-Laborwerte zu 189 GB KV-Cache und einer 14- bis 72-fachen Beschleunigung habe ich nicht unabhängig bestätigt. Ich kann das nicht überprüfen. Die folgenden Ergänzungen trennen diese Prognosen von recherchierten Anbieterangaben und redaktionellen Empfehlungen. Recherchestand: 2. November 2026.
Management Summary, Tipps, FAQ und Bilder wurden mit Hilfe von KI erstellt
8485 Artikel zu „KI Infrastruktur“
Ausgabe 9-10-2026 | Infrastruktur | IT-Security | Künstliche Intelligenz | News | Rechenzentrum | Security Spezial 9-10-2026 | Strategien
Sovereign AI: KI-Infrastruktur, Datenkontrolle und digitale Souveränität – Souveränität entscheidet sich im Stack

KI verschiebt sensible Daten über Clouds, Rechenzentren und Edge-Systeme hinweg. Warum echte Sovereign AI mehr verlangt als einen europäischen Speicherort – und wie Unternehmen Kontrolle, Sicherheit und Resilienz über den gesamten Infrastruktur-Stack herstellen.
Infrastruktur | Künstliche Intelligenz | News | Produktmeldung | Rechenzentrum
Vom KI-Piloten zum Produktivbetrieb: Die Infrastruktur entscheidet mit
Ein KI-Pilot ist noch kein belastbarer Produktionsbetrieb. Sobald Anwendungen dauerhaft genutzt werden, gehören Stromversorgung, Kühlung, Netzwerkanbindung und Betriebsverantwortung auf die Entscheidungsagenda. Ein neuer Infrastrukturleitfaden setzt deshalb beim einzelnen Workload an – statt bei einer pauschalen Entscheidung für Cloud oder eigenes Rechenzentrum. Für die Unternehmensführung lautet die Aufgabe: Geschäftsziel, Standortfähigkeit und laufende Kosten gemeinsam bewerten. [1][2][3]…
Effizienz | Favoriten der Redaktion | Infrastruktur | Nachhaltigkeit | News | Rechenzentrum
KI-Infrastruktur: Rechenzentren zwischen Leistungsdichte, Kühlung und Nachhaltigkeit
KI-Workloads verschieben die Prioritäten im Rechenzentrumsdesign: Entscheidend sind nicht mehr nur Fläche und klassische Skalierung, sondern verfügbare Energie, hohe Leistungsdichten, hybride Kühlung, kurze Bereitstellungszeiten und eine belastbare ESG-Strategie. Das Interview mit Claudius Kirmse von Vertiv zeigt, warum Betreiber Infrastruktur künftig stärker als integrierte Plattform aus Stromversorgung, Kühlung, Steuerung und Standortstrategie denken müssen. Management Summary KI…
Effizienz | Favoriten der Redaktion | Infrastruktur | Künstliche Intelligenz | News | Produktmeldung | Rechenzentrum
Fujitsu stellt die CPU der nächsten Generation »FUJITSU-MONAKA« sowie den »Fujitsu MONAKA-Server« für eine souveräne KI-Infrastruktur vor
Mit FUJITSU-MONAKA positioniert Fujitsu eine in Japan entwickelte CPU samt Serverplattform als Baustein für souveräne, energieeffiziente KI-Infrastrukturen. Im Fokus stehen hohe KI-Inferenzleistung, transparente Lieferketten, Confidential Computing und der Betrieb auch in Rechenzentren mit begrenzten Energie- und Kühlressourcen. Management Summary Souveräne KI braucht eigene Infrastruktur. Fujitsu adressiert mit MONAKA den wachsenden Bedarf nach nachvollziehbaren Lieferketten, lokaler…
Business Process Management | Digitale Transformation | Effizienz | Favoriten der Redaktion | Infrastruktur | Internet der Dinge | IT-Security | Künstliche Intelligenz | New Work | News | Services
Physische KI bis 2030: Wie Roboter, autonome Systeme und resiliente IoT-Infrastrukturen die operative Arbeit verändern
Physische KI wird bis 2030 zu einem strategischen Hebel für Produktivität, Resilienz und Arbeitssicherheit. Unternehmen müssen jetzt klären, welche operativen Prozesse sich durch intelligente Maschinen, autonome Systeme und vernetzte Sensorik neu gestalten lassen – und welche Governance dafür nötig ist. Physische KI wird operativ: KI-Systeme verlassen die reine Daten- und Textverarbeitung und greifen über Roboter,…
Ausgabe 7-8-2026 | Infrastruktur | Künstliche Intelligenz | News | Strategien
KI-Strategie geplant? Diese sechs Infrastrukturfragen sollten Unternehmen zuerst beantworten – Glasfaser als Infrastruktur-Fundament für KI- und Cloud
KI verändert Geschäftsmodelle rasant – doch ihr Erfolg entscheidet sich oft an einer unscheinbaren Stelle: der Netzinfrastruktur. Wer Cloud, Datenanalyse und Automatisierung skalieren will, braucht mehr als schnelle Software; er braucht ein belastbares digitales Fundament. Glasfaser wird damit vom technischen Detail zum strategischen Hebel für Wettbewerbsfähigkeit.
Ausgabe 7-8-2026 | Infrastruktur | Künstliche Intelligenz | Lösungen | News | Rechenzentrum
Hochverdichtete KI-Infrastrukturen – »KI-Rechenzentren müssen schneller, modularer und intelligenter werden «

Der KI-Boom stellt Rechenzentren vor eine doppelte Herausforderung: Rechenleistung muss in immer kürzerer Zeit verfügbar sein, zugleich steigen Leistungsdichte, Kühlbedarf und Komplexität im Betrieb. Darren Cox, General Manager für Europa bei KAYTUS, erläutert im Interview mit »manage it«, warum vorgefertigte KI-Fabriken, Flüssigkeitskühlung und ein durchgängiges Infrastrukturmanagement zum neuen Standard werden könnten – und welche Rolle der DACH-Markt in der europäischen Expansion spielt.
Infrastruktur | News | Rechenzentrum
Vorgefertigte KI-Infrastruktur im Gigawatt-Maßstab: KAYTUS revolutioniert das Design von Rechenzentren
Da sich die Einführung von KI in ganz Europa beschleunigt, wächst die Nachfrage nach Hochleistungs-Recheninfrastruktur in beispiellosem Tempo. Dennoch stehen viele Nutzer vor derselben Herausforderung: Aufgrund der komplexen Planung, Bereitstellung und Wartung neuer KI-Rechenzentren können herkömmliche Rechenzentrumsmodelle die hohen Anforderungen an Rechen- und Kühlkapazität sowie an die übrige IT-Infrastruktur nicht mehr erfüllen. Mit seiner vollständig…
Effizienz | Infrastruktur | Künstliche Intelligenz | News | Rechenzentrum | TechTalk
TechTalk: Interview mit Darren Cox – High Performance für KI-Infrastruktur und den Bau von KI-Rechenzentren
Anlässlich der ISC High Performance 2026 sprachen wir mit Darren Cox, dem Geschäftsführer von KAYTUS Europe, darüber, wie KI-Infrastruktur schnell, energieeffizient – und damit kostengünstig – gebaut und betrieben werden kann.
Infrastruktur | Künstliche Intelligenz | News | Trends 2026 | Trends Infrastruktur
KI-Wachstum stockt: Der Grund dafür ist die fehlende Infrastruktur
Das größte Hindernis für die Skalierung von KI sind nicht fehlende Investitionen, sondern Defizite der für den Betrieb nötigen Infrastruktur. In vielen Unternehmen fehlen die nötigen Echtzeitdaten für den weiteren Ausbau von KI. Das bestätigen 70 % der deutschen IT-Führungskräfte im neuen Data Streaming Report 2026 von Confluent [1]. Für den Bericht wurden weltweit…
Business Process Management | Cloud Computing | Effizienz | Infrastruktur | Künstliche Intelligenz | News | Rechenzentrum
Globaler Namespace: Infrastruktur allein löst die Fragmentierung von KI-Daten nicht
KI scheitert in Unternehmen häufig nicht an mangelnder Infrastrukturleistung, sondern an fragmentierten Daten über Silos, Clouds, Regionen und operative Domänen hinweg. Agentische KI verschärft dieses Problem, weil autonome Systeme Daten in Echtzeit über verschiedene Umgebungen hinweg nutzen, interpretieren und für Entscheidungen operationalisieren. Ein moderner globaler Namespace entwickelt sich damit von einer Storage-Abstraktion zu einer einheitlichen…
Digitale Transformation | Infrastruktur | Künstliche Intelligenz | News | Rechenzentrum | Tipps
Wenn die IT-Infrastruktur die KI ausbremst: So beseitigen Unternehmen die größten Engpässe

Datenzugriff wird zum zentralen Flaschenhals, weil Datensilos und veraltete Speichersysteme nicht den Durchsatz liefern, den moderne KI‑Modelle für Training und Inferenz benötigen. Rechenressourcen geraten unter Druck, da KI‑Workloads mit bestehenden Geschäftsanwendungen konkurrieren und ohne beschleunigte Infrastruktur keine Echtzeit‑Analysen oder autonomen Prozesse möglich sind. Netzwerke erzeugen Engpässe, wenn Bandbreite, Latenz und Stabilität nicht ausreichen, um große…
Cloud Computing | Favoriten der Redaktion | Infrastruktur | Künstliche Intelligenz | News | Rechenzentrum | Strategien
Cloud-Rückführung: Optimierung der Infrastruktur für KI im großen Maßstab

Cloud‑Rückführung ist kein Rückzug aus der Public Cloud, sondern eine strategische Neuausrichtung hin zu optimierten Hybrid‑ und On‑Prem‑Architekturen, um KI im großen Maßstab effizient zu betreiben. Bei der Skalierung von KI erweisen sich Daten‑ und Speicherinfrastrukturen zunehmend als kritische Engpässe – oft ebenso relevant wie die Verfügbarkeit von GPUs. Insbesondere Objektspeicher spielt dabei eine…
Cloud Computing | Geschäftsprozesse | Infrastruktur | Künstliche Intelligenz | News | Services | Strategien
Enterprise-KI auf souveräner Cloud-Infrastruktur: Modelloffene Ansätze für regulierte Umgebungen
Der Einsatz generativer künstlicher Intelligenz (KI) in Unternehmen gewinnt zunehmend an Bedeutung. Gleichzeitig stehen Organisationen – insbesondere in Europa – vor der Herausforderung, Anforderungen an Datenschutz, regulatorische Konformität und technologische Unabhängigkeit mit dem Wunsch nach innovativen KI-Anwendungen zu vereinbaren. Vor diesem Hintergrund rücken modelloffene Plattformen und souveräne Cloud-Infrastrukturen verstärkt in den Fokus. Ein aktuelles…
Favoriten der Redaktion | Infrastruktur | IT-Security | Künstliche Intelligenz | News
Vorbereitung auf offensive KI: Neue Anforderungen an die Sicherheitsbewertung von IT‑Infrastrukturen
Die rasante Entwicklung offensiver künstlicher Intelligenz verändert die Bedrohungslandschaft für Unternehmen grundlegend. Autonome Systeme sind inzwischen in der Lage, digitale Umgebungen selbstständig zu analysieren, Schwachstellen zu identifizieren und Exploits nahezu ohne menschliches Zutun zu entwickeln. Dadurch verkürzen sich Entwicklungs- und Angriffszyklen erheblich – von ehemals Monaten auf teilweise nur noch wenige Tage. Klassische Sicherheitsansätze geraten…
Digitale Transformation | Effizienz | Infrastruktur | News | Produktmeldung | Rechenzentrum
Vertiv industrialisiert KI-Bereitstellung mit digital orchestrierter Infrastruktur

Die werkseitig integrierte, digital validierte Infrastruktur Vertiv OneCore reduziert die Komplexität der Bereitstellung vor Ort und beschleunigt die Termintreue trotz immer strengerer Bauauflagen. Vertiv industrialisiert die KI-Bereitstellung und kooperiert für bessere Skalierbarkeit mit Hut 8. Vertiv, ein weltweit agierender Anbieter für kritische digitale Infrastrukturen, gibt eine bedeutende Weiterentwicklung im Bereich der Bereitstellung von Rechenzentren…
Cloud Computing | Favoriten der Redaktion | Infrastruktur | IT-Security | Künstliche Intelligenz | News | Rechenzentrum | Strategien
Souveräne KI braucht souveräne Infrastruktur
Wie Betreibermodelle die Lücke zwischen Innovation und Kontrolle schließen. Künstliche Intelligenz ist ein entscheidender Wettbewerbsfaktor, aber die Nutzung von Public-Cloud-Modellen birgt für regulierte Branchen und Unternehmen mit sensiblen Daten erhebliche Risiken. Die Lösung liegt in hybriden Ansätzen, die physische Kontrolle mit professionellem Betrieb verbinden und so den Weg für eine sichere, souveräne KI-Nutzung ebnen. …
Business | Favoriten der Redaktion | Geschäftsprozesse | Infrastruktur | IT-Security | Künstliche Intelligenz | News | Services | Trends 2026 | Trends 2028
Bis 2028 wird fehlkonfigurierte KI die kritische Infrastruktur eines G20-Staates lahmlegen
Ein sicherer Übersteuerungsmechanismus in KI-Systemen, die nationale kritische Infrastrukturen unterstützen, ist unerlässlich, um die letztendliche Kontrolle durch den Menschen sicherzustellen. Gartner, Inc., ein Unternehmen für Geschäfts- und Technologieanalysen, prognostiziert, dass bis 2028 eine fehlkonfigurierte KI in cyber-physischen Systemen (CPS) die kritische Infrastruktur eines G20-Landes zum Erliegen bringen wird. Gartner definiert cyber-physische Systeme (CPS)…
Digitalisierung | Infrastruktur | News | Rechenzentrum | Services | Whitepaper
Netzwerkinfrastrukturmanagement: Fünf Best Practices, um operative Exzellenz im Netzbetrieb zu erreichen

Das effektive Management ihrer Netzwerkinfrastruktur ist für lokale sowie globale Telekommunikationsanbieter oder Data-Center-Betreiber zu einem kritischen Business-Faktor geworden. Besonders nach vielen Akquisitionen oder vor dem Hintergrund ambitionierter Wachstumspläne sind sie gefordert, ihre Strategien neu zu bewerten, um ihre meist (zu) komplex gewordene Infrastruktur effektiv steuern, skalieren und zukunftssicher aufstellen zu können. Mit den richtigen Ansätzen…
Cloud Computing | Infrastruktur | News | Rechenzentrum | Trends 2025 | Trends Cloud Computing
Cloud-Infrastrukturdienste: Keine wolkigen Umsätze
Rund 107 Milliarden US-Dollar Umsatz wurden laut Synergy Research Group im dritten Quartal 2025 mit Cloud-Infrastrukturdiensten erwirtschaftet. Hochgerechnet könnte das Marktvolumen für das Gesamtjahr auf etwa 413 Milliarden US-Dollar steigen – das entspräche einem Plus von 25 Prozent. Zum Vergleich: 2017 waren es noch weniger als 50 Milliarden US-Dollar. Dabei hatte sich das Wachstum bis…