Nicht der nächste Modellrekord entscheidet allein über den Unternehmenserfolg mit KI. Arvind Narayanan und Sayash Kapoor betrachten künstliche Intelligenz als transformative, aber gesellschaftlich eingebettete Technologie. Ihr Ansatz richtet den Blick auf Einführung, Organisation und Kontrolle statt auf eine vermeintlich zwangsläufige Superintelligenz. Für Entscheider ergibt sich daraus eine nüchterne Leitfrage: Wie wird aus technischer Leistungsfähigkeit ein belastbarer Nutzen – mit klaren Zuständigkeiten und überprüfbaren Einsatzgrenzen? Diese redaktionelle Einordnung stützt sich auf den Essay und das NIST-Risikomanagementmodell. [1][2]
Management Summary
- Leistung ist nicht Wirkung. Narayanan und Kapoor unterscheiden zwischen KI-Methoden, Anwendungen und ihrer tatsächlichen Verbreitung. Ihre These: Technischer Fortschritt und wirtschaftliche Transformation folgen unterschiedlichen Zeitmaßstäben. [1]
- Produktivitätswerte brauchen Kontext. Die 2025 veröffentlichte Untersuchung »Generative AI at Work« berichtet im untersuchten Kundensupport einen durchschnittlichen Zuwachs von 15 Prozent bei gelösten Fällen pro Stunde. Das ist ein Ergebnis für diesen Einsatzkontext, keine pauschale Renditeprognose für Unternehmen. [3]
- Governance gehört in den Betrieb. Als redaktionelle Ableitung aus dem NIST AI RMF sollten Entscheider Zuständigkeiten, Prüfungen und laufende Überwachung als Teil der Einführung behandeln – nicht als nachträgliches Zusatzprojekt. [2][4]
- KI-Kompetenz umfasst mehr als Bedienung. Die Definition der EU-Kommission verbindet Kenntnisse und Verständnis mit informierter Nutzung sowie dem Bewusstsein für Chancen, Risiken und mögliche Schäden. [5]
- Infrastruktur mitdenken. Der IEA-Bericht »Energy and AI« untersucht Strombedarf, Energieversorgung und die Wechselwirkungen zwischen KI und Energiesystem. Daraus folgt als Management-Empfehlung, Kapazität und Ressourcenbedarf neben Modellleistung und Lizenzkosten zu prüfen. [6]
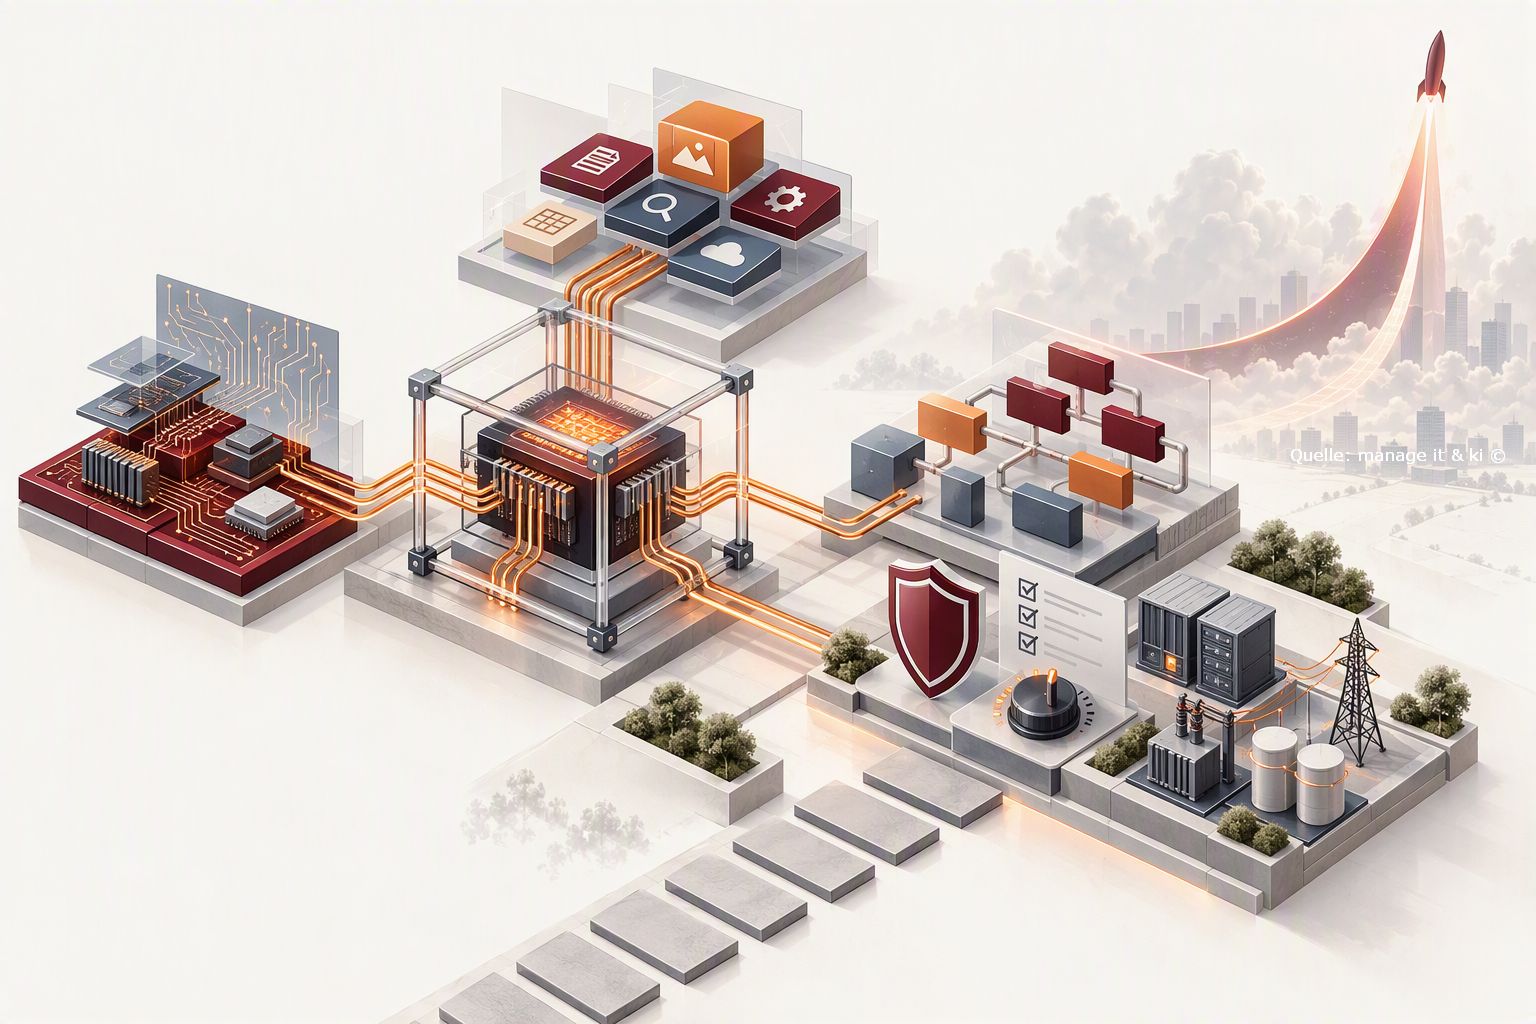
Illustration Absmeier foto ki designer
KI-generierte Symbolillustration: Modellleistung, Anwendungen und betriebliche Einführung stehen neben Kontrolle, Sicherheitsprüfung und Energieinfrastruktur.
Arvind Narayanan und Sayash Kapoor: Artificial Intelligence (AI) als normale Technologie und als eventuelle Gefahr
Arvind Narayanan, Professor für Informatik in Princeton, und sein Co-Autor Sayash Kapoor haben einen längeren Artikel zu den Grundprinzipien der Artificial Intelligence (AI) verfasst: »AI as Normal Technology« (www.normaltech.ai/p/ai-as-normal-technology) In ihrer Veröffentlichung legen Arvind und Sayash eine alternative Vision von AI dar. Sie betrachten AI nicht als drohende Superintelligenz, die außer Kontrolle geraten und die Menschheit in neue Richtungen zwingen könnte, sondern als eine moderne Technologie wie jede andere – zum Beispiel wie Elektrizität, das Internet oder den PC. Es hat immer Jahre oder sogar Jahrzehnte gedauert, bis sich diese Technologien in der modernen Welt vollständig durchgesetzt haben.
Die Autoren gehen darüber hinaus weiteren Fragestellungen nach: Welche Bedingungen in Organisationen, Gesellschaften oder Staaten verhindern eine schnellere Verbreitung von neuen Technologien? Warum ist es wahrscheinlich, dass sich dieselbe historische Dynamik auch beim Beispiel AI wiederholt? Und was bedeutet es, dass AI erst in Jahrzehnten, statt in wenigen Monaten, in superintelligenter Form auftreten könnte?
Eine Gegenposition zu rasanten Durchbruchsszenarien
Mit diesem alternativen Ansatz wird eine ganz andere, gegensächliche Sichtweise als die der großen AI-Labore aus dem Silicon Valley und anderen Standorten der IT vorgeschlagen. Viele Mitarbeiter der IT-Industrie und andere Fachleute glauben eher an einen kurz bevorstehenden, rasanten Durchbruch der neuen Technologie, bei dem sich AI-Systeme beständig selbst verbessern und zu immer neueren AI-Systemen entwickeln könnten. Arvind und Sayash argumentieren gegen solche Annahmen und Vermutungen: Moment mal, so funktioniert das alles nicht ….
Narayanan und Kapoor gehören allerdings nicht zu jenen Skeptikern, die behaupten, AI sei nur ein Hype, nicht leistungsstark genug oder ungeeignet für die Lösung theoretischer und praktischer Fragestellungen. Sie glauben auch nicht, dass sich die Fähigkeiten von AI in absehbarer Zeit nicht weiter verbessern werden. Sie gehören nicht zu denen, die behaupten, Deep Learning zum Beispiel stoße bereits an seine Grenzen. Die Autoren glauben, Deep Learning werde immer leistungsfähiger werden. Und sie sind der Ansicht, dass die Auswirkungen davon ganz anders sind als bisher angenommen. Es gehe insbesondere darum, dass AI eine normale Technologie wie viele andere und keine verrückte Superintelligenz ist.
Engpässe und Infrastruktur als Bremsfaktoren
Die beiden Autoren argumentieren, dass es im Wesentlichen viele Engpässe geben wird, die auf lange Sicht verhindern werden, dass AI in der gesamten Gesellschaft generell eingeführt wird. Es werde auch nicht so schnell zu dem super-rasanten und anhaltenden wirtschaftlichen Aufschwung für einzelne Unternehmen und die ganze Region kommen, den viele IT-Firmen in San Francisco schon bald vorhersehen.
Arvind Narayanan geht davon aus, dass die aktuellen Gegenreaktionen ein echtes Hindernis für den AI-Fortschritt sein können, wobei es für Rechenzentren eine besondere Reaktion gibt. Es ist zum Beispiel damit zu rechnen, wenn sich AI gegen Regierungen oder andere besondere Entscheidungsträger richten könnte, die eine solche Technologie für besondere Prozesse verwenden. Narayanan geht davon aus, dass solche Angriffe viel größere Auswirkungen hätten: »Vielleicht sehen wir einiges von solchen Aktionen, aber das meiste davon ist auf einige Rechenzentren ausgerichtet. Eine Gesellschaft oder ein Staat sollten sich wehren, wenn besondere Probleme wegen Lärmbelästigung, Wasser- oder anderen lokalen Umweltproblemen auftreten. Aber wenn man generell das Tempo reduzieren möchte, mit dem sich diese neuen AI-Technologien entwickeln, ist die Konzentration auf Rechenzentren meiner Meinung nach nicht der richtige Weg.«
Der Verzicht auf den Bau von weiteren Rechenzentren besonders in den USA würde den AI-Fortschritt verlangsamen. Im Moment geht man generell noch davon aus, dass man immer größere Modelle trainieren müsse, um AI für weitere Anwendungen und Prozesse vorzubereiten und einzusetzen. Das bedeutet, permanent leistungsfähige Rechenzentren zu bauen, die diese Modelle vorbereiten und ausprobieren können.
Die Autoren von »Hard Fork« Kevin Roose und Casey Newton schätzen an der Arbeit der beiden Forscher besonders, dass sie nicht zu den üblichen Skeptikern gehören, die behaupten, AI sei nur ein Hype und nicht leistungsstark genug. Sie gehören nicht zu denen, die behaupten, Deep Learning stoße schon an seine Grenzen. Stattdessen gehen sie davon aus, dass sich die meisten neuen Technologien relativ schnell verbessern werden. Sie sind allerdings auch der Meinung, dass die Auswirkungen von AI anders aussehen werden als bisher allgemein angenommen. Und das sei eine viel intelligentere und differenziertere Art von AI-Skepsis als jene, die sich in vielen Medien bereits als Schreckgespenst verbreitet hat. AI sei eine normale Technologie und keine verrückte Superintelligenz, die nur von einigen Unternehmen entwickelt und gefördert werde.
Um was es bei AI wirklich geht
Eine der zentralen Thesen des Artikels »AI as Normal Technology«, den Narayanan und Kapoor gemeinsam verfasst haben, besteht darin, dass der oft vermutete schnelle Fortschritt im Bereich der AI noch nicht so bald eintreten wird. Die allgemeine Verbreitung von AI in Wirtschaft und Gesellschaft werde langsamer verlaufen, als vielfach angenommen wird. Trotz einiger neuer Erkenntnisse werde man in den kommenden Jahren noch keine dramatischen Veränderungen erleben. Allerdings scheint die Verbreitung von AI im historischen Vergleich mit anderen neuen Technologien auch sehr schnell zu verlaufen. ChatGPT zum Beispiel ist noch nicht einmal drei Jahre alt und hat bereits rund 500 Millionen Anwender. Und etwa 40 Prozent der Erwachsenen in den USA verwenden generative AI, die es vor wenigen Jahren nur in Ansätzen gab. Diese Entwicklung verläuft im Prinzip deutlich schneller als die Verbreitung früherer Technologien.
Nutzerzahlen und Nutzungsintensität unterscheiden
Narayanan steht der wachsenden Beliebtheit und weiteren Verbreitung dieser neuen Anwendungen skeptisch gegenüber. Seiner Einschätzung nach wird es noch lange dauern, bis sich die neuen AI-Technologien in den modernen Gesellschaften durchgesetzt haben. Er führt aus: »Wir sind der Ansicht, dass die Technologieakzeptanz von AI nicht so schnell voranschreitet, wie vielfach behauptet wird. Wir kennen die Aussage, dass bereits 40 Prozent der Erwachsenen in den USA generative AI verwenden sollen. Wir haben diese Studie in unserem Essay besprochen. Und wir haben keine grundsätzlichen Einwände gegen die Methodik oder die Zahlen der Studie, aber nach unserer Interpretation wird lediglich die reine Anzahl der Anwender betrachtet. Es wird aber nicht zwischen jemandem unterschieden, der die neue Technologie intensiv verwendet und in seinem Beruf auf sie angewiesen ist, und jemandem, der ChatGPT einmal pro Woche verwendet, um beispielsweise ein Limerick zu generieren.«
Die Studie der beiden Autoren geht auf die Nutzungsintensität ein. Wenn man ihrer Argumentation folgt, entspricht das etwa einer Stunde pro Arbeitswoche und einem Produktivitätszuwachs von nur einem Bruchteil eines Prozentpunkts. Das ist dann tatsächlich nicht schneller als beispielsweise die Verbreitung von PCs vor 40 Jahren.
Autonome Entwicklung und die Grenzen der Kontrolle
Kevin Roose von »Hard Fork« verweist darauf, dass Narayanan und Kapoor nicht direkt auf eine andere Veröffentlichung reagiert haben, aber er geht von einer Parallelität zu einer etwa zeitgleich publizierten Studie aus: Daniel Kokotajlo vom »AI Futures Project« (https://blog.aifutures.org/; publiziert bei Substack) hat das vergangene Jahr damit verbracht, ein Szenario zu entwerfen, wie die Welt seiner Meinung nach in den nächsten Jahren aussehen wird. Ein Teil seiner These besteht darin, dass man bald autonome Programmieragenten einsetzen wird, die die Arbeit in der AI-Forschung und -Entwicklung automatisieren werden. Und diese Entwicklung soll bald den Entstehungsprozess von immer leistungsfähigeren AI-Systemen dramatisch beschleunigen.
Für Narayanan sind hochleistungsfähige IT-Systeme und neue AI-Ansätze nicht gleichbedeutend. Sie unterscheiden sich sogar deutlich voneinander. Die AI-Fähigkeiten hätten sich bereits rasant verbessert. Und durch den Einsatz von AI selbst für die weitere Entwicklung von AI-Ansätzen sei diese Entwicklung noch weiter beschleunigt worden: »Für uns bedeutet das jedoch nicht, dass diese AI-Systeme prinzipiell immer leistungsfähiger werden. Ein solches Potential ist nicht eine Eigenschaft des AI-Systems allein. Es handelt sich um eine Eigenschaft sowohl des AI-Systems als auch der Umgebung, in der es eingesetzt wird. Und diese Umgebung liegt in der Hand der Anwender. Man darf diesen AI-Systemen nicht immer automatisch mehr Kontrolle und Autonomie übertragen. In unserer Studie analysieren wir ausführlich, warum der unkontrollierte Einsatz von AI-Systemen in den meisten Fällen wirtschaftlich nicht sinnvoll ist, verglichen mit den Vorteilen, die er mit sich bringt.«
Was die Fahrzeugsicherheit über Verantwortung lehrt
Narayanan ist auch der Frage nachgegangen, ob es bestimmte organisatorische Hürden in Unternehmen und Systemen gibt, die die Verbreitung von Technologien verlangsamen können. Auf diesem Teilbereich könne man noch viel von der Geschichte früherer Technologien lernen. Aus der Geschichte der ersten Automobile weiß man zum Beispiel, dass die Fahrzeugsicherheit nicht in der Verantwortung der Hersteller lag, sondern dass diese Thematik fast komplett in die Verantwortung der Benutzer, Fahrer und Eigentümer verschoben wurde. Erst später kam es zu einem Mentalitätswandel und die Fahrzeugsicherheit wurde als eine Frage der Verantwortung der Autohersteller erkannt. Es galt dann als wirtschaftlich nicht mehr sinnvoll, Fahrzeuge mit mangelhafter Sicherheitstechnik zu entwickeln: Unfälle mit diesen Fahrzeugen wurden nicht mehr auf die Fähigkeiten der Fahrer oder Besitzer abgeschoben, sondern man erkannte, dass die Problematik den Herstellern anzulasten war und außerdem negative PR-Folgen für die Hersteller nach sich zog. Die Sicherheit der Autos wurde dann zu einem bedeutenden Wettbewerbsfaktor für die Hersteller.
Für Narayanan lassen sich eine solche Problematik und ein solcher Mentalitätswandel auch für den AI-Bereich feststellen. Das Thema Sicherheit der Systeme sei heute in den Köpfen der meisten Menschen untrennbar mit AI verbunden. Das ist laut Narayanan eine positive Entwicklung. Darüber hinaus können die negativen Sicherheitsfolgen eindeutig den verantwortlichen Herstellern und den IT-Praktikern zugeordnet werden. Mit entsprechenden Regulierungen ließen sich dann Standards und Verantwortliche festlegen. Es komme deshalb darauf an, die Verantwortlichkeiten klar zu definieren. Das alles sei machbar. Wenn man das richtig und konsequent angehe, könnten Unternehmen die AI-Systeme nicht mehr unkontrolliert und ohne Systemgrenzen einsetzen, wie es heute noch vielfach der Fall sei.
Narayanan verweist zum Beispiel auf die unterschiedlichen Verfahren bei »Waymo« und »Cruise«, zwei Herstellern im Bereich von selbstfahrenden Autos. Waymo kann eine sehr gute Sicherheitsbilanz aufweisen, während bei Cruise in San Francisco ein Aufsehen erregender Unfall passierte und der Hersteller gezwungen war, seine Robotaxis aus der Stadt abzuziehen und den Betrieb praktisch einzustellen.
Für sichere Systeme sorgen
Heute scheint die Logik von AI oft darin zu bestehen, dass Unternehmen mit sicheren Produkten ihre Konkurrenten mit unsicheren Produkten vom Markt verdrängen werden. Vielleicht ist das sogar eine Art von modernem Mechanismus mit Selbstkorrekturen: Alle Arten von unsicheren Produkten werden früher oder später aussortiert. Oft tritt jedoch laut Narayanan auch das Gegenteil ein: Die Sicherheitsstandards entwickeln sich mit zunehmender Leistungsfähigkeit der Technologie manchmal gerade in die entgegengesetzte Richtung. Die britische »Financial Times« berichtete zum Beispiel vor einiger Zeit, dass »OpenAI« heute seinen Testern für Security vor der Veröffentlichung ihrer Modelle weniger Zeit und Ressourcen zur Verfügung stellt, als das bisher der Fall war: Ökonomische Zwänge der Konkurrenz am Markt führen immer häufiger dazu, neue Modelle immer schneller auf den Markt zu bringen und der Konkurrenz einen Schritt voraus zu sein.
Narayanan glaubt nicht an eine Art von »Selbstkorrektur« des Marktes. Seines Erachtens bedarf es kontinuierlicher Anstrengungen der Gesellschaft, die Märkte zu kontrollieren. Hierbei komme auch dem Journalismus eine wichtige Rolle zu – neben staatlichen Regulierungen. Und Sicherheitstests im Bereich von AI müssten grundsätzlich vor der Veröffentlichung von neuen Modellen durchgeführt werden. Bei früheren Technologien in der IT sei das nicht immer erforderlich gewesen.
Verantwortung beim Einsatz und Grenzen der Autonomie
Viele Sicherheitsbedenken treten heute eher in der Implementierungs- als in der Entwicklungsphase auf, sagt Narayanan. Und obwohl Modellentwickler eine große Verantwortung tragen würden, müssten sich auch die Anwender ihrer Verantwortung bewusst sein: Nur so ließe sich eine mehrschichtige Verteidigungslinie aufbauen. Mehrere Gruppen sind dann neben- und nacheinander für die Sicherheit verantwortlich. Derzeit liege der Fokus noch sehr stark auf den Entwicklern und zu wenig auf den Anwendern: »Das sollte sich ändern.«
Insgesamt ist bereits eine Kausalkette entstanden, die dazu führt, dass AI-Systeme immer leistungsfähiger werden. Sobald man über solche extrem leistungsstarken Systeme verfügt, muss man laut Narayanan auch sicherstellen, dass sie mit menschlichen und gesellschaftlichen Werten im Einklang stehen. Wenn sie nicht kooperationsfähig seien, könnte die Technologie außer Kontrolle geraten und katastrophale Folgen für die Menschheit haben. (Siehe auch die jüngsten Warnungen, wie sie Dario Amadei von »Anthropic« ausgesprochen hat: »What Anthropic’s C.E.O. Argued in His Call for Slower A.I. Development«: »New York Times« vom 13. September 2026: www.nytimes.com/2026/09/13/technology/anthropic-ceo-slower-ai-development.html )
Narayanan fordert: »Man muss die Bremse ziehen, wenn es nur noch um die Leistungssteigerungen der IT und die Annahme geht, AI könne mittlerweile mehr als Menschen leisten. Und man bräuchte keine menschliche Unterstützung mehr, sondern immer mehr könne von der AI erledigen werden. Wir bei »Normal Tech« glauben, dass wir hier Einfluss nehmen können. Das ist zumindest unsere Prognose. In unserer Studie erläutern wir, warum wir das für möglich halten und was man tun kann.«
In einem weiteren grundsätzlichen Artikel der »New York Times« heißt es: »Diejenigen, die AI entwickeln und regulieren, spalten sich zunehmend in zwei Lager: Jene, die die Entwicklung der Technologie verlangsamen und regulieren wollen, und jene, die sie unbedingt beschleunigen wollen. Andere können sich noch nicht für eines der beiden Lager entscheiden.« Der Streit hat das Silicon Valley gespalten und viele Führungskräfte der Technologiebranche gegen Präsident Donald Trump aufgebracht, der ihre Forderungen nach einer Verlangsamung strikt zurückgewiesen hat.« (»How A.I. Risks Are Splitting Silicon Valley and Washington«: »New York Times« vom 15. September 2026)
(Siehe auch den Artikel »Why Trump is all-in on AI despite the warnings« vom 16. September 2016 auf der Web-Seite der BBC.)
Fazit
Der Ansatz von Narayanan und Kapoor überzeugt vor allem dort, wo er technische Leistungsfähigkeit, tatsächliche Nutzung und gesellschaftliche Wirkung voneinander trennt. Er lenkt den Blick auf Faktoren, die in zugespitzten Zukunftsszenarien häufig zu kurz kommen: organisatorische Anpassung, Regulierung, Haftung, Infrastruktur, Sicherheitsstandards und menschliche Entscheidungen. Zugleich bleibt offen, ob historische Vergleiche mit Elektrizität, Automobil und PC die hohe Skalierbarkeit und das Entwicklungstempo generativer AI vollständig erfassen. Die Einordnung als »normale Technologie« widerlegt daher weder einen möglichen raschen Fortschritt noch weitreichende Risiken. Sie bietet jedoch ein wichtiges Korrektiv zu Prognosen, die technische Durchbrüche unmittelbar mit wirtschaftlicher Umwälzung oder gesellschaftlichem Kontrollverlust gleichsetzen. Entscheidend ist deshalb weniger die Frage, ob AI außergewöhnlich oder normal ist, sondern unter welchen Regeln, Verantwortlichkeiten und Sicherheitsvorkehrungen sie entwickelt und eingesetzt wird.
 Hartmut Wiehr
Freier Journalist

Ausführliche Tipps mit Praxisbeispielen
[Inference] Die folgenden Ausführungen konkretisieren die sieben redaktionellen Empfehlungen. Alle Praxisbeispiele sind hypothetische Anwendungsszenarien, keine dokumentierten Unternehmensfälle oder nachgewiesenen Erfolgsberichte. Die Quellenverweise beziehen sich auf den fachlichen Rahmen, nicht auf die erfundenen Beispiele. Die Empfehlungen ersetzen keine rechtliche oder technische Einzelfallprüfung.1. Mit dem Prozess beginnen: Erst das Problem, dann das Werkzeug
[Inference] Beginnen Sie mit einem kurzen Prozesssteckbrief: Welche Aufgabe soll unterstützt werden, welche Eingaben werden benötigt und woran wird ein fachlich brauchbares Ergebnis erkannt? Beschreiben Sie den bisherigen Ablauf einschließlich Übergaben und Ausnahmen. Benennen Sie einen Prozesseigner, der Anforderungen und Freigabekriterien festlegt. Wählen Sie anschließend das Werkzeug anhand dieser Anforderungen, statt den Prozess an eine Produktdemonstration anzupassen. Halten Sie auch fest, welche Aufgaben ausdrücklich außerhalb des Einsatzbereichs liegen. Als Arbeitsergebnis empfiehlt sich ein freigegebener Steckbrief mit Ziel, Datenumfang, Zuständigkeit und Bewertungsverfahren. [1][2] [Speculation] Hypothetisches Praxisbeispiel: Ein technischer Kundendienst möchte Anfragen zu freigegebenen Bedienungsanleitungen schneller beantworten. Der Pilot wird auf die Suche nach passenden Textstellen und die Erstellung eines Antwortentwurfs begrenzt. Verbindliche technische Freigaben bleiben außerhalb des Piloten. Der Prozesseigner legt fest, dass jeder Entwurf eine überprüfbare Fundstelle nennen und vor Versand fachlich geprüft werden muss. Bewertet werden passende Fundstellen, Korrekturbedarf und die gesamte Bearbeitungszeit – nicht lediglich die Geschwindigkeit der Texterzeugung.2. Nutzen netto messen: Prüfaufwand und Nacharbeit einrechnen
[Inference] Legen Sie vor dem Pilot eine Ausgangslage anhand vergleichbarer Aufgaben fest. Erfassen Sie für den bisherigen und den unterstützten Ablauf dieselben Größen: Gesamtzeit, fachliche Qualität, Nacharbeit und Aufwand für Kontrolle. Ergänzen Sie Lizenz-, Integrations-, Schulungs- und Betriebskosten, soweit diese im betrachteten Zeitraum anfallen. Trennen Sie einmalige Einführungskosten von laufenden Kosten und machen Sie den Bewertungszeitraum transparent. Eine schneller erzeugte Antwort sollte nicht als voller Zeitgewinn verbucht werden, wenn ihre Prüfung oder Korrektur zusätzliche Arbeit erfordert. Studienwerte dienen als Hintergrund, nicht als Ersatz für die eigene Messung. [3][7] [Speculation] Hypothetisches Praxisbeispiel: Ein internes Dokumentationsteam vergleicht zwei Abläufe für die Erstellung einer FAQ aus freigegebenen Produktinformationen. Im ersten Ablauf wird manuell gearbeitet, im zweiten mit KI-Unterstützung. Für beide werden Recherche, Entwurf, Quellenprüfung und Korrektur getrennt erfasst. Das Team betrachtet zusätzlich unbelegte Aussagen und ausgelassene Informationen. Erst die Gesamtbewertung entscheidet über eine Fortsetzung des Piloten; eine kurze Entwurfszeit allein gilt nicht als Erfolgsnachweis.3. Autonomie begrenzen: Berechtigungen nach Aufgaben vergeben
[Inference] Unterscheiden Sie zwischen Informationszugriff, Erstellung eines Vorschlags und Ausführung einer Aktion. Dokumentieren Sie für jede Stufe die erlaubten Daten, Werkzeuge und Freigaben. Eine fachliche Grenze sollte nach Möglichkeit durch Berechtigungen und überprüfbare Abläufe unterstützt werden, nicht allein durch eine Anweisung im Eingabetext. Benennen Sie Situationen, in denen die Verarbeitung unterbrochen oder an einen Menschen übergeben wird, etwa bei fehlenden Quellen oder einem Zugriff außerhalb des freigegebenen Bereichs. Jede neue Schnittstelle oder zusätzliche Aktionsmöglichkeit sollte eine erneute Bewertung auslösen. Ein Berechtigungs- und Freigabeverzeichnis schafft dafür eine nachvollziehbare Grundlage. [1][4] [Speculation] Hypothetisches Praxisbeispiel: Ein IT-Service-Assistent darf freigegebene Wissensartikel durchsuchen und einen Ticketentwurf erstellen. Er erhält keine Berechtigung, Benutzerkonten zu ändern oder Zugriffsrechte zu vergeben. Eine zuständige Person prüft den Entwurf und führt eine notwendige Änderung im regulären Verfahren aus. Soll der Assistent später Tickets selbstständig weiterleiten, wird diese zusätzliche Aktion separat geprüft und freigegeben.4. Verantwortung klären: Zuständigkeiten vor dem Start festlegen
[Inference] Erstellen Sie eine Zuständigkeitsübersicht für fachliche Anforderungen, technische Integration, Datenfreigabe, Betriebsüberwachung und Vorfallbearbeitung. Unterscheiden Sie dabei ausführende, prüfende und freigebende Aufgaben. Klären Sie, welche Informationen der Anbieter liefert und welche Prüfungen beim einsetzenden Unternehmen liegen. Dokumentieren Sie auch Vertretungen und Eskalationswege: Wer entscheidet bei einer Störung über die Unterbrechung, und wer über die Wiederaufnahme? Die organisatorische Zuordnung ist von der rechtlichen Haftungsbewertung zu unterscheiden. Als Mindestunterlagen empfehlen sich eine Zuständigkeitsübersicht, ein Freigabeprotokoll und ein erreichbarer Meldeweg. [2][4] [Speculation] Hypothetisches Praxisbeispiel: Bei einer internen Wissenssuche verantwortet der Fachbereich die Aktualität der freigegebenen Dokumente. Die IT betreut Zugriffsrechte und Schnittstellen, eine Kontrollfunktion prüft die vorgesehenen Datenkategorien. Bei einer Antwort mit einer nicht mehr gültigen Anleitung meldet die prüfende Person den Fall über einen festgelegten Kanal. Der fachlich Verantwortliche bewertet den Inhalt; die IT kann die betroffene Dokumentquelle bis zur Klärung aus der Suche nehmen. Zuständigkeiten sind damit beschrieben, ohne eine konkrete Haftungsaussage zu treffen.5. Kompetenz aufbauen: Mit echten Aufgaben und klaren Grenzen üben
[Inference] Richten Sie das Lernangebot an der tatsächlich verwendeten Anwendung aus. Behandeln Sie erlaubte Eingaben, Quellenprüfung, fachliche Freigaben und den Umgang mit unklaren Ergebnissen. Nutzen Sie freigegebene Übungsunterlagen und stellen Sie einer brauchbaren Antwort auch einen fehlerhaften oder unvollständigen Entwurf gegenüber. Eine kurze Anleitung sollte erklären, wie ein Ergebnis geprüft, ein Problem gemeldet und auf den bisherigen Ablauf ausgewichen wird. Aktualisieren Sie die Inhalte bei wesentlichen Änderungen der Anwendung. Diese Konkretisierung ist eine redaktionelle Empfehlung zum Kompetenzbegriff der EU-Kommission und kein Nachweis, dass eine bestimmte Schulung sämtliche rechtlichen Anforderungen erfüllt. [5] [Speculation] Hypothetisches Praxisbeispiel: In einer Übung zur Produktkommunikation enthält ein vorbereiteter Antwortentwurf eine zugesicherte Produkteigenschaft, die im freigegebenen Datenblatt nicht belegt ist. Die Teilnehmenden vergleichen den Entwurf mit dem Datenblatt, markieren die fehlende Grundlage und geben die Aussage nicht zur Veröffentlichung frei. Anschließend üben sie den vorgesehenen Meldeweg. Im Mittelpunkt steht die Prüfung eines konkreten Arbeitsergebnisses, nicht die Bewertung einzelner Beschäftigter.6. Laufend testen: Änderungen mit dokumentierten Prüffällen begleiten
[Inference] Stellen Sie eine gepflegte Sammlung von Prüffällen zusammen: typische Aufgaben, mehrdeutige Fragen, fehlende Quellen, veraltete Dokumente und Zugriffsgrenzen. Definieren Sie zu jedem Fall ein erwartetes Verhalten oder nachvollziehbare Bewertungskriterien. Führen Sie die Prüfung vor Einführung und nach relevanten Modell-, Daten- oder Prozessänderungen erneut durch. Halten Sie Versionen, Feststellungen und Freigabeentscheidungen fest. Ergänzen Sie einen alternativen Ablauf für den Fall, dass die Anwendung unterbrochen wird. Ein bestandenes Testpaket ist dabei eine begrenzte Prüfgrundlage, kein Beleg für Fehlerfreiheit in sämtlichen Situationen. [2][4] [Speculation] Hypothetisches Praxisbeispiel: Ein Wissensassistent für interne Arbeitsanleitungen wird nach einer Aktualisierung mit bekannten Fragen geprüft. Die Testfälle umfassen auch eine zurückgezogene Anleitung und eine Frage, zu der keine freigegebene Quelle existiert. Liefert das System dennoch eine unbelegte Handlungsanweisung, wird die Freigabe ausgesetzt. Bis zur erneuten Prüfung erfolgt die Recherche über die bestehende Dokumentensuche. Ergebnisse und betroffene Versionen werden im Prüfprotokoll festgehalten.7. Ressourcen und Abhängigkeiten prüfen: Wechseloptionen praktisch erproben
[Inference] Erfassen Sie, welche Daten, Konfigurationen und Schnittstellen für den Betrieb benötigt werden und in welchen Formaten sie verfügbar sind. Prüfen Sie Export und Wiederverwendung anhand eines begrenzten Tests, statt sich allein auf Produktbeschreibungen zu verlassen. Fragen Sie nach Kapazitätsgrenzen, Preisänderungsmechanismen, Betriebsregionen und verfügbaren Angaben zum Ressourcenbedarf. Bei Energieangaben sollten Messgrundlage und Umfang erkennbar sein; allgemeine Branchenprognosen ersetzen keine Verbrauchsdaten der eigenen Anwendung. Dokumentieren Sie fehlende Informationen ausdrücklich. Ein Wechselplan mit Exporttest und benannten Abhängigkeiten bietet eine Grundlage für die Entscheidung, ohne einen einfachen Anbieterwechsel zu versprechen. [1][6] [Speculation] Hypothetisches Praxisbeispiel: Ein Unternehmen prüft zwei Lösungen für die Suche in freigegebenen Dokumenten. In einem Test werden Dokumente, Metadaten und Konfigurationen exportiert und in einer alternativen Umgebung weiterverwendet. Nicht übertragbare Funktionen und zusätzlicher Integrationsaufwand werden festgehalten. Liefert ein Anbieter keine belastbaren Energieangaben zur vorgesehenen Nutzung, wird dieser Punkt als Informationslücke dokumentiert, nicht durch eine geschätzte Verbrauchszahl ersetzt. Die Entscheidung berücksichtigt anschließend fachliche Qualität, Kosten, Abhängigkeiten und die offenen Fragen.
FAQ: KI als normale Technologie
1. Was bedeutet »KI als normale Technologie«?
Narayanan und Kapoor verstehen KI als Werkzeug, dessen gesellschaftliche Wirkung durch Menschen, Organisationen und Institutionen mitgestaltet wird. »Normal« bedeutet dabei nicht unbedeutend: Auch Elektrizität und Internet gelten in ihrer Konzeption als normale, zugleich transformative Technologien. Der Essay verbindet Beschreibung, Prognose und eine normative Forderung nach menschlicher Kontrolle. [1]
2. Bestreiten die Autoren weitere technische Fortschritte?
Ihr Argument richtet sich gegen die Gleichsetzung von Modellfähigkeiten und gesellschaftlicher Wirkung. Sie unterscheiden ausdrücklich KI-Methoden, Anwendungen und Adoption. Aus einer verbesserten Methode folgt in diesem Rahmen nicht automatisch eine unmittelbar einsatzfähige Anwendung oder deren flächendeckende Einführung. [1]
3. Ist eine langsame Transformation bereits bewiesen?
[Unverified] Wie schnell sich die künftige Transformation vollzieht, kann ich nicht überprüfen. Die Autoren kennzeichnen ihre Erwartungen selbst als unsichere Vorhersagen und quantifizieren keine Eintrittswahrscheinlichkeiten. Ihr Zeithorizont von Jahrzehnten ist somit eine begründete Position des Essays, kein nachgewiesener zukünftiger Verlauf. [1]4. Warum reicht die Nutzerzahl nicht als Erfolgskennzahl?
Eine Nutzerzahl misst zunächst Reichweite, nicht den Nutzen eines Prozesses. Für die betriebliche Bewertung sollten Häufigkeit, Aufgabenanteil, Qualität und tatsächliche Entlastung getrennt erhoben werden. Diese Empfehlung folgt aus der Unterscheidung von Adoption und Wirkung im Essay sowie aus dem Feldexperiment »Shifting Work Patterns with Generative AI«, das individuelle Zeitersparnisse von Veränderungen der Aufgabenstruktur trennt. [1][7]
5. Welche Produktivitätsgewinne sind empirisch belegt?
Die 2025 publizierte Studie »Generative AI at Work« untersuchte 5.172 Kundensupportkräfte und berichtet im Mittel 15 Prozent mehr gelöste Fälle pro Stunde mit KI-Unterstützung. Die Höhe und Art der Effekte variierten innerhalb des untersuchten Kontextes. Das ältere NBER-Working-Paper nennt 14 Prozent bei einer anderen Stichprobenangabe; diese Versionen sollten nicht vermischt werden. Ein allgemeiner Produktivitätswert für sämtliche Tätigkeiten lässt sich daraus nicht ableiten. [3][8]
6. Was gehört zu einem strukturierten KI-Risikomanagement?
Das NIST AI Risk Management Framework bietet einen freiwilligen Rahmen, um Vertrauenswürdigkeit in Entwicklung, Nutzung und Bewertung von KI-Systemen einzubeziehen. Das ergänzende Profil für generative KI unterstützt die Identifikation spezifischer Risiken und entsprechender Maßnahmen. [2][4] Für die Umsetzung im Unternehmen empfiehlt sich daraus ein dokumentierter Zusammenhang zwischen Einsatzkontext, Verantwortlichkeiten, Tests und laufender Überwachung.
7. Wer trägt Verantwortung für den sicheren Einsatz?
Organisatorisch sollte Verantwortung nicht allein beim Modellentwickler liegen. Anbieter, Integratoren und einsetzende Unternehmen sollten ihre jeweiligen Prüf- und Kontrollaufgaben ausdrücklich festlegen. Diese Empfehlung stützt sich auf die lebenszyklusbezogene Perspektive des NIST und den Kontrollansatz des Essays. Sie ist keine Aussage über die rechtliche Haftung in einem konkreten Schadensfall. [1][2][4]
8. Was bedeutet KI-Kompetenz für Unternehmen?
Der AI Act Service Desk der EU-Kommission beschreibt KI-Kompetenz als Kenntnisse, Fähigkeiten und Verständnis für informierten Einsatz und das Bewusstsein für Chancen, Risiken und mögliche Schäden. [5] Ein betriebliches Lernangebot sollte deshalb neben Bedienung auch Bewertung von Ergebnissen, Datenregeln und Grenzen der jeweiligen Anwendung behandeln. Die konkrete rechtliche Verpflichtung ist anhand der geltenden Vorschriften und des Einsatzfalls gesondert zu prüfen.
9. Warum spielt Energie bei der KI-Strategie eine Rolle?
Die IEA untersucht im Bericht »Energy and AI« den Strombedarf von Rechenzentren sowie Versorgung, Energiesicherheit und mögliche Anwendungen von KI im Energiesektor. Der Bericht enthält Szenarien und Projektionen, keine feststehenden zukünftigen Verbrauchswerte. [6] Für Unternehmen spricht das dafür, Verfügbarkeit und Ressourcenbedarf der Infrastruktur in die Lösungswahl einzubeziehen, auch wenn die Rechenleistung extern bezogen wird.
10. Sollten Unternehmen abwarten oder jetzt handeln?
Die redaktionelle Empfehlung lautet: kontrolliert erproben statt pauschal abwarten oder ungeprüft skalieren. Wählen Sie einen klar begrenzten Einsatzfall, definieren Sie Qualitäts- und Abbruchkriterien und erweitern Sie den Betrieb erst nach Auswertung der Ergebnisse. Damit wird die Einführung als organisatorische Lernaufgabe behandelt. Diese Empfehlung verbindet den Normaltechnologie-Ansatz mit dem lebenszyklusbezogenen Risikomanagement des NIST; sie verspricht keinen feststehenden wirtschaftlichen Erfolg. [1][2][4]
Quellen der ergänzten Inhalte
Recherche: 19. Oktober 2026. Die Bezugszeichen gelten für die neu ergänzten Inhalte. Die Quellenangaben und dynamischen Zahlen im bestehenden Artikel wurden nicht vollständig überprüft und bleiben unverändert.
[1] Narayanan, Arvind; Kapoor, Sayash: »AI as Normal Technology«, 15. April 2025, Essay (PDF). https://kfai-documents.s3.amazonaws.com/documents/c3cac5a2a7/AI-as-Normal-Technology—Narayanan—Kapoor.pdf
[2] NIST: AI Risk Management Framework, Überblick zum freiwilligen Rahmen. https://www.nist.gov/itl/ai-risk-management-framework
[3] Brynjolfsson, Erik; Li, Danielle; Raymond, Lindsey: »Generative AI at Work«, The Quarterly Journal of Economics, Mai 2025; Publikationszusammenfassung der Stanford Graduate School of Business. https://www.gsb.stanford.edu/faculty-research/publications/generative-ai-work
[4] NIST: »Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile«, NIST AI 600-1, Juli 2024. https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence
[5] Europäische Kommission, AI Act Service Desk: »What is AI literacy as described in Article 4 of the AI Act?« https://ai-act-service-desk.ec.europa.eu/en/ai-act/faq/what-ai-literacy-described-article-4-ai-act
[6] International Energy Agency: »Energy and AI«, 10. April 2025. https://www.iea.org/reports/energy-and-ai/
[7] Dillon, Eleanor W.; Jaffe, Sonia; Immorlica, Nicole; Stanton, Christopher T.: »Shifting Work Patterns with Generative AI«, NBER Working Paper 33795, Mai 2025, revidiert November 2025. Hinweis auf der Quellenseite: Einige Autoren waren beim Anbieter des untersuchten Werkzeugs beschäftigt. https://www.nber.org/papers/w33795
[8] Brynjolfsson, Erik; Li, Danielle; Raymond, Lindsey R.: »Generative AI at Work«, NBER Working Paper 31161, April 2023, revidiert November 2023; ältere Fassung mit abweichender Schätzung. https://www.nber.org/papers/w31161
Management Summary, Tipps, FAQ und Bild wurden mit Hilfe von KI erstellt
4630 Artikel zu „KI Nutzen Risiko“
Business | Digitalisierung | News | Services | Trends 2018 | Trends Kommunikation | Trends Wirtschaft
Künstliche Intelligenz: Bürger sehen mehr Risiko als Nutzen in KI

Künstliche Intelligenz wird unsere Gesellschaft grundlegend verändern, das steht fest. Ob diese Veränderungen positiv oder negativ sein werden, darüber sind sich die Deutschen nicht einig, wie eine Umfrage von YouGov zeigt. Während 15 Prozent aller Befragten glauben, der Nutzen von KI sei größer als das Risiko, denken immerhin 26 Prozent das Gegenteil. Beinahe die Hälfte…
Digitalisierung | Favoriten der Redaktion | IT-Security | Künstliche Intelligenz | New Work | News | Services | Tipps | Whitepaper
KI nutzen, Risiken beherrschen: künstliche Intelligenz verantwortungsvoll, sicher und rechtssicher einsetzen
Künstliche Intelligenz ist im Unternehmensalltag angekommen. Mit ihrer zunehmenden Verbreitung wachsen jedoch nicht nur die wirtschaftlichen Chancen, sondern auch die rechtlichen, operativen und finanziellen Risiken. Der Bitkom-Leitfaden »Verantwortungsvoller KI-Einsatz: Risiken verstehen, steuern und versichern« zeigt, wie Unternehmen KI-Risiken systematisch erfassen, steuern und teilweise versichern können. Entscheidend ist nicht allein die eingesetzte Technologie. Ausschlaggebend sind…
Business Process Management | Cloud Computing | Geschäftsprozesse | Infrastruktur | IT-Security | Künstliche Intelligenz | News | Rechenzentrum | Services | Strategien | Tipps | Whitepaper
Die Souveränitätslücke: Viele Unternehmen kennen das Risiko, aber nicht ihre Daten

Datensouveränität ist mehr als Datenresidenz: Entscheidend ist, wer auf Daten und KI-Workloads zugreifen, sie kontrollieren und unter welcher Rechtsordnung verarbeiten kann. Der »Global Data Sovereignty Report 2026« zeigt eine deutliche Lücke zwischen Risikobewusstsein und operativer Reife. Für CIOs wird damit die Verbindung von Datenmanagement, Cloud-Beschaffung, Compliance, Sicherheit und KI-Governance zur strategischen Kernaufgabe. Management Summary Strategische…
Digitalisierung | Favoriten der Redaktion | IT-Security | Künstliche Intelligenz | News | Services | Tipps | Trends 2026 | Trends Kommunikation | Trends Mobile
Persönliche KI-Assistenten: Wenn die KI das Smartphone-Ökosystem verlässt

Persönliche KI-Agenten entwickeln sich vom dialogorientierten Assistenten zum handelnden digitalen Stellvertreter. Metas Muse zeigt, wie Cloud-Agenten Einkäufe, Buchungen und länger laufende Aufgaben übernehmen können – unabhängig vom verwendeten Smartphone. Für Apple, Google und Samsung geht es damit nicht nur um neue Funktionen, sondern um die Kontrolle über Kundenzugang, Datenströme und Transaktionen. Bild: Persönliche KI-Agenten lösen…
Business Process Management | Digitalisierung | Infrastruktur | Künstliche Intelligenz | Logistik | News | Produktmeldung | Tipps
Digitale Mitarbeiter im Fulfillment: Wie KI-Agenten den Lagerbetrieb unterstützen sollen
Mit Fulfillment Flow will IFS Softeon kontextbezogene KI direkt in die operative Lagersteuerung integrieren. Spezialisierte KI-Agenten beobachten einzelne Prozessbereiche, führen ihre Erkenntnisse in einer zentralen Instanz zusammen und schlagen nächste Maßnahmen vor. Die Entscheidungshoheit bleibt beim Lagerleiter. Damit adressiert der Anbieter ein Kernproblem vieler Automatisierungsprojekte: Lokale Optimierung reicht nicht aus, wenn ihre Folgen für Personal,…
Business Process Management | Favoriten der Redaktion | Industrie 4.0 | Künstliche Intelligenz | News | Trends 2026 | Trends Infrastruktur | Trends Services
Mehr Effizienz, zu wenig Kontrolle: Der riskante KI-Vorsprung der Werkshallen
Industrielle KI ist in der betrieblichen Praxis angekommen: Produktions-, Service- und Logistikteams berichten von deutlichen Leistungsgewinnen und frei werdenden Kapazitäten. Der IFS Industrial Index 2026 zeigt jedoch zugleich eine kritische Schieflage: Während operative Einheiten KI schnell einsetzen, bleiben Governance, Validierung und menschliche Aufsicht vielerorts zurück [1]. Management Summary Operativer Vorsprung: Produktionsnahe Teams treiben den KI-Einsatz…
Business Process Management | Digitalisierung | ERP | Geschäftsprozesse | Industrie 4.0 | Künstliche Intelligenz | Lösungen | New Work | News | Services | Strategien | Tipps
KI im PLM: Wie der digitale Faden die Fahrzeugentwicklung verändert

Der digitale Faden verbindet Produktdaten und Entscheidungen über Entwicklung, Fertigung und Betrieb hinweg. Bild: KI-generierte Illustration. KI-gestütztes Product Lifecycle Management soll Entwicklungsdaten, Simulationen und Entscheidungen über den gesamten Fahrzeuglebenszyklus verbinden. Der strategische Nutzen entsteht jedoch nicht durch einzelne Algorithmen, sondern durch verlässliche Daten, offene Schnittstellen, überprüfbare Modelle und klare Verantwortlichkeiten. Damit wird PLM vom technischen…
Business | Favoriten der Redaktion | Geschäftsprozesse | IT-Security | Künstliche Intelligenz | News | Services | Tipps
KI-Risiken im Griff: Warum Governance über Haftung und Versicherbarkeit entscheidet
Wer haftet, wenn KI einen Fehler macht? Bitkom-Leitfaden zeigt, wie Unternehmen KI-Risiken erkennen, steuern und absichern können [1]. Mit der wachsenden Autonomie künstlicher Intelligenz steigen nicht nur Effizienzpotenziale, sondern auch Haftungs-, Sicherheits- und Reputationsrisiken. Ein aktueller Bitkom-Leitfaden zeigt, wie Unternehmen KI-Schäden systematisch bewerten, Kontrollmechanismen etablieren und Versicherungslücken erkennen können. Für Entscheider wird damit klar:…
Effizienz | Infrastruktur | Nachhaltigkeit | News | Strategien | Tipps
Ölpreis-Schock im Heizungskeller: Warum fossile Wärme zum Kostenrisiko wird
Der Heizspiegel 2026 zeigt eine wachsende Kluft bei den laufenden Wärmekosten: Während Heizöl und Pellets deutlich teurer werden dürften, bleibt die Wärmepumpe in den untersuchten Modellhaushalten vorn [1]. Für Eigentümer und Mieter wird damit nicht nur der Energieverbrauch, sondern auch die Wahl des Heizsystems zur strategischen Kostenfrage. Management Summary Kostenbild: In den Modellrechnungen des Heizspiegels…
Cloud Computing | Digitale Transformation | Effizienz | Favoriten der Redaktion | Infrastruktur | News | Rechenzentrum | Strategien | Tipps
Datennah, schnell, resilient: Warum Unternehmen KI lokal betreiben

Bildunterschrift: Nicht jeder KI-Workload gehört in die Cloud. Hybride Architekturen verteilen Verarbeitung und Datenhaltung nach Latenz, Schutzbedarf und Verfügbarkeit. Cloud-Plattformen beschleunigen den KI-Einstieg – doch bei sensiblen Daten, Millisekunden-Entscheidungen und unternehmenskritischen Prozessen kann Distanz zum Risiko werden. Sieben typische Einsatzfelder zeigen, wann Edge- oder Vor-Ort-Architekturen mehr Kontrolle, Resilienz und Planbarkeit bieten und weshalb die Entscheidung…
Business Process Management | Kommunikation | Künstliche Intelligenz | New Work | News | Services | Tipps
Total Experience: Mit Speech Analytics zum gezielten KI-Einsatz im Kundenservice
KI-Projekte im Kundenservice scheitern selten an fehlenden Werkzeugen, sondern häufig an unklaren Zielen und schwachen Datengrundlagen. Speech Analytics macht aus Gesprächen und Textkontakten ein strukturiertes Lagebild: Sie zeigt wiederkehrende Anliegen, Prozessbrüche sowie Qualitäts- und Compliance-Risiken. So können Unternehmen Anwendungsfälle priorisieren, Wirkung messen und Customer Experience, Employee Experience und operative Leistung systematisch verbinden. Management Summary Daten…
Business | Digitale Transformation | Künstliche Intelligenz | Nachhaltigkeit | New Work | News | Trends 2026 | Trends Wirtschaft
Deutschlands Startup-Elite 2026: KI, Deep Tech und Defense geben den Takt vor
Das LinkedIn-Ranking der Top Startups 2026 zeigt eine deutsche Gründerszene im technologischen und geopolitischen Wandel. KI, Verteidigungstechnologie, Deep Tech und Energielösungen bestimmen die Spitzenplätze – während Berlin und München ihre unterschiedlichen Stärken als Startup-Zentren ausspielen. Für Entscheider liefert die Liste vor allem Hinweise auf künftige Partner, Talente und Wettbewerber. Management Summary KI wird zur Basistechnologie:…
Business | Geschäftsprozesse | Künstliche Intelligenz | News | Strategien | Tipps | Whitepaper
KI-Monetarisierung 2027: Hybride Preismodelle setzen sich gegen die Kostenfalle durch
Bild: KI-Monetarisierung verlangt eine Balance zwischen Rechenkosten, planbaren Preisen und wirtschaftlichem Nutzen. Quelle: KI-generiert. KI verändert die Softwareökonomie, aber nicht so geradlinig wie erwartet: Anbieter integrieren neue Funktionen in Rekordtempo, während Kunden bei Nutzung und Budget vorsichtig bleiben. Gefragt sind deshalb Preismodelle, die Innovation, Kostentransparenz und Profitabilität miteinander verbinden – und belastbare Nutzungsdaten, die…
Business Process Management | Digitale Transformation | Effizienz | Geschäftsprozesse | Infrastruktur | IT-Security | Künstliche Intelligenz | News | Rechenzentrum | Services
Raus aus dem Datensilo: Wie föderierter Zugriff KI produktionsreif macht
Daten nutzen statt Daten bewegen – Warum KI eine neue Strategie für den Datenzugriff voraussetzt. Generative und agentische KI entfalten ihren geschäftlichen Wert erst, wenn sie aktuelle, verlässliche und fachlich eingeordnete Unternehmensdaten erreichen. Doch diese Informationen liegen meist über Clouds, Rechenzentren, Data Warehouses, operative Datenbanken und SaaS-Anwendungen verteilt. Statt immer neue Kopien und Migrationsprojekte zu…
Business | Business Process Management | Digitale Transformation | Favoriten der Redaktion | Geschäftsprozesse | Künstliche Intelligenz | Lösungen | New Work | News | Strategien | Tipps
Digitale Kollegen, reale Verantwortung: Governance für agentische KI

KI-Agenten führen Aufgaben nicht mehr nur auf Zuruf aus, sondern planen, entscheiden und lösen selbstständig Folgeaktionen aus. Damit verschiebt sich die Führungsfrage: Nicht das leistungsfähigste Modell entscheidet über den Unternehmenserfolg, sondern die Fähigkeit, Befugnisse, Freigaben und Verantwortung eindeutig zu begrenzen. Für CIOs und Geschäftsleitungen wird Agenten-Governance deshalb zur Managementaufgabe. Management Summary Führung neu definieren: KI-Agenten…
Effizienz | Favoriten der Redaktion | Künstliche Intelligenz | Lösungen | Nachhaltigkeit | News | Rechenzentrum | Services
Vom Windrad zum KI-Kraftwerk: Pfaffenhofen macht Energie zu Rechenleistung
Rechenleistung wird zum regionalen Produkt: In Pfaffenhofen entsteht ein modulares KI-Rechenzentrum, das vorrangig Strom aus lokalen Wind- und Solaranlagen nutzt. Das Projekt verbindet Bürgerenergie, GPU-Infrastruktur und Datensouveränität – und erprobt damit ein Modell, das auch für andere Regionen und mittelständische Anwender interessant werden könnte. Management Summary Regionale Wertschöpfung: Überschüssiger Wind- und Solarstrom soll nicht nur…
Infrastruktur | Internet der Dinge | IT-Security | Künstliche Intelligenz | News | Services
KI trifft Daueraufzeichnung: Wenn die Kamera alles sieht – aber der Speicher nicht mithält

Videoüberwachung soll aufzeichnen, bei der Aufklärung helfen und zunehmend auch intelligente Analysen ermöglichen. Damit steigen die Anforderungen an eine Komponente, die selten im Mittelpunkt steht: die Festplatte. Auf der SECURITY in Essen erläutert Rainer Werner Kaese, Senior Manager Product Management Storage Product Division bei Toshiba, im Gespräch mit manageIT, warum Speicherkapazität allein noch kein gutes…
Business Process Management | Künstliche Intelligenz | New Work | News | Tipps
KI-Adoption als Kern-Kategorie: Warum Werkzeuge allein nicht genügen

Generative KI ist in vielen Unternehmen angekommen – ihr wirtschaftlicher Nutzen jedoch noch längst nicht überall. Aktuelle Erhebungen zeigen: Nicht die Verfügbarkeit der Werkzeuge, sondern Führung, neu gestaltete Arbeitsabläufe, Qualifizierung und verlässliche Leitplanken entscheiden darüber, ob aus ersten Experimenten messbarer Geschäftswert entsteht. KI-Adoption ist damit keine reine IT-Aufgabe, sondern ein Veränderungsprogramm für die gesamte Organisation.[1][2]…
Business | Business Process Management | Digitale Transformation | Effizienz | Favoriten der Redaktion | Geschäftsprozesse | Lösungen | New Work | News | Tipps
KI braucht Geschäftskontext: Warum technische Datenqualität zu kurz greift
Technisch korrekte Daten sind noch keine verlässliche Entscheidungsgrundlage. Erst wenn Definitionen, Kontext und konkrete Geschäftsfragen zusammengeführt werden, entstehen Informationen, die Führungskräfte, Prozesse und KI-Anwendungen tatsächlich nutzen können. Unternehmen müssen ihre Datenstrategie deshalb vom Anwendungsfall her denken – und Datenqualität nicht nur an Regeln, sondern an ihrer Wirkung messen. Management Summary Technische Qualität ist nur die…
Künstliche Intelligenz | News | Strategien | Tipps
KI-Governance: Das deutsche Paradoxon von Zuversicht und Reifegrad
Deutsche Sicherheitsverantwortliche vertrauen ihren Schutzmechanismen für KI-Agenten – zugleich fehlen vielerorts Transparenz, klare Zuständigkeiten und belastbare Zugriffsregeln. Das gefährliche Paradoxon zeigt: Wer autonome Systeme nicht als eigenständige digitale Identitäten behandelt, verliert schnell die Kontrolle über Berechtigungen, Datenflüsse und Risiken. Management Summary Vertrauen ersetzt keine Transparenz: Unternehmen müssen sämtliche KI-Agenten, ihre Einsatzorte und Verbindungen vollständig inventarisieren.…