foto ki-generiert
Effizienz von KI-Agenten (I)
Je mehr KI-Agenten Unternehmen einsetzen, desto schneller steigen die Kosten. Vor allem, wenn jeder Agent Wissen, Regeln und Kontext bei jeder Aufgabe neu rekonstruieren muss. Eine gemeinsame Knowledge Layer verlagert die ureigene Geschäftslogik in eine kontrollierte Infrastruktur.
Management Summary
- Wissen zentral statt agentenweise: Geschäftsbegriffe, Regeln und Kontext gehören in eine gemeinsam verwaltete Schicht, nicht in isolierte Prompts und Tools.
- Drei Bausteine tragen die Architektur: Ontologien beschreiben Bedeutung und Beziehungen, Unternehmensdaten verankern das Modell in der Realität, Memory bewahrt bewährte Entscheidungen.
- Kosten entstehen im Betrieb: Redundanter Kontext erhöht Tokenverbrauch, Pflegeaufwand und das Risiko widersprüchlicher Ergebnisse.
- Governance ist Teil der Plattform: Fachbereiche verantworten Semantik und Regeln, Plattformteams Technik und Betrieb; zentrale Leitplanken sichern Zugriff, Qualität und Nachvollziehbarkeit.
- Der Einstieg sollte fokussiert erfolgen: Ein klar abgegrenzter Anwendungsfall mit messbarem Nutzen schafft die Basis für eine schrittweise erweiterbare Knowledge Layer.
 KI-Agenten lassen sich schnell entwickeln – doch mit jedem neuen Einsatz wächst die Gefahr widersprüchlicher Regeln, redundanter Wissensbestände und steigender Betriebskosten. Eine zentrale Knowledge Layer bündelt Ontologien, Unternehmensdaten und Erfahrungswissen zu einer kontrollierbaren Infrastruktur. Sie schafft damit die Grundlage dafür, dass Agenten konsistent, nachvollziehbar und effizient auf den geschäftlichen Kontext zugreifen können.
Wenn KI im Unternehmen scheitert, liegt es meist nicht am Modell. Leistungsfähige LLMs werden laufend besser, auch Tools, Orchestrierung, Evaluierung und Guardrails sind gereift. Unternehmen wissen, wie sich KI-Agenten entwickeln und einsetzen lassen. Trotzdem erzielen sie mit vergleichbaren Modellen und Agenten-Stacks sehr unterschiedliche Ergebnisse. Der entscheidende Hebel liegt woanders: darin, wie gut die KI das Unternehmen und seinen geschäftlichen Kontext versteht.
Warum dieses Verständnis fehlt, hat einen einfachen Grund: Geschäftliche Semantik und institutionelles Wissen sind oft nie explizit erfasst worden. Anwendungen und Menschen brachten den nötigen Kontext bisher selbst mit. Eine Anwendung weiß, dass ein Auftrag über 100.000 Euro eine zusätzliche Freigabe erfordert; ein Sachbearbeiter ebenso. Dieses Wissen steckt im Code oder in den Köpfen der Mitarbeitenden – aber nicht dort, wo ein KI-Agent darauf zugreifen kann.
Warum Wissen nicht in den Agenten gehört
Die logische Reaktion wäre, jedem Agenten das benötigte Wissen direkt mitzugeben: Geschäftsdefinitionen wandern in den Prompt, Regeln in ein Tool auf einem MCP-Server, zusätzlicher Kontext kommt über eine Retrieval-Pipeline. Für einzelne Anwendungen funktioniert das gut. Doch damit verteilt sich ein Teil der Geschäftssemantik auf die jeweiligen Agenten.
Skaliert man dieses Muster auf zehn Agenten, entstehen zehn separate Abbilder des Unternehmenswissens. Solche semantischen Duplikate driften zwangsläufig auseinander. Die Definition eines »freigegebenen Lieferanten« wird beispielsweise in einem MCP-Server angepasst, später in einem anderen Agenten-Prompt – und fehlt in einem dritten vielleicht ganz. Kein Alarm weist auf den Widerspruch hin. Das Unternehmen verliert schleichend eine einheitliche Sicht auf die eigene Geschäftslogik.
Agenten sind schnell gebaut. Teuer wird es, sie so zu betreiben, dass sie dauerhaft konsistente Ergebnisse liefern. Hinzu kommt der Tokenverbrauch: Anthropic berichtete aus dem Betrieb seines Research-Systems, dass Agenten etwa viermal so viele Tokens verbrauchten wie Chat-Interaktionen, Multi-Agent-Systeme sogar rund 15-mal so viele [1]. Noch mehr Logik und Kontext in jeden einzelnen Agenten zu packen, verschärft das Problem. Jede Ergänzung schafft eine weitere Wissenskopie, die gepflegt und synchronisiert werden muss.
Eine einheitliche Wissens-Infrastruktur
Die Lösung folgt einem anderen Prinzip: Statt Geschäftslogik, Definitionen und Kontext in einzelne Agenten einzubauen, werden sie in einer gemeinsamen, kontrollierten Knowledge Layer gebündelt. Diese Wissensschicht stützt sich auf drei zentrale Bausteine:
- Die Ontologie bildet in einem formal definierten, vernetzten Modell ab, wie das Unternehmen tatsächlich funktioniert. Dazu gehören die fachlichen Begriffe und Domänenmodelle ebenso wie Rollen und Verantwortlichkeiten, Übergaben zwischen Teams, Geschäftsprozesse sowie die Systeme und Datenbestände, auf denen diese Prozesse beruhen. Auch Regeln und Abhängigkeiten sind Teil dieses Modells – etwa, dass eine Rückerstattung den ursprünglichen Rechnungsbetrag nicht überschreiten darf oder dass ein Datenprodukt auf einer zugänglichen Datenquelle basieren muss. Hinzu kommen die Verknüpfungen zwischen den fachlichen Elementen und den zugrunde liegenden technischen Ressourcen.
- Unternehmensdaten verankern das in der Ontologie beschriebene Domänenmodell in der betrieblichen Realität. Referenzdaten lassen sich dabei häufig als Erweiterung der Ontologie verwalten. Sie definieren beispielsweise kontrollierte Wertebereiche für bestimmte Begriffe – etwa eine verbindliche Liste zulässiger Länder statt uneinheitlicher Einträge in einzelnen Datenfeldern. Stamm- und Transaktionsdaten können dagegen in den bestehenden Systemen verbleiben und dort abgefragt oder als materialisierte beziehungsweise virtualisierte Domain Graphs in die Knowledge Layer eingebunden werden. Welcher Ansatz sich eignet, hängt von Architektur und Anwendungsfall ab.
- Die Gedächtniskomponente (Memory) erweitert die Knowledge Layer um Erfahrungswissen aus früheren Interaktionen. Jede Nutzung kann Entscheidungsspuren hinterlassen und damit festhalten, welche Vorgehensweise sich in einer bestimmten Situation bewährt hat. Muss ein Agent bei einer Kontoeröffnung beispielsweise die Identität eines Kunden prüfen, kann die Ontologie vorgeben, welche Systeme dafür grundsätzlich infrage kommen. Die Gedächtniskomponente hält dagegen fest, welche Quelle sich in vergleichbaren Fällen als schneller oder zuverlässiger erwiesen hat. Vereinfacht gesagt: Die Ontologie beschreibt, was möglich ist. Die Gedächtniskomponente hält fest, was sich in der Praxis bewährt hat. Wissen, das früher im Kopf eines Analysten oder in einem abgeschlossenen Ticket verblieb, kann so während der Arbeit erfasst und bei späteren Entscheidungen wieder genutzt werden.
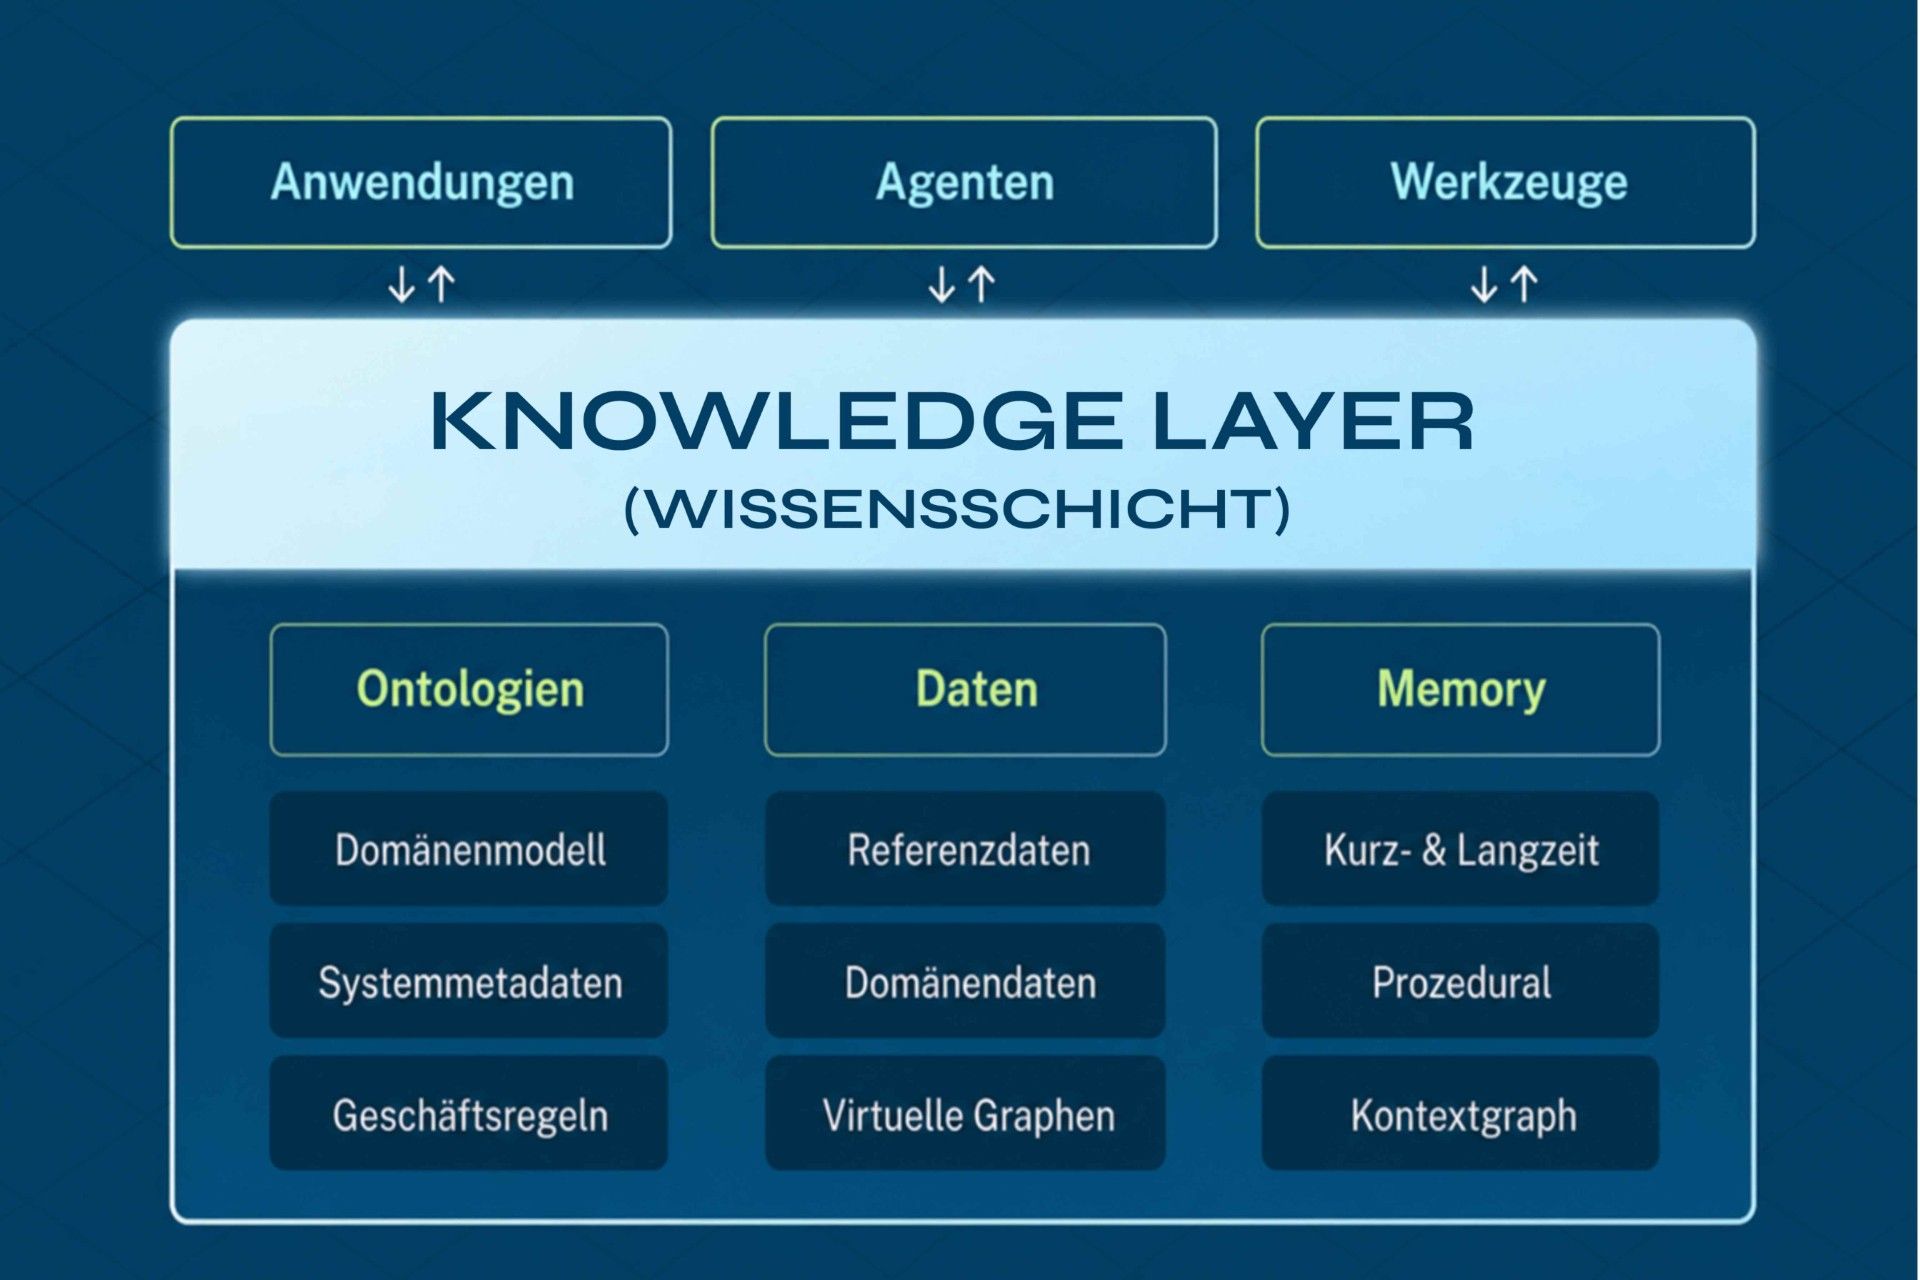
Abb. 1.: Aufbau der Knowledge Layer aus Ontologien, Daten und Memory
Architektonische Schicht zwischen Daten und Agenten
Die Knowledge Layer ist mehr als eine BI Semantic Layer oder eine zusätzliche Context Layer für Retrieval. Anders als etwa ein Datenkatalog enthält sie nicht nur Definitionen, sondern lässt sich aktiv abfragen und in Prozesse einbinden. Architektonisch liegt sie zwischen den Datenbeständen eines Unternehmens und den Agenten beziehungsweise Anwendungen, die darauf zugreifen.
Dabei reicht es nicht, das benötigte Wissen einmal auszulesen und im Kontext des Agenten vorzuhalten. Dafür ist die Knowledge Layer nicht nur zu umfangreich, sondern auch zu dynamisch: Definitionen ändern sich, Datenquellen wechseln und neues Erfahrungswissen kommt hinzu. Agenten greifen deshalb während ihrer Arbeit kontinuierlich auf die Knowledge Layer zu und beziehen jeweils genau die Informationen, Regeln und Zusammenhänge ein, die sie für eine konkrete Anfrage benötigen.
Was bei der Umsetzung zu beachten ist
Beim Aufbau und Betrieb einer Knowledge Layer sind neben der technischen Architektur auch organisatorische und methodische Faktoren zu berücksichtigen.
- Maßgeschneidertes Wissen: Eine Knowledge Layer ist in der Regel keine fertige Standardlösung. Anbieter können jedoch die technische Basis liefern – etwa Graphplattform, Datenkatalog oder Policy Engine. Neue Tools können den Aufbau zusätzlich deutlich beschleunigen und Unternehmen dabei unterstützen, die Inhalte zu definieren und die Knowledge Layer an ihren spezifischen Anforderungen auszurichten. Dazu gehören Geschäftsbegriffe, Datenlandschaft, Governance-Regeln und Vorgaben für das Verhalten von Agenten. Graphtechnologie eignet sich dafür besonders, weil sie nicht nur einzelne Daten und Informationen abbildet, sondern auch deren Beziehungen zueinander – und damit den fachlichen Kontext, in dem sie stehen.
- Hybrider Ansatz: Beim Aufbau der Knowledge Layer schlägt die KI mögliche Definitionen, Zuordnungen oder maßgebliche Datenquellen vor; Fachverantwortliche prüfen und bestätigen sie. Branchenmodelle, Standards und bewährte Muster können den Aufbau zusätzlich beschleunigen. Die unternehmensspezifischen Entscheidungen bleiben allerdings in der Verantwortung der Organisation.
- Kontinuierliche Weiterentwicklung: Die Knowledge Layer entwickelt sich mit ihrer Nutzung weiter. Jede Anfrage, mehrdeutige Definition oder überraschende Zuordnung zeigt, wo die Wissensschicht noch zu dünn ist oder nachgeschärft werden muss. Solche Erkenntnisse fließen kontinuierlich zurück und verbessern die Qualität der Knowledge Layer im laufenden Betrieb. Vieles lässt sich dabei automatisieren, Fachverantwortliche sind weiterhin in die Prüfungs- und Freigabeprozesse eingebunden.
- Gemeinsame Infrastruktur, verteilte Verantwortung: Eine Knowledge Layer darf kein Projekt eines einzelnen Teams sein. Fachbereiche verantworten Begriffe, Regeln und Zuordnungen, Plattformteams die technische Basis. Übergreifende Governance sorgt für Konsistenz und setzt Zugriffs- und Risikovorgaben bei der Abfrage durch, während die Domänen ihre fachlichen Definitionen kontrollieren. Ähnlich wie beim Data Mesh liegt die Verantwortung damit möglichst nah an den Fachbereichen – und zwar für Bedeutung, Zuordnung und Nutzung.
Unternehmen gewinnen KI-Vorsprung durch belastbares, unternehmensweit abgestimmtes Verständnis des eigenen Geschäfts. Wer dieses Wissen strukturiert, zugänglich macht und verankert, gibt seinen Agenten den Kontext für effizientes Handeln. Die Frage ist nicht, ob Unternehmen ihr Wissen neu organisieren müssen – sondern wie lange sie es sich noch leisten können, darauf zu verzichten.
 Dr. Jesús Barrasa, AI Field CTO, Neo4j
Dr. Jesús Barrasa ist Experte für semantische Technologien und Graphdatenbanken. Bei Neo4j leitet er das Solutions-Architecture-Team in EMEA und verantwortet die Entwicklung von neosemantics, einem Neo4j-Plugin für RDF. Er ist Mitautor mehrerer Fachbücher über Knowledge Graphen und Datenkontext sowie Co-Host des Live-Webcasts Going Meta. https://neo4j.com/
Tipps für den Aufbau einer Knowledge Layer
- Mit einem geschäftskritischen Use Case starten: Wählen Sie einen Prozess, dessen Regeln, Datenquellen und Erfolgskriterien klar benennbar sind.
- Begriffe zuerst klären: Dokumentieren Sie Definition, Eigentümer, zulässige Werte und Beziehungen zentral, bevor Agenten darauf zugreifen.
- Quellen und Herkunft mitführen: Jede Wissenseinheit sollte auf eine verantwortliche Quelle, Version und Freigabe zurückführbar sein.
- Zugriffe auf Wissensebene steuern: Übernehmen Sie Berechtigungen und Klassifizierungen aus den Quellsystemen auch in Graph, Index und Cache.
- Änderungen versionieren: Behandeln Sie Ontologien, Regeln und Mapping wie Produktartefakte mit Review, Tests und Rückfalloption.
- Qualität kontinuierlich messen: Beobachten Sie Trefferqualität, widersprüchliche Antworten, Quellenabdeckung, Latenz und Tokenkosten.
- Memory begrenzen: Legen Sie fest, welche Erfahrungen gespeichert werden dürfen, wie lange sie gelten und wer sie korrigieren kann.
- Fachbereiche verbindlich einbinden: Technische Teams stellen die Plattform bereit; die Verantwortung für Bedeutung und Regeln bleibt in den Domänen.
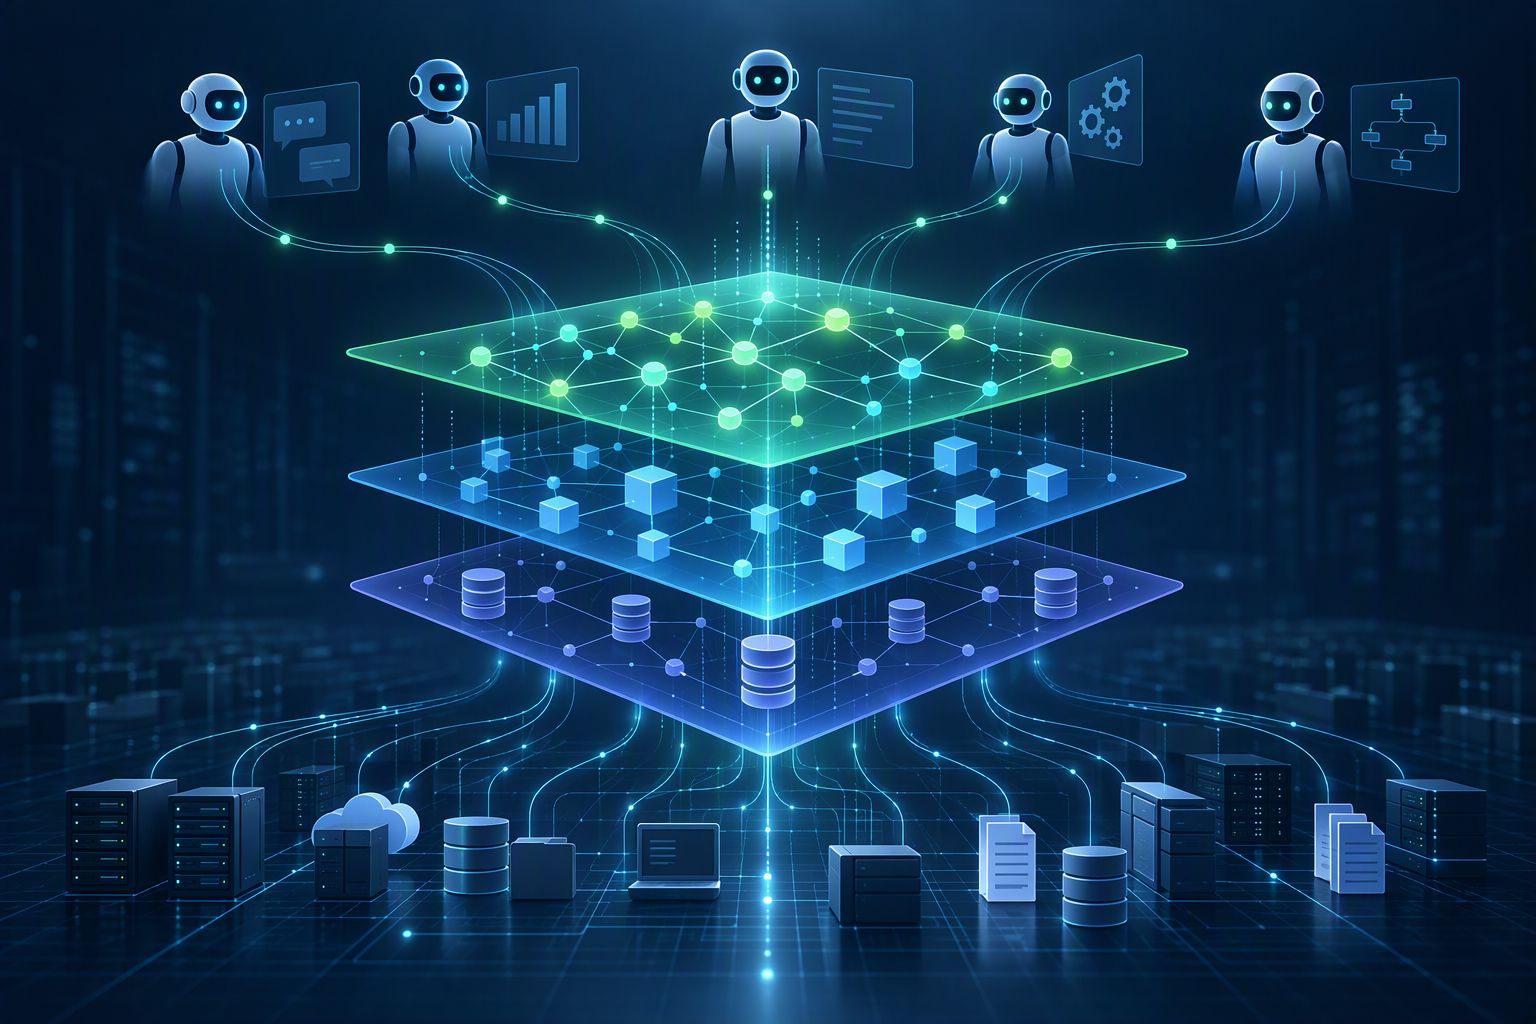
Illustration Absmeier foto ki designer
FAQ: Knowledge Layer für KI-Agenten
- Was ist eine Knowledge Layer?
Eine Knowledge Layer ist eine gemeinsam verwaltete Wissensschicht zwischen Unternehmensdaten und den Anwendungen oder Agenten, die diese Daten nutzen. Sie verbindet fachliche Begriffe, Beziehungen, Regeln, Datenquellen und – sofern vorgesehen – Erfahrungswissen.
- Worin unterscheidet sie sich von einer RAG-Lösung?
RAG ruft in erster Linie relevante Inhalte für eine Anfrage ab. Eine Knowledge Layer geht darüber hinaus: Sie beschreibt formale Bedeutungen, Beziehungen und Regeln, kann mehrere Retrieval-Verfahren einbinden und stellt Agenten kontrollierten Kontext bereit. OWASP weist zugleich darauf hin, dass RAG neue Angriffsflächen entlang der gesamten Datenpipeline schafft [2].
- Welche Rolle spielen Ontologien?
Ontologien definieren Klassen, Eigenschaften, Instanzen und Beziehungen mit formal festgelegter Bedeutung. Der W3C-Standard OWL 2 bietet dafür eine etablierte technische Grundlage und kann auch Konsistenzprüfungen sowie maschinelle Schlussfolgerungen unterstützen [3].
- Braucht jedes Unternehmen einen Knowledge Graph?
Nicht zwingend. Für überschaubare Domänen können ein kontrolliertes Glossar, Metadaten, Richtlinien und klar geregelte Datenzugriffe genügen. Ein Knowledge Graph wird besonders nützlich, wenn viele Beziehungen, Quellen und domänenübergreifende Abhängigkeiten abgefragt werden müssen.
- Wie lässt sich die Qualität der Wissensschicht messen?
Geeignete Kennzahlen sind unter anderem Quellenabdeckung, Aktualität, Widerspruchsquote, Antworttreue, korrekte Berechtigungsdurchsetzung, Latenz und Kosten pro Aufgabe. Für das übergreifende Risikomanagement strukturiert das NIST AI RMF die Arbeit in die Funktionen Govern, Map, Measure und Manage [4].
- Wer sollte die Knowledge Layer verantworten?
Die Plattformverantwortung liegt typischerweise bei Daten- oder Plattformteams. Fachbereiche sollten Definitionen, Regeln und maßgebliche Quellen besitzen. Ein übergreifendes Governance-Gremium koordiniert Standards, Zugriffe, Qualitätsziele und Eskalationswege.
- Wie wird die Knowledge Layer abgesichert?
Erforderlich sind Herkunfts- und Integritätsprüfung, Berechtigungsmetadaten pro Wissenseinheit, Trennung von Mandanten und Schutzklassen, abgesicherte Indizes, Protokollierung sowie Ausgabe- und Tool-Kontrollen. Die OWASP-Empfehlungen für RAG nennen diese Maßnahmen als zentrale Kontrollen für produktive Pipelines [2].
- Welche Daten gehören in die Memory-Komponente?
Gespeichert werden sollten nur geprüfte, zweckgebundene Entscheidungsspuren und wiederverwendbare Erfahrungen. Rohdialoge, personenbezogene Daten oder ungeprüfte Agentenannahmen benötigen klare Speicher-, Lösch- und Freigaberegeln.
- Wie startet ein Unternehmen pragmatisch?
Geeignet ist ein begrenzter Prozess mit bekannten Datenquellen, klaren Regeln und messbarem Nutzen. Das Team modelliert zunächst die wichtigsten Begriffe und Beziehungen, bindet zwei oder drei maßgebliche Quellen an und testet den Zugriff mit realen Aufgaben, bevor weitere Domänen folgen.
- Senkt eine Knowledge Layer automatisch die KI-Kosten?
Nein. Einsparungen hängen von Architektur, Abfrageverhalten, Caching, Retrieval-Qualität und Betriebsmodell ab. Anthropic berichtet für sein Research-System, dass agentische und insbesondere Multi-Agenten-Abläufe deutlich mehr Tokens als einfache Chat-Interaktionen benötigen; deshalb sollten Kontextumfang und Orchestrierung gemessen werden [1].
[1] https://www.anthropic.com/engineering/multi-agent-research-system
[2] https://cheatsheetseries.owasp.org/cheatsheets/RAG_Security_Cheat_Sheet.html
[3] https://www.w3.org/TR/owl2-overview/
[4] https://www.nist.gov/itl/ai-risk-management-framework
Management Summary, FAQ und Bild wurden mit Hilfe von KI erstellt
Artikelserie:
#1 Knowledge Layer: Warum Unternehmen ihr Wissen neu organisieren müssen
#2 Context Graph: Warum KI-Agenten frühere Entscheidungen kennen müssen
#3 Agent Memory: Warum KI drei »Gedächtnisse« braucht
#4 Thin Agents: Warum schlanke KI-Agenten besser skalieren
Effizienz von KI-Agenten: Vier Architekturstrategien gegen unnötigen Tokenverbrauch
Illustration Absmeier foto magnific ki
KI-Agenten versprechen mehr Automatisierung, schnellere Entscheidungen und produktivere Teams. In der Praxis zeigt sich jedoch: Ohne saubere Daten- und Kontextarchitektur verbrauchen sie unnötig viele Tokens, liefern schwer überprüfbare Ergebnisse und treiben die Betriebskosten nach oben. Unternehmen müssen deshalb nicht nur den KI-Einsatz steuern, sondern ihre Wissensbasis so strukturieren, dass Agenten gezielt, nachvollziehbar und effizient arbeiten können.
Management Summary
- Der Kostendruck bei KI-Projekten steigt: Wenn Agenten zu viel Kontext verarbeiten, werden Tokenverbrauch und Laufzeiten schnell zum Skalierungsproblem.
- Nutzungslimits und Kosten-Dashboards reichen nicht aus. Entscheidend ist eine Architektur, die Unternehmenswissen gezielt, kontrolliert und wiederverwendbar bereitstellt.
- Knowledge Layer, Context Graph und Agentengedächtnis machen KI-Agenten effizienter, weil sie relevante Informationen kontextbezogen abrufen, statt ganze Datenbestände neu zu durchsuchen.
- Thin Agents reduzieren Komplexität: Regeln, Rollen, Datenbeziehungen und Entscheidungshistorie bleiben zentral gepflegt, während Agenten nur das abrufen, was sie für den nächsten Schritt benötigen.
- Für IT- und Fachverantwortliche wird Datenarchitektur damit zum strategischen Hebel: Sie senkt Kosten, verbessert Nachvollziehbarkeit und schafft die Basis für skalierbare, compliancefähige KI.
Das KI-Budget ist überschritten, das Tokenkontingent gedeckelt, der Rollout des KI-Systems auf dem Prüfstand. Doch Nutzungslimits, Modell-Routing und Kosten-Dashboards behandeln oft nur die Symptome. Wer die Performance von KI-Agenten steigern und ihre Kosten reduzieren will, muss an der Architektur ansetzen. Der Graph- und KI-Experte Neo4j zeigt vier Ansätze, um KI-Agenten effizienter und Ergebnisse belastbarer zu machen.
Wie groß der Kostendruck bereits ist, zeigt eine McKinsey-Umfrage: 93 Prozent der befragten Unternehmen überziehen ihre KI-Budgets – knapp die Hälfte um bis zu 30 Prozent [1]. Sind die Tokenpools nach kurzer Zeit aufgebraucht, gelten strenge Obergrenzen und monatliche Kontingente.
Tokenmaxxing beschreibt dabei eine KI-Nutzung, bei der hoher Tokenverbrauch zum vermeintlichen Maßstab für Produktivität wird. Doch mehr Aufwand schafft nicht automatisch mehr Wert. Wenn Agenten unaufgeräumte Datensilos durchsuchen, irrelevante Informationen analysieren, Arbeitsschritte wiederholen und bei jeder Anfrage neu beginnen, kostet das Zeit und Geld.
Vier Architekturhebel für effizientere KI-Agenten
AI-FinOps, eingebettete KI-Governance, klare Verantwortlichkeiten und Richtlinien schaffen Transparenz und Kontrolle im KI-Betrieb. Doch Effizienz ist auch eine Architekturfrage. Tokenmaxxing lässt sich nicht allein durch eine Begrenzung der Tokenzahl vermeiden. Entscheidend ist eine strukturierte Wissensgrundlage, über die KI-Agenten gezielt auf den jeweils relevanten Kontext zugreifen können. Vier Hebel in der Daten- und Kontextarchitektur sind dabei entscheidend:
-
Knowledge Layer: Die Ontologie als Wissenslandkarte
Unternehmenswissen ist weit mehr als das, was in Handbüchern, Datenbanken oder Prozessbeschreibungen festgehalten ist. Es ist aus Erfahrung entstanden und tief in den Mitarbeitenden, Routinen, Beziehungen und der Unternehmenskultur verankert. Wie lässt sich diese gemeinsame Wissensbasis so abbilden, dass KI-Agenten sie nutzen können?
Genau hier setzt die Knowledge Layer an: eine gemeinsame, kontrollierte Schicht, die Ontologie, Unternehmensdaten und Gedächtnis bündelt. Die Wissensschicht setzt sich aus drei Bausteinen zusammen:
- einer Ontologie als lebendige Landkarte des Unternehmens, die Rohdaten mit Geschäftsbegriffen und Prozessen verknüpft;
- den Unternehmensdaten, die diese Landkarte mit Substanz füllen;
- einem Gedächtnis (Memory), das frühere Entscheidungen und Ergebnisse festhält
Organisatorisches Wissen wird dadurch abfragbar. Agenten greifen auf eindeutig definierte Begriffe, Zuständigkeiten, Zusammenhänge und frühere Entscheidungen zu – und zwar im Kontext einer gemeinsamen, kontrollierten Wissensgrundlage.
-
Context Graph: Navigationssystem für situative Entscheidungen
Agentische KI-Systeme sind darauf ausgelegt, Aufgaben über mehrere Schritte hinweg weitgehend autonom auszuführen. Damit lassen sich Informationen nicht mehr »auf Vorrat« in einen Prompt packen. Vielmehr müssen Agenten situativ auf Daten zugreifen und diese bewerten können.
Ein Context Graph – in Form eines Knowledge-Graphen – ermöglicht genau das. Er verbindet die Wissensbasis der Knowledge Layer mit früheren Entscheidungen, Reasoning-Spuren, Ergebnissen und Begründungszusammenhängen. Ein Agent erkennt dadurch nicht nur, wo er steht, sondern auch, warum dieser Zustand entstanden ist und welcher Schritt als Nächstes sinnvoll ist. Oder anders gesagt: Die Knowledge Layer beantwortet das Was, der Context Graph das Warum.
Für den einzelnen Arbeitsschritt ruft ein Agent dabei nur den relevanten Ausschnitt des Graphen auf. Das begrenzt die Datenmenge im Kontextfenster und reduziert die Zahl der nötigen Suchvorgänge. Zugleich hält der Context Graph fest, welche Daten, Regeln und Zwischenschritte in eine Entscheidung eingeflossen sind. So lässt sich prüfen, wie und auf welcher Informationsbasis die KI zu einem Ergebnis kam – eine wichtige Voraussetzung für Audits und Compliance, etwa im Rahmen des EU AI Act.
-
Agentengedächtnis: Arbeiten ohne unnötige Neustarts
LLMs besitzen in der Regel kein dauerhaftes Gedächtnis: Sie »vergessen«, verlieren sich in Teilaufgaben und Detailfragen oder kommen nur über Umwege ans Ziel. Das Agentengedächtnis (Agent Memory) bezeichnet die Fähigkeit eines KI-Agenten, Informationen über längere Zeit zu speichern, abzurufen und für weitere Entscheidungen oder Aktionen zu nutzen. Besonders wichtig ist dabei das Kurzzeitgedächtnis (Short-Term Memory). Es speichert den aktuellen Arbeitskontext und hält den Agenten auf Kurs: Was ist das Ziel? Woran wird gerade gearbeitet? Welcher Agent übernimmt welche Teilaufgabe? Und was wurde bereits erledigt?
Wie der Context Graph ist auch das Agentengedächtnis Teil der Knowledge Layer, wobei das Kurzzeitgedächtnis den Fokus auf den Arbeitsstand und den bisherigen Verlauf des Agenten legt. Innerhalb der Knowledge Layer wird dieser Zustand in einer persistenten Speicher- oder Datenbankschicht außerhalb des LLM abgelegt. Bei längeren Workflows funktioniert dieses Gedächtnis wie ein Fahrtenbuch: Versionierte Checkpoints halten fest, wo der Agent steht und welche Schritte bereits abgeschlossen sind. Nach einer Unterbrechung kann er so am zuletzt bestätigten Stand weiterarbeiten, statt von vorn zu beginnen.
-
Thin Agents: Mit leichtem Gepäck effizienter ans Ziel
Auf dieser Architektur aus Knowledge Layer, Context Graph und Agentengedächtnis setzen die sogenannten Thin Agents auf. Wie wendige Fahrzeuge nutzen sie die Wissensinfrastruktur, um Kurven schneller zu nehmen und sicher ans Ziel zu gelangen. Dabei reisen sie mit leichtem Gepäck: Unternehmenswissen, Geschäftsregeln, Zugriffsrechte und Entscheidungskontext führen sie nicht ständig mit. Stattdessen rufen sie diese Informationen unterwegs genau dann ab, wenn sie gebraucht werden. Um im Bild zu bleiben: In der Knowledge Layer bildet die Ontologie die Wissenslandkarte, der Context Graph übernimmt bei konkreten Entscheidungen die Navigation und das Agentengedächtnis dient als Fahrtenbuch.
Damit bleibt der Fokus auf den eigentlichen Aufgaben: Nutzerabsicht verstehen, nächste Schritte planen, Aktionen ausführen. Es entstehen kürzere Systemprompts, weniger doppelte Logik und geringerer Pflegeaufwand. Regeln und Wissen werden zentral gepflegt – das reduziert Redundanz und verhindert, dass Agenten mit der Zeit auf unterschiedlichen Wissensständen arbeiten.

Welchen Unterschied ein gezielter Zugriff auf verknüpftes Wissen machen kann, zeigt eine Studie des National Innovation Centre for Data (NICD) [2]. Bei 510 komplexen Fragen lieferte der graphgestützte Ansatz deutlich mehr faktisch richtige Antworten und weniger Halluzinationen. Der sogenannte Truthfulness-Score liegt rund 80 Prozent höher als beim rein vektorbasierten RAG-System. Zugleich steigt der Anteil beantworteter Fragen von knapp 29 auf mehr als 65 Prozent. Weil das System gezielt relevante Abschnitte und Zusammenhänge abruft, muss es nicht jedes Mal ganze Dokumente verarbeiten – und setzt die verfügbaren Tokens damit deutlich effizienter ein.
»KI-Leistung ist heute weitgehend austauschbar. Der eigentliche Wettbewerbsvorteil liegt im Unternehmenswissen. Wenn jedes Unternehmen dieselben leistungsstarken Modelle per Token mieten kann, liegt der dauerhafte Wettbewerbsvorteil woanders: im verlässlichen, kontrollierten Verständnis des eigenen Geschäfts«, erklärt Dr. Jesús Barrasa, AI Field CTO bei Neo4j. »Durchsetzen werden sich die Unternehmen, deren Agenten ihr Geschäft wirklich verstehen. Dafür müssen sie die aber zunächst an ihrer Datengrundlage arbeiten. Das heißt ihr Unternehmenswissen sauber formalisieren und so bereitstellen, dass alle Agenten darauf aufbauen können.«
[1] https://www.mckinsey.com/capabilities/quantumblack/our-insights/the-cost-of-intelligence-how-cios-can-manage-ai-demand-at-scale
[2] https://arxiv.org/html/2606.05901v2
FAQ
Warum verbrauchen KI-Agenten oft unnötig viele Tokens?
Weil sie häufig zu viel irrelevanten Kontext verarbeiten, Datenbestände mehrfach durchsuchen oder ohne Gedächtnis nach jeder Unterbrechung neu starten. Dadurch steigen Kosten und Antwortzeiten, ohne dass die Ergebnisqualität automatisch besser wird.
Was leistet eine Knowledge Layer?
Sie bündelt Ontologie, Unternehmensdaten und Gedächtnis zu einer kontrollierten Wissensschicht. Agenten können dadurch Begriffe, Zuständigkeiten, Zusammenhänge und frühere Entscheidungen gezielt nutzen.
Worin liegt der Nutzen eines Context Graph?
Ein Context Graph verbindet Daten, Regeln, Entscheidungen und Begründungen. Er hilft Agenten, situativ den passenden Ausschnitt des Unternehmenswissens abzurufen und macht zugleich nachvollziehbar, warum ein Ergebnis entstanden ist.
Was sind Thin Agents?
Thin Agents sind schlank konzipierte KI-Agenten, die Wissen, Regeln und Kontext nicht dauerhaft mitführen. Sie greifen bei Bedarf auf zentrale Wissens- und Kontextstrukturen zu und bleiben dadurch wartbarer, effizienter und leichter skalierbar.
Was sollten Unternehmen jetzt priorisieren?
Sie sollten KI-Anwendungsfälle inventarisieren, zentrale Wissensstrukturen aufbauen, Daten- und Zugriffsregeln klären und Agentenarchitekturen so gestalten, dass Kostenkontrolle, Qualität und Compliance von Anfang an zusammengedacht werden.
Management Summary, FAQ und Bild wurden mit Hilfe von KI erstellt
497 Artikel zu „Token“
Ausgabe 5-6-2026 | News | Infrastruktur | Künstliche Intelligenz | Lösungen
Wie Unternehmen KI-Kosten im Griff behalten – Von Tokenmaxxing zu Kontext
Agentische KI ist der Trend in der Unternehmens-IT. Doch der zunehmende Einsatz autonomer Agentensysteme treibt den Ressourcenverbrauch in die Höhe. Kontextmodelle helfen KI-Agenten, schneller und effizienter ,ans Ziel zu kommen – und ermöglichen Unternehmen, ihre KI-Kosten im Griff zu behalten.
News | Business | Favoriten der Redaktion | Geschäftsprozesse | Künstliche Intelligenz | Services | Tipps
Warum die Kosten der KI‑Nutzung steigen – und welche Rolle Tokens dabei spielen
Die wirtschaftliche Nutzung von KI erlebt 2026 eine Phase massiver Kostensteigerungen. Unternehmen, die KI ursprünglich als Effizienztreiber eingeführt haben, sehen sich nun mit Ausgaben konfrontiert, die in vielen Fällen die Personalkosten übersteigen. Ein zentraler Mechanismus hinter dieser Entwicklung ist das tokenbasierte Abrechnungsmodell moderner Sprachmodelle. Die Analyse zeigt: Die Kombination aus wachsendem Verbrauch, komplexeren Workflows und…
News | IT-Security | Services | Whitepaper
Token Exchange: Identitäten sicher über Domänengrenzen hinweg autorisieren
Der Einsatz von KI-Agenten, APIs und Microservices erfordert sichere Authentisierung von Identitäten über mehrere Sicherheits- und Vertrauensdomänen hinweg – eine Herausforderung, die mit Token Exchange beherrschbar wird. Der KI-Funke lodert immer stärker: Zunehmend mehr Unternehmen träumen von hauseigenen Chatbots, die den Beschäftigten Antworten aus dem gesamten Unternehmensnetz zusammentragen, und KI-Agenten, die Workflows und Geschäftsprozesse…
News | Business | Lösungen | Ausgabe 9-10-2022
Das Operator-Tokenomics-Modell – Nutzer im Zentrum eines neuen Datenökosystems

Ob Telekommunikationsunternehmen, Einzelhändler oder Finanzinstitut: Sie alle benötigen tiefen Einblick in Daten ihrer Kunden, um dem stetig wachsenden Wettbewerbsdruck standhalten zu können. Während bei vielen Nutzern die Lust am Teilen der eigenen Daten sinkt, wächst bei den Unternehmen die Angst vor Datenschutzverletzungen und Schwachstellen im Bereich Cybersecurity. Um allen Beteiligten gerecht zu werden, benötigen Unternehmen und Kunden ein entsprechendes Ökosystem zur persönlichen Datenvermittlung – beispielsweise ein sogenanntes »Operator Tokenomics«-Modell. Was kann ein solches Modell leisten, welche Bausteine werden benötigt und welche Rolle spielt Identity und Access Management?
News | Digitalisierung | Geschäftsprozesse | IT-Security | Künstliche Intelligenz | Strategien | Tipps
Nicht-menschliche Identitäten: Warum Unternehmen Maschinen, Dienste und KI-Agenten besser steuern müssen

Service-Konten, API-Schlüssel, Zertifikate und KI-Agenten sind heute zentrale Bausteine digitaler Geschäftsprozesse – zugleich aber oft kaum gesteuerte Risikoträger. Unternehmen müssen nicht-menschliche Identitäten deshalb konsequent inventarisieren, begrenzen und überwachen, um Angriffsflächen zu reduzieren, Compliance-Anforderungen zu erfüllen und Automatisierung sicher zu skalieren. Management Summary Nicht-menschliche Identitäten entwickeln sich in hybriden IT-, Cloud- und KI-Umgebungen zu einer…
News | Business | Business Process Management | Digitalisierung | E-Commerce | Geschäftsprozesse | Künstliche Intelligenz
Agentic Payment verändert die Spielregeln für Unternehmen

Die KI sucht aus. Die KI bezahlt. Quelle: © Freepik, Starline Dass künstliche Intelligenz Geschäftsprozesse automatisiert, ist für Unternehmen nichts Neues. Eine neue Qualität entsteht jedoch, wenn KI-Systeme selbst wirtschaftlich relevante Handlungen ausführen. Genau das passiert bei Agentic Payments, wo ein digitaler Agent im Auftrag eines Nutzers Produkte auswählen und eine Zahlung initiieren kann.…
News | Business | Business Process Management | Digitale Transformation | Effizienz | Favoriten der Redaktion | Geschäftsprozesse | Künstliche Intelligenz | Strategien | Tipps
Warum KI in vielen Unternehmen nicht die erwartete Produktivitätswende bringt

KI entscheidet nicht automatisch über Produktivität, Wettbewerbsfähigkeit oder Zukunftsfähigkeit. Der Unterschied entsteht dort, wo CEO und CIO die Technologie gemeinsam aus der Pilotphase in belastbare Betriebsmodelle, klare Datenverantwortung und messbare Geschäftsziele überführen. Wer jetzt nur experimentiert, riskiert neue Abhängigkeiten und verpasste Wertschöpfung; wer konsequent handelt, kann KI zum strategischen Produktivitätshebel machen. Management Summary KI entfaltet…
News | Business | Business Process Management | Digitale Transformation | Effizienz | Favoriten der Redaktion | Geschäftsprozesse | Künstliche Intelligenz | Strategien | Tipps
KI hebt keine Produktivität – solange CEO und CIO sie wie ein IT‑Projekt behandeln

Künstliche Intelligenz entscheidet nicht automatisch über Produktivität, Wettbewerbsfähigkeit oder Zukunftsfähigkeit. Entscheidend ist, ob Unternehmensführung und IT sie gemeinsam aus der Pilotphase in den industriellen Betrieb führen. Für CEOs und CIOs wird KI damit zum Prüfstein: Wer weiter nur experimentiert, riskiert strategische Rückständigkeit; wer jetzt konsequent handelt, kann Prozesse, Geschäftsmodelle und Organisationen neu ausrichten. Management Summary…
Trends 2026 | Trends 2027 | News | Trends 2028 | Business | Trends Wirtschaft | Effizienz | Künstliche Intelligenz
KI-Inferenzkosten pro agentenbasiertem Workflow steigen bis 2028 um mehr als das Fünffache

Agentenbasierte KI verspricht leistungsfähigere Anwendungen, verändert aber zugleich die Kostenlogik von KI-Produkten. Gartner warnt vor einem Inferenz-Paradoxon: Obwohl Token günstiger werden, steigen die Gesamtkosten, weil komplexere Workflows deutlich mehr und oft teurere Modellaufrufe benötigen. Management Summary: Gartner erwartet, dass die KI-Inferenzkosten pro agentenbasiertem Workflow bis 2028 um mehr als das Fünffache steigen. Sinkende Modell- und…
Trends 2027 | News | Business | Trends Wirtschaft | Digitalisierung | Trends Geschäftsprozesse | Favoriten der Redaktion | Strategien | Tipps
Wettbewerbsfähigkeit, Resilienz und Zukunftsfähigkeit 2027: 10 strategische Leittrends
Management Summary Die zehn strategischen Leittrends zeigen, dass digitale Transformation nicht mehr primär aus einzelnen Technologien besteht, sondern aus neuen Führungs-, Betriebs- und Wertschöpfungsmodellen. Für das Management ergibt sich daraus die Aufgabe, KI, Daten, Sicherheit, Automatisierung und Nachhaltigkeit nicht isoliert zu betrachten, sondern als miteinander verbundene Architektur für Wettbewerbsfähigkeit, Resilienz und Zukunftsfähigkeit zu steuern.…
Trends 2027 | News | Business | Business Process Management | Trends Wirtschaft | Digitale Transformation | Effizienz | Favoriten der Redaktion | Künstliche Intelligenz | Services | Strategien | Tipps
25 Top-Trends in der IT für 2027 und darüber hinaus

Die IT-Trends ab 2027 sind keine Spielwiese für Spezialisten mehr. Sie entscheiden darüber, ob Unternehmen schneller lernen, sicherer skalieren und aus Daten tatsächlich Wert schaffen. KI, Automatisierung, Cybersecurity und moderne Datenarchitekturen verschieben die Machtachse im Unternehmen: vom reinen Technologieeinsatz hin zur strategischen Führungsfrage. Wer jetzt nur Tools beschafft, wird Komplexität ernten. Wer Technologie, Governance und…
News | Business Process Management | Cloud Computing | Digitalisierung | Effizienz | Favoriten der Redaktion | Geschäftsprozesse | Künstliche Intelligenz | Lösungen | New Work | Strategien | Tipps
KI im Mittelstand: Es geht auch ohne Großprojekt

Mittelständische Unternehmen zögern oft mit der Einführung von künstlicher Intelligenz, weil sie langwierige und kostspielige Großprojekte befürchten. Mit dem richtigen Vorgehen sind diese Bedenken jedoch unbegründet. KMU können den Einstieg pragmatisch gestalten und anschließend durch die Wiederverwendung von Ressourcen den KI-Einsatz effizient ausweiten. Management Summary KI-Einstieg ohne Großprojekt: Mittelständische Unternehmen können mit einem klar…
News | Business | Business Process Management | Favoriten der Redaktion | Geschäftsprozesse | Künstliche Intelligenz | Strategien | Tipps
KI für KMU: Wenn Strategie und Umsetzung auseinanderdriften
Management Summary KI ist im Mittelstand kein Technologiethema mehr, sondern eine Führungsaufgabe. Entscheidend ist, dass Geschäftsführung, Fachbereiche und IT ein gemeinsames Zielbild entwickeln. Die größte Lücke entsteht zwischen Strategie und Umsetzung. Viele Projekte scheitern nicht an der Leistungsfähigkeit der Systeme, sondern an unklaren Rollen, fehlendem Prozesswissen und unrealistischen Erwartungen. Datenqualität ist der unterschätzte Hebel…
News | Business | Trends 2030 | Trends Wirtschaft | Favoriten der Redaktion | Künstliche Intelligenz | New Work
2031: Unternehmen erwarten eher sinkende Löhne durch Einsatz von künstlicher Intelligenz

Management Summary KI verändert Lohnstrukturen spürbar: Unternehmen erwarten bis 2031 häufiger sinkende als steigende Löhne, insbesondere dort, wo Tätigkeiten stark automatisierbar sind. Berufseinsteiger stehen unter Druck: Rund jedes zweite KI-nutzende Unternehmen rechnet bei Beschäftigten mit weniger als fünf Jahren Berufserfahrung mit niedrigeren Löhnen. Qualifikation wird zum Differenzierungsfaktor: Formale Abschlüsse, Erfahrung und KI-komplementäre Kompetenzen erhöhen…
Trends 2026 | News | Trends Infrastruktur | Effizienz | Infrastruktur | Künstliche Intelligenz | Whitepaper
95 Prozent der Unternehmen mussten KI-Projekte verschieben

Management Summary KI-Projekte scheitern nicht an Ambitionen, sondern an Datenrealität: 95 Prozent der Unternehmen mussten Initiativen wegen Governance-, Compliance- oder Regulierungsproblemen verschieben oder stoppen. Die bestehende IT-Architektur ist für Enterprise-KI oft nicht mehr ausreichend: 72 Prozent der Unternehmen sehen einen grundlegenden Umbau ihrer Datenarchitektur als notwendig an. Governance wird zur kritischen Infrastruktur: Verteilte Daten über…
News | Business Process Management | Effizienz | Favoriten der Redaktion | Geschäftsprozesse | Künstliche Intelligenz | Strategien
KI muss Geld verdienen: Warum Unternehmen ihre KI-Strategie neu denken müssen

Management Summary KI muss vom Experiment zum Geschäftsmodell werden: Der eigentliche Wert entsteht nicht durch einzelne Tools, sondern durch skalierbare Anwendungsfälle mit messbarem Beitrag zu Produktivität, Kundenerlebnis und Umsatz. Der Engpass liegt weniger in der Technologie als im Managementansatz: Erfolgreiche Initiativen starten mit einer klaren Business-Frage und nicht mit der Suche nach einem Problem…
Trends 2026 | News | Trends Wirtschaft | Digitalisierung | Geschäftsprozesse | Künstliche Intelligenz | Rechenzentrum
Die Billionen-Bremse der KI: Warum Content-Schulden jetzt zum Management-Risiko werden
Management Summary Content-Schulden werden zur Wachstumsbremse: Veraltete, schlecht strukturierte und schwer auffindbare Inhalte verursachen laut Studie weltweit Kosten in Billionenhöhe und gefährden messbare Umsatzanteile. KI macht das Problem sichtbar: Generative Suche und KI-Antwortsysteme greifen auf vorhandene Inhalte zurück – sind diese falsch, veraltet oder uneinheitlich, leidet die Markenwahrnehmung unmittelbar. Das Risiko ist nicht nur kommunikativ,…
Trends 2026 | News | Trends Security | IT-Security | Künstliche Intelligenz | Strategien | Tipps
Fast die Hälfte der KI-Nutzung in Unternehmen basiert auf ungesicherter Schatten-KI

Bericht thematisiert unautorisierte Anwendungen, neue Angriffsvektoren und erforderliche Sicherheitsstrategien. Management Summary Schatten-KI ist kein Randphänomen mehr: Fast jede zweite KI-Interaktion läuft über private Identitäten und entzieht sich damit Governance, Monitoring und Compliance. Die Angriffsfläche verlagert sich in den Browser und die Entwicklungsumgebung: Erweiterungen, KI-Coding-Assistenten und agentische Browser werden zu neuen Einfallstoren für Datenabfluss und…
News | Business | Business Process Management | Effizienz | Favoriten der Redaktion | Künstliche Intelligenz | Nachhaltigkeit | Rechenzentrum
Die Kosten von KI? Nicht, was Sie vermuten
Weshalb die Operationalisierung von Unternehmensdaten die nächste wirtschaftliche Herausforderung für produktive KI darstellt. Management Summary KI-Kosten entstehen nicht nur bei der Inferenz: Sinkende Token-Preise sind wichtig, lösen aber nicht die eigentliche Kostenfrage produktiver Enterprise AI. Datenzugriff wird zum zentralen Engpass: Der wirtschaftliche Nutzen von KI hängt davon ab, ob relevante Unternehmensinformationen auffindbar, zugreifbar und…