Ein Datenprodukt ist nicht fertig, wenn es bereitgestellt ist. Erst wenn Fachexperten seine Antworten bestätigen, Fehlerquellen systematisch geprüft und Definitionen versioniert sind, können Führungskräfte einem KI-Agenten vertrauen.
Management Summary
- Bereitstellung ist nicht das Ziel: Der Nutzen eines Datenprodukts ist erst belegt, wenn es nachweislich die tatsächliche Arbeit und Effizienz verbessert.
- Fachbereich als Maßstab: Fachexperten testen mit echten Fragen aus dem Arbeitsalltag und beurteilen Korrektheit und Vollständigkeit.
- Fehler strukturiert suchen: Erst Produktmetadaten, dann Spaltenbeschreibungen, zuletzt die Ansichtslogik prüfen.
- Nachvollziehbarkeit sichern: Metadaten gehören wie Code in die Versionskontrolle, damit jede Antwort rekonstruierbar bleibt.
- Governance von Anfang an: Rollen und Zugriffe pro Datenprodukt gehören in den Testplan, nicht erst dahinter.
Abbildung 1: Fachexperte und KI-Agent prüfen gemeinsam ein Datenprodukt
Datenprodukte im Praxistest – Warum die Arbeit erst nach der Bereitstellung beginnt
Wie Unternehmen KI-Datenprodukte in der Produktion testen, absichern und nachvollziehbar halten.
Die meisten Leitfäden zu Datenprodukten enden dort, wo die Arbeit erst richtig beginnt. Sie beschreiben, wie Unternehmen Daten beschaffen, aufbereiten, kuratieren und mit Metadaten versehen – und das Produkt schließlich bereitstellen. Das ist jedoch nur der Ausgangspunkt. Es folgt die unsichtbare Wartungsarbeit: der Nachweis, dass ein Datenprodukt Ergebnisse liefert, die ein Fachexperte absegnen würde. Erledigt ist die Arbeit erst, wenn belegt ist, dass das Produkt die tatsächliche Arbeit und die tatsächliche Effizienz verbessert. Starburst widmet sich diesem zweiten Teil. Das Unternehmen nutzt dazu Muster, die das Unternehmen bei der Vorbereitung von Datenprodukten für den eigenen internen Analyse-Agenten erarbeitet hat.
Eine grundsätzliche Definition vorab: Im Kern ist ein Datenprodukt eine kuratierte, zugängliche Hülle, die um hochwertige Datensätze herum aufgebaut und mit relevanten Metadaten angereichert ist. Datenprodukte sind so konzipiert, dass sie leicht auffindbar sind und konsistent genutzt werden können. Im Gegensatz zu Rohdaten werden Datenprodukte in der Regel mit einer spezifischen Absicht erstellt – meist für ein bestimmtes fachliches Team. Dieses Team erstellt die Daten und stellt deren Qualität, Dokumentation sowie die Bereitstellung für die weitere Nutzung sicher. Ein wesentliches Merkmal eines Datenprodukts ist daher, dass es mit klarer Verantwortlichkeit, Governance und einer festen Zuständigkeit verbunden ist.
Wenn sich Datenprodukte von der »Quelle der Wahrheit« lösen
Der Wert eines Datenprodukts hängt unmittelbar davon ab, wie es im Unternehmen genutzt wird. Dafür müssen Geschäftslogik und Kontext verstanden und in die Logik des Produkts übersetzt werden. Fehlt dieser Schritt, entsteht eine Diskrepanz zwischen dem Datenprodukt und dem Geschäft, das es abbilden soll.
Aus der Diskussion um semantische Ebenen ist das Problem bekannt: Eine erfolgreich ausgeführte Abfrage belegt nur, dass die SQL-Anweisung gültig war. Ob die Antwort zur Frage passt, bleibt offen. Bei Datenprodukten verhält es sich ebenso. Ein Produkt kann formal einwandfrei sein und gültige Ergebnisse liefern, ohne der Logik des Unternehmens zu entsprechen oder den erhofften Nutzen zu stiften. Diese Übereinstimmung zu prüfen, ist der erste Schritt bei der Frage, ob ein Datenprodukt in realen Umgebungen taugt.
KI beschleunigt alles, auch die Fehler. Ein KI-Agent übernimmt alles, was ein Produkt vorgibt, führt es mit voller Geschwindigkeit aus und liefert eine Antwort, die plausibel klingt, ob sie nun stimmt oder nicht. Menschen verfügen dagegen über natürliche Abwehrmechanismen: Sie bemerken, wenn eine Gesamtsumme nicht stimmt, kennen ungefähr die Zahlen des letzten Quartals und fragen Kollegen, wenn ihnen etwas seltsam vorkommt. Ein Agent hat diesen Instinkt nicht. Er akzeptiert die Logik des Produkts als »Ground Truth« und macht weiter.
Der Fachbereich als Maßstab
Am Anfang steht die Geschäftslogik des Unternehmens. Stimmt sie nicht, ist alles Weitere hinfällig. Der wirksamste Test ist deshalb zugleich der am wenigsten technische: Fachexperten prüfen das Produkt anhand der Fragen, die sie in ihrer täglichen Arbeit tatsächlich stellen. Synthetische Testabfragen eignen sich dafür nicht.
Zwei Gründe sprechen für diesen Ansatz:
- Vollständigkeit: Fachexperten beurteilen nicht nur, ob eine Antwort korrekt ist, sondern auch, ob sie vollständig ist. Eine Antwort kann richtig sein und dennoch Zeilen vermissen lassen. Dass eine Anzahl zu gering ausfällt, bemerkt nur, wer die Domäne kennt.
- Weiterentwicklung: Der Ansatz macht Fragen sichtbar, für die das Produkt nie konzipiert wurde, und weist damit die Richtung für die nächste Iteration.
Diese Prüfung ist Qualitätskontrolle und keine Formalität. Zum Agenten wird ein Produkt erst, wenn ein Experte seine Antworten anhand realer Fragen bestätigt hat. Alles davor ist Vorbereitung.
Wenn die Antwort plausibel wirkt und trotzdem falsch ist
Ein Beispiel: Ein Agent sollte die offenen Verkaufschancen eines Vertriebsleiters auflisten und nannte 13. Der Leiter wusste, dass es 17 waren. Der Agent war nicht abgestürzt, hatte keinen Fehler gemeldet und nichts sichtbar Falsches getan. Er hatte lediglich selbstbewusst die falsche Zahl geliefert.
Die Ursache lag in einem Flag für den Datensatztyp in der Ansichtslogik. Vertragsverlängerungen wurden durch eine Regel herausgefiltert, die beim Aufbau der Ansicht niemand als relevant markiert hatte. Das Modell hatte korrekt argumentiert, und die SQL-Abfrage lief einwandfrei. Das Datenprodukt hatte jedoch stillschweigend eine Annahme kodiert, die nicht zur gestellten Frage passte.
Entdeckt wurde der Fehler weder durch Tests noch durch den Agenten, sondern durch einen Menschen, der Kontext und Geschäftslogik kannte und wusste, dass die Antwort 17 lauten musste. Das ist das stärkste Argument für die Q&A-Runde mit Fachexperten: Ihr Verständnis von Geschäft und Problem muss die Logik des Datenprodukts fortlaufend korrigieren. Ohne sie bleibt der Fehler unbemerkt, die falsche Antwort wird ausgeliefert und fällt bei jeder ähnlichen Frage erneut falsch aus.
Fehlersuche an drei Stellen
Es ist nicht zielführend, jeden Fehler als Einzelfall zu behandeln. In der Praxis lässt sich die Ursache meist auf eine von drei Ebenen zurückführen. Wer diese der Reihe nach prüft, arbeitet statt einer endlosen Suche eine kurze Checkliste ab.
- Sie kodieren die Geschäftsregeln und den Kontext des Produkts. Zu klären ist, ob festgelegt ist, welche Kategorien ein- oder ausgeschlossen werden, und ob zwischen ähnlich aussehenden Kennzahlen mit unterschiedlicher Bedeutung unterschieden wird. Das ist die häufigste Fehlerquelle und zugleich die am leichtesten zu übersehende, weil die Daten auf den ersten Blick in Ordnung erscheinen.
- Sie regeln die Definitionen auf Feldebene der zugrunde liegenden Ansicht. Hat der Agent die Bedeutung einer Spalte falsch gedeutet, weil die Beschreibung zu knapp, lückenhaft oder irreführend war? Das ist die zweithäufigste Ursache.
- Hier geht es um die SQL-Abfrage selbst, einschließlich Filtern und Verknüpfungen. Regeln, die Datensätze unbemerkt aussortieren, wie im obigen Beispiel, haben hier ihren Ursprung. Diese Ursache ist die seltenste, wirkt aber am stärksten, weil die Zahlen in sich stimmig erscheinen und nichts auffällt.
Die Reihenfolge ist entscheidend. Teams verdächtigen instinktiv zuerst die SQL-Ebene, weil sie die technischste und undurchsichtigste ist. Tatsächlich versagen Metadaten und Spaltenbeschreibungen weit häufiger. Wer dort beginnt, wo sich die Fehler häufen, löst die meisten Probleme bereits in den ersten beiden Schritten.
Metadaten versionieren, sonst bleibt die Logik unerklärlich
Irgendwann wird eine Führungskraft fragen, warum der Agent eine bestimmte Antwort gegeben hat. Die ehrliche Auskunft muss dann zur Geschäftslogik des Unternehmens passen. Das ist unmöglich, wenn sich die Definitionen inzwischen geändert haben und niemand die Änderung dokumentiert hat.
Abhilfe schafft es, Metadaten mit derselben Disziplin zu behandeln wie Anwendungscode. Definitionen gehören in die Versionskontrolle und müssen mit der Abfrage-Engine synchronisiert werden, sodass jede Regel, auf die sich der Agent gestützt hat, zeitpunktgenau nachvollziehbar ist. Wird eine Antwort aus der Vorwoche hinterfragt, lässt sich exakt rekonstruieren, was der Agent damals wusste. Das Debugging wird so zur einfachen Suche statt zum archäologischen Projekt. Geschäftsmetadaten sind letztlich das, was Vertrauen in die Antwort schafft.
Governance gehört in den Testplan
Nach der Q&A-Phase mit den Fachexperten fühlt sich ein Datenprodukt fertig an, und es ist verlockend, es dabei zu belassen. Genau hier sind Abstriche jedoch am teuersten. Der Wert eines Datenprodukts liegt in seinen Skaleneffekten, und mit der Skalierung verbreiten und verschärfen sich auch Fehler. Einer davon betrifft die Governance.
Ein Agent übernimmt den Zugriffsbereich desjenigen, der ihn abfragt. Gewährt eine weit gefasste Analystenrolle bereits umfassenden Datenzugriff, macht ein Agent ohne strengere Kontrollen sensible Daten einem weitaus größeren Kreis zugänglich als beabsichtigt.
Die Lösung ist eine Rollenstruktur pro Datenprodukt, die gemeinsam mit den Daten- und Plattformteams entworfen wird, statt sie nachzurüsten, wenn der Agent längst läuft. Späte Governance bedeutet, Zugriffsmuster zurückzunehmen, auf die sich Nutzer bereits verlassen. Das ist deutlich schwieriger, als sie von Anfang an korrekt zu definieren. Governance gehört daher in den Testplan und nicht erst dahinter.
Der Validierungszyklus im Überblick
Ein zuverlässiger Validierungsdurchlauf umfasst sechs Schritte:
- Produkt und Metadaten zusammenstellen und sicherstellen, dass jedes vom Agenten genutzte Feld eine aussagekräftige Beschreibung hat.
- Gemeinsam mit dem Fachexperten die authentischen Fragen aus dessen Arbeitsalltag stellen.
- Bei jeder falschen oder unvollständigen Antwort nacheinander Produktmetadaten, Spaltenbeschreibungen und Ansichtslogik prüfen.
- Fehler beheben und dieselben Fragen erneut testen, bis die Antworten korrekt und vollständig sind.
- Zugriffskontrollen pro Produkt festlegen, bevor der Agent in Betrieb geht.
- Die gesamte Definition in der Versionskontrolle halten, damit jede künftige Antwort rekonstruierbar und erklärbar bleibt.
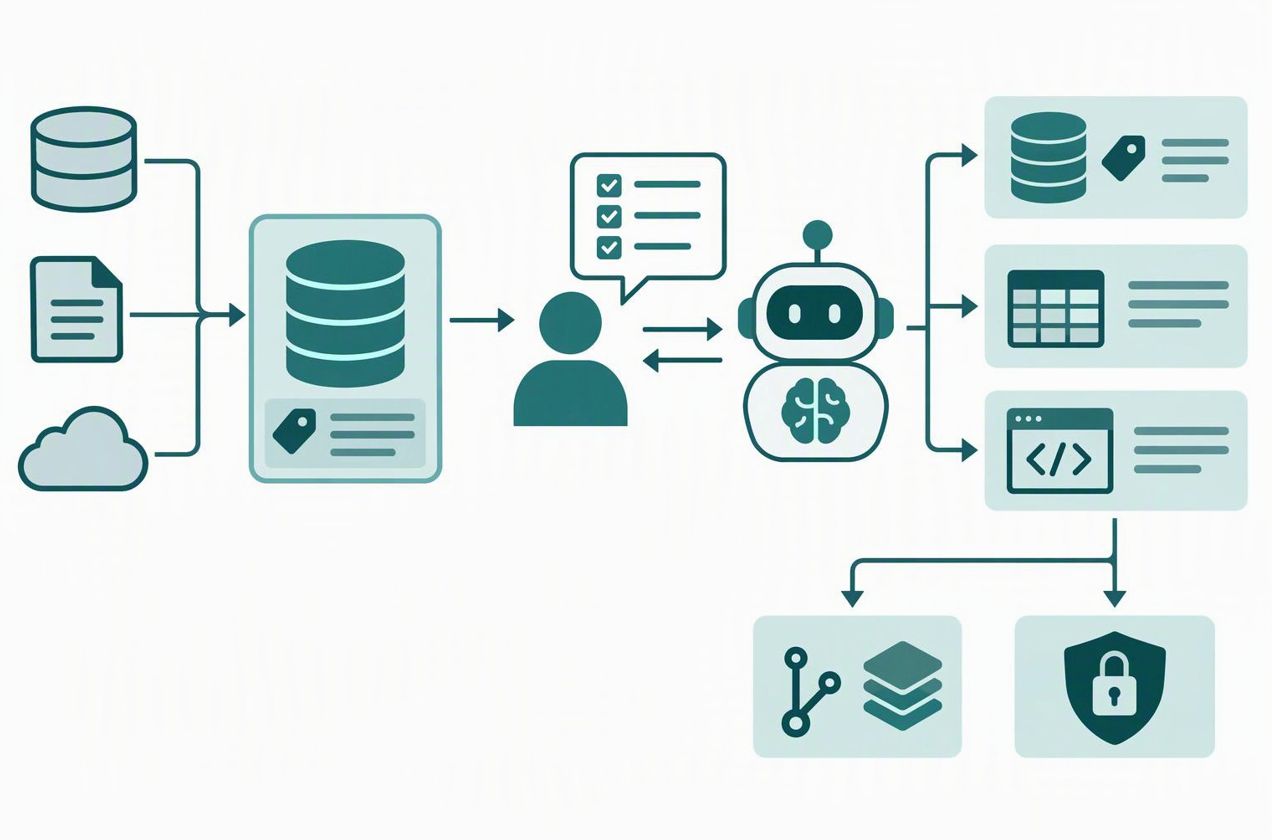
Abbildung 2: Der Validierungszyklus eines Datenprodukts – von der Prüfung durch Fachexperten über die Fehlersuche bis zu Versionierung und Governance
Fazit
Nichts davon ist glamourös, und genau darin liegt der Punkt. Die langsame, sorgfältige Arbeit des Testens und Nachverfolgens macht den Unterschied zwischen einem Datenprodukt, das Antworten liefert, und einem, auf dessen Grundlage Führungskräfte tatsächlich entscheiden können.
Tipps für die Praxis
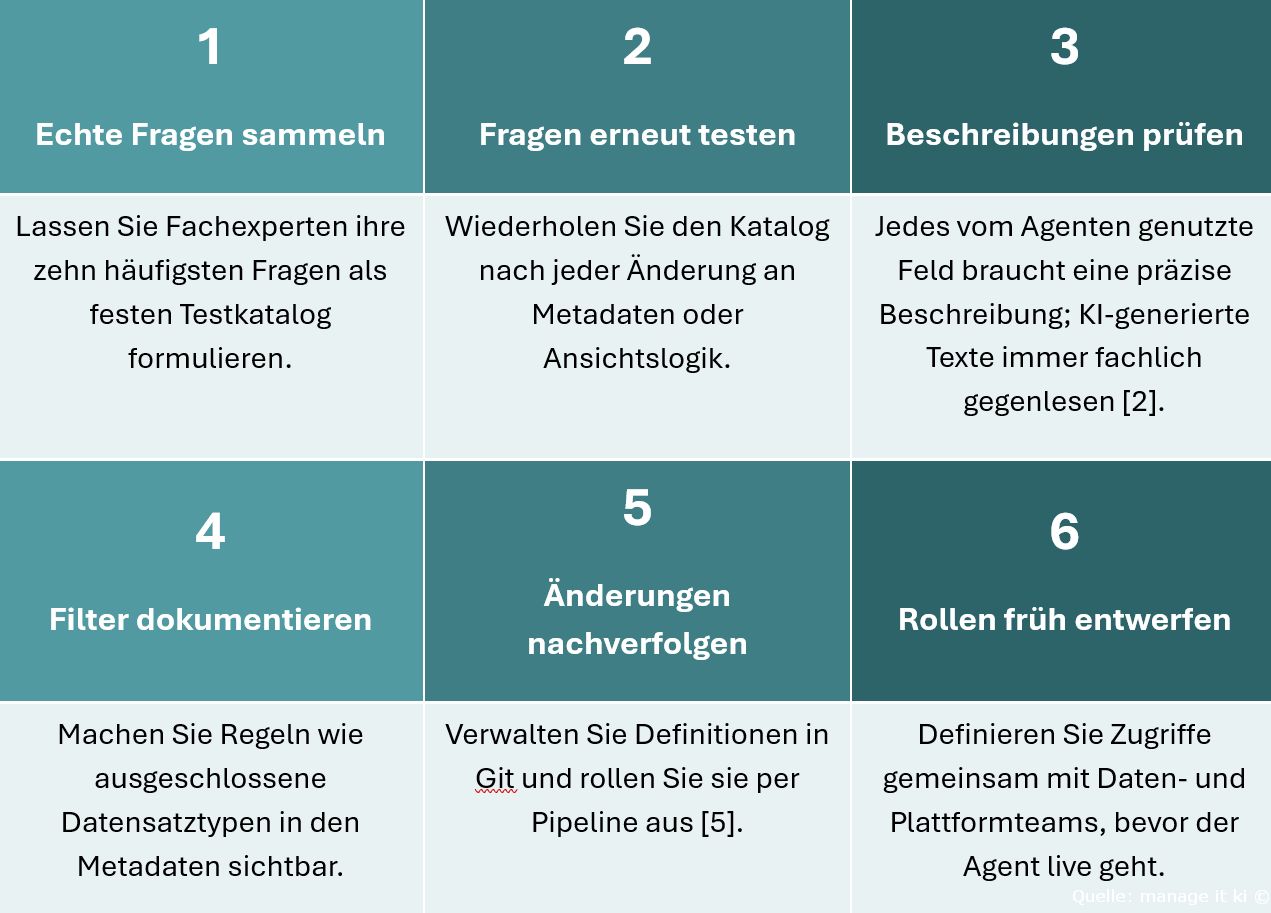
Die sechs wichtigsten Tipps auf einen Blick:
Hinweis: Die Praxisbeispiele sind illustrativ und stehen beispielhaft für typische Situationen.
-
Echte Fragen sammeln
Planen Sie einen etwa einstündigen Workshop mit dem Fachexperten. Halten Sie die Fragen wörtlich so fest, wie er sie im Alltag stellt, und notieren Sie zu jeder Frage die erwartete Antwort. Ergänzen Sie auch Fragen zur Vollständigkeit, etwa nach Anzahlen und Summen, die der Experte aus dem Kopf einschätzen kann.
Praxisbeispiel: Ein Vertriebsleiter formuliert: »Wie viele offene Verkaufschancen hat mein Team?« und weiß, dass die Antwort 17 lauten muss. Genau diese Frage samt Sollwert wird fester Bestandteil des Testkatalogs, denn sie hätte den Fehler mit den ausgefilterten Vertragsverlängerungen sofort sichtbar gemacht.
-
Fragen erneut testen
Behandeln Sie den Testkatalog wie einen Regressionstest: Nach jeder Änderung an Metadaten, Spaltenbeschreibungen oder Ansichtslogik laufen alle Fragen erneut durch. Dokumentieren Sie je Durchlauf, welche Antworten abweichen.
Praxisbeispiel: Ein Team passt den Filter für Vertragsverlängerungen an, damit die Pipeline vollständig ist. Beim erneuten Durchlauf liefert Frage 4 (Umsatz im Quartal) plötzlich einen anderen Wert. Weil der Katalog sofort Alarm schlägt, wird der Nebeneffekt vor der Veröffentlichung korrigiert statt erst vom Management bemerkt.
-
Beschreibungen prüfen
Gehen Sie alle vom Agenten genutzten Felder durch und stellen Sie sicher, dass jede Beschreibung Bedeutung, Einheit und Besonderheiten nennt. KI-Werkzeuge können Beschreibungen für Datenprodukte, Datensätze und Spalten vorschlagen, aus Metadaten und optional aus Stichproben. Diese Vorschläge ersetzen die fachliche Prüfung nicht [2].
Praxisbeispiel: Die Spalte »amount« hat keine Beschreibung, der Agent deutet sie als Bruttobetrag. Nach dem Gegenlesen steht dort: »Auftragswert netto in Euro, ohne Umsatzsteuer, Stand Vertragsabschluss.« Damit stimmt auch die Antwort auf Umsatzfragen.
-
Filter dokumentieren
Jede Regel, die Datensätze ein- oder ausschließt, gehört in die Metadaten, einschließlich Begründung und Hinweis, wo man die ausgeschlossenen Daten findet. So wird die Annahme sichtbar, bevor sie zu einer falschen Antwort führt.
Praxisbeispiel: Im Metadatenfeld des Datenprodukts steht: »Vertragsverlängerungen (Record Type = Renewal) sind ausgeschlossen. Für die Gesamtpipeline bitte das Produkt ›Vertrieb gesamt‹ verwenden.« Der Agent kann nun auf die Frage nach offenen Chancen korrekt darauf hinweisen oder das passende Produkt wählen.
-
Änderungen nachverfolgen
Verwalten Sie Definitionen wie Anwendungscode: Metadaten, Datensatzabfragen und Beschreibungen als Textdateien in Git, Änderungen per Review freigeben und per Pipeline ausrollen. Ein veröffentlichtes Beispiel strukturiert ein Datenprodukt in einen Ordner mit Datensatz-Abfragen, einer Metadatendatei und einer Beschreibungsdatei und rollt es über GitHub Actions aus [5].
Praxisbeispiel: Eine Führungskraft fragt, warum der Agent vor zwei Wochen 13 statt 17 genannt hat. Das Team öffnet den damaligen Stand im Repository und sieht, dass der Filter zu diesem Zeitpunkt noch aktiv war. Die Antwort ist in Minuten erklärt, statt tagelang zu rekonstruieren.
-
Rollen früh entwerfen
Entwerfen Sie die Rollenstruktur pro Datenprodukt gemeinsam mit Daten- und Plattformteams, bevor der Agent live geht. Prüfen Sie im Testplan, was Agenten mit den Rechten einer Rolle sehen können. Rollenbasierte Zugriffskontrolle, Spaltenmaskierung und Zeilenfilter lassen sich pro Datenprodukt durchsetzen [4].
Praxisbeispiel: Im Vertriebsprodukt sehen Regionalleiter nur Datensätze ihrer Region, personenbezogene Felder sind für alle außer dem Datenschutz-Team maskiert. Ein Testlauf mit der Rolle »Analyst Nord« bestätigt vor dem Start, dass der Agent keine Daten anderer Regionen ausgibt.
FAQ
- Was ist ein Datenprodukt? Eine kuratierte, zugängliche Hülle um hochwertige Datensätze, angereichert mit Metadaten, mit klarer Verantwortlichkeit und Governance [4].
- Warum reicht eine erfolgreich ausgeführte SQL-Abfrage nicht als Nachweis? Sie belegt nur, dass die Anweisung gültig war, nicht, dass die Antwort zur Frage und zur Geschäftslogik passt [1].
- Warum sollten Fachexperten testen und keine synthetischen Abfragen? Experten stellen reale Fragen, erkennen unvollständige Ergebnisse und zeigen, wofür das Produkt nie konzipiert wurde [1].
- In welcher Reihenfolge sucht man Fehler? Zuerst Produktmetadaten, dann Spaltenbeschreibungen, zuletzt die Ansichtslogik, da Metadaten und Beschreibungen häufiger versagen [1].
- Wie hilft KI bei der Dokumentation von Datenprodukten? Der Starburst AI Agent kann Beschreibungen für Datenprodukte, Datensätze und Spalten automatisch erzeugen; sie sollten fachlich geprüft werden [2].
- Welchen Einfluss haben Metadaten auf die Antwortqualität des Agenten? Je detaillierter die Metadaten eines Datenprodukts, desto besser kann die Antwortqualität des Agenten ausfallen [3].
- Wie lassen sich Datenprodukte versionieren? Datenprodukte bestehen aus SELECT-Anweisungen und Metadaten, die sich als Textdateien in Git verwalten und per Pipeline ausrollen lassen [5].
- Warum ist Versionierung für die Nachvollziehbarkeit wichtig? Nur so lässt sich später exakt rekonstruieren, welche Definitionen der Agent bei einer Antwort kannte [1].
- Warum gehört Governance in den Testplan? Ein Agent übernimmt den Zugriffsbereich des Abfragenden; ohne strenge Rollen werden sensible Daten zu breit zugänglich [1]. Rollenbasierte Zugriffskontrolle, Spaltenmaskierung und Zeilenfilter lassen sich pro Datenprodukt durchsetzen [4].
- Wann ist ein Datenprodukt bereit für den Agenten? Wenn ein Experte die Antworten anhand realer Fragen bestätigt hat und Zugriffe sowie Versionierung geregelt sind [1].
Quellen
[1] Starburst: A Practical Guide to Testing and Fixing AI Data Products, 21.08.2026, https://www.starburst.io/blog/a-practical-guide-to-testing-and-fixing-ai-data-products/
[2] Starburst: AI agent-based data product enrichment, https://docs.starburst.io/latest/starburst-ai/data-product-enrichment-ai.html
[3] Starburst Galaxy: Starburst AI Agent, https://docs.starburst.io/starburst-galaxy/starburst-ai/ai-agent.html
[4] Starburst: Data Products, https://www.starburst.io/solutions/data-products/
[5] ottensa: Data Products CI/CD (GitHub), https://github.com/ottensa/dataproducts-cicd-sep
Management Summary, Tipps, FAQ und Bilder wurden mit Hilfe von KI erstellt
4859 Artikel zu „Daten KI Vertrauen“
Business Process Management | Effizienz | Favoriten der Redaktion | Geschäftsprozesse | Künstliche Intelligenz | News | Strategien | Tipps
KI beginnt mit Vertrauen: Daten-Governance als Schlüssel zwischen Strategie und messbaren Resultaten
Der Erfolg von KI hängt weniger von Modellen als von vertrauenswürdigen, geschäftlich nutzbaren Daten ab, weshalb viele Initiativen an fehlender Daten‑Governance scheitern. Moderne Daten‑Governance wird dabei als Enabler verstanden, der Klarheit, Verantwortlichkeiten und Datenqualität schafft und KI so skalierbar und wirksam macht. Entscheidend ist ein dynamischer Data‑First‑Ansatz, der Governance als kontinuierliches Change Management etabliert und…
Business | Business Process Management | Geschäftsprozesse | Künstliche Intelligenz | News | Trends 2026 | Trends Geschäftsprozesse | Trends Services
Vertrauen in KI wächst schneller als Einsatzbereitschaft – Defizite bei Datenintegrität bleiben bestehen

Es gibt Lücken in Bezug auf operative Reife, Datenvertrauen und Fähigkeiten auf, wenn Unternehmen versuchen, KI unternehmensweit zu skalieren. Es existiert eine wachsende Diskrepanz bei der Einschätzung der Unternehmen hinsichtlich ihrer KI-Bereitschaft. Die Führungskräfte sind überwiegend davon überzeugt, dass sie für KI bereit sind, doch ihre Antworten deuten auf grundlegende Lücken hin, die den…
Ausgabe 7-8-2025 | Business | Digitale Transformation | Künstliche Intelligenz | News | Strategien
Finanzdaten: Eine Baustelle mit Fortschrittspotenzial – Vertrauen, Resilienz und KI sind Schlüsselfaktoren der Finanztransformation

Finanzorganisationen stehen vor einem tiefgreifenden Wandel, von dem auch die Rolle des CFOs betroffen ist. Er wird immer mehr zum strategischen Partner, der auf Augenhöhe mit dem CEO und CIO agiert. Eine unabhängige weltweite Umfrage unter 1.300 Führungskräften von Censuswide, die von BlackLine in Auftrag gegeben wurde, liefert Einblicke in die Herausforderungen und Chancen, mit denen sich die Finanzabteilungen von Unternehmen auseinandersetzen müssen [1].
Business | Business Intelligence | Künstliche Intelligenz | News | Strategien | Trends 2024 | Whitepaper
Probleme mit dem Datenvertrauen führen zu negativen Auswirkungen auf Daten- und KI-Initiativen
Precisely, Anbieter von Datenintegrität, veröffentlichte eine neue Studie, die in Zusammenarbeit mit dem Center for Applied AI and Business Analytics am LeBow College of Business der Drexel University (Drexel LeBow) durchgeführt wurde [1]. Die wichtigsten Erkenntnisse aus dem diesjährigen »2025 Outlook: Data Integrity Trends and Insights« beleuchten die drängendsten Herausforderungen, denen sich Unternehmen bei der…
Business | Künstliche Intelligenz | News | Trends 2022 | Trends Wirtschaft
Mehr als 460 Milliarden Dollar zusätzlicher Gewinn durch bessere Datenpraktiken, Vertrauen in künstliche Intelligenz (KI) und Geschäftsintegration

Gemeinsam besser: Studie zeigt, dass Unternehmen KI und Daten bündeln müssen, um einen strategischen Wert zu schaffen. Nach der neuen Studie des Infosys Knowledge Institute, dem Thought-Leadership- und Forschungszweig von Infosys, können Unternehmen über 460 Milliarden US-Dollar an zusätzlichen Gewinnen erwirtschaften, wenn sie die drei nachfolgenden Dinge beherzigen: Datenpraktiken verbessern, auf künstliche Intelligenz (KI)…
Business Process Management | Digitale Transformation | IT-Security | Künstliche Intelligenz | News | Strategien | Tipps
Dezentralisierte KI-Governance: Verantwortung teilen, Kontrolle behalten
KI wird zur Aufgabe des gesamten Unternehmens – ihre Steuerung darf deshalb nicht am Freigabeschreibtisch der IT enden. Fachbereiche brauchen Handlungsspielraum, zentrale Teams verbindliche Standards und klare Eskalationswege. Entscheidend ist eine Governance, die Verantwortung dorthin verlagert, wo Anwendungen entstehen, ohne Sicherheit und Compliance aus der Hand zu geben. Für das Management zählt dabei nicht die…
Business | Künstliche Intelligenz | News | Strategien
KI und Berufseinstieg: Zwischen Entwarnung und strukturellen Warnsignalen
KI-generierte Symbolillustration: Berufseinstieg im technologischen Wandel. KI verändert den Berufseinstieg – doch pauschaler Stellenabbau wäre die falsche Schlussfolgerung. Die deutschen Beschäftigungsdaten zeigen bislang keinen allgemeinen Einbruch in KI-exponierten Berufen, wohl aber Warnsignale für junge Beschäftigte. [1] Für Geschäftsführung, CIOs und Personalverantwortliche geht es deshalb um mehr als Effizienz: Einstiegswege sichern, Kompetenzen aufbauen und Automatisierung…
IT-Security | Künstliche Intelligenz | News | TechTalk | Tipps
TechTalk: IT-Sicherheit und KI – was können Unternehmen tun?
Auf der it-sa 2026 in Nürnberg konnten wir Dr. Yvonne Bernard, Chief Technology Officer von Hornetsecurity by Proofpoint, drei Fragen zu ihrer Einschätzung der aktuellen Sicherheitsbefindlichkeiten in den Unternehmen stellen.
Business Process Management | Geschäftsprozesse | IT-Security | Künstliche Intelligenz | News | Services | Strategien | Tipps
Wenn KI Unternehmen schneller macht – und zugleich verwundbarer
KI beschleunigt das Geschäft – Resilienz hält es am Laufen. Sicherheit der gesamten Unternehmensstruktur aus Systemen, Partnern und Prozessen wird immer wichtiger. Generative KI macht Unternehmen schneller. Doch wenn Entscheidungen automatisiert und Prozesse enger vernetzt werden, können sich auch Fehler und Störungen rascher ausbreiten. Deshalb reicht es nicht, Angriffe möglichst abzuwehren: Unternehmen müssen kritische…
Business Process Management | Cloud Computing | Effizienz | Infrastruktur | Künstliche Intelligenz | News | Rechenzentrum | Strategien | Tipps
Von der GPU-KI-Infrastruktur zur Token Factory: Warum bei KI das Ergebnis zählt
Mehr GPUs und günstigere Token allein machen KI noch nicht wirtschaftlich. Mit agentischen Anwendungen wächst der Aufwand für mehrstufige Prozesse, wechselnde Lasten und verlässliche Ergebnisse. Das Betriebsmodell der Token Factory verbindet Ressourcenmanagement, Inferenzoptimierung und Servicequalität. Für IT-Verantwortliche rückt damit eine andere Frage in den Mittelpunkt: Was kostet eine erfolgreich erledigte Aufgabe – und welche Architektur…
IT-Security | News | Trends 2026 | Trends Security
Die Ransomware-Basics sitzen – aber nur 55 Prozent vertrauen ihrer eigenen Abwehr
Ransomware-Betroffenheit sinkt: rund 18 Prozent der Befragten nach 24 Prozent im Vorjahresreport. Ransomware-Vorsorge ist weit verbreitet: 91 Prozent schützen ihre Backups, 84 Prozent haben einen Disaster-Recovery-Plan. Phishing bleibt häufigstes Einfallstor: 52 Prozent der Ransomware-Betroffenen nennen E-Mail oder Phishing als Angriffsvektor. Security Awareness legt zu: 84 Prozent bieten Trainings an – zehn Prozentpunkte mehr als im…
Business Process Management | Digitale Transformation | Favoriten der Redaktion | Künstliche Intelligenz | New Work | News | Trends 2026 | Trends 2030 | Trends Wirtschaft
KI wird bis 2030 netto 1,7 Millionen Arbeitsplätze schaffen

KI und Arbeitsplätze: Positive Bilanz, tiefgreifender Wandel KI dürfte nach Gartner bis 2030 weltweit mehr Arbeitsplätze schaffen als verdrängen. Doch die positive Nettobilanz von 1,7 Millionen Stellen verdeckt den größeren Umbruch: Mehr als 20 Prozent der Beschäftigten sollen ihre Aufgaben und Arbeitsweisen anpassen müssen. Für Geschäftsführung, CIOs und Personalverantwortliche geht es deshalb nicht nur um…
Business Process Management | Digitale Transformation | Künstliche Intelligenz | News | Strategien | Tipps | Trends 2026 | Trends Geschäftsprozesse
KI auf Erfolgskurs, Unternehmen im Stresstest: Deutschlands neue Readiness-Lücke

KI schafft messbaren Nutzen, erhöht aber zugleich die Anforderungen an Unternehmen: 56 Prozent der deutschen Befragten berichten von positiven Erträgen ihrer KI-Investitionen, während die durchschnittliche vollständige Bereitschaft für externe Risiken bei nur 25 Prozent liegt. Der Kyndryl Readiness Report 2026–27 zeigt, warum eine modernisierte IT allein nicht genügt. Für Geschäftsführung und CIOs geht es jetzt…
Business | Favoriten der Redaktion | Geschäftsprozesse | Kommunikation | New Work | News | Services | Tipps
Skill-Management als Wettbewerbsvorteil: Von der reinen Personalentwicklung zur Unternehmenssteuerung

Management Summary Skills gehören auf die Managementagenda. Fehlende Fähigkeiten gefährden Lieferfähigkeit, Qualität und Innovation. Entscheidend ist nicht allein die Personalstärke, sondern die Passung zwischen Aufgabe, Qualifikation und Einsatzzeitpunkt. Das Business definiert den Bedarf, HR schafft den Rahmen. Fachbereiche benennen geschäftskritische Fähigkeiten; HR übersetzt sie in Recruiting, Entwicklung und interne Mobilität. Klare Verantwortlichkeiten verhindern ein isoliertes…
Business | Business Process Management | Digitale Transformation | Effizienz | Favoriten der Redaktion | Künstliche Intelligenz | New Work | News | Services | Strategien | Tipps
Die größte Herausforderung für CIOs: KI-Nutzen, Risiken und Sicherheit in Einklang bringen

KI soll Wertschöpfung beschleunigen – darf aber nicht schneller Risiken aufbauen als Nutzen. Für CIOs wird deshalb die Verbindung von Geschäftszielen, Sicherheitskontrollen und klaren Entscheidungsrechten zum Prüfstein. Gartners Value-Risk Flywheel liefert dafür ein Denkmodell: Gute Dynamik stärken, schädliche Dynamik begrenzen und Kontrolle dort verankern, wo KI tatsächlich auf Daten und Prozesse zugreift. Management Summary Geschäftswert…
Business Process Management | Digitalisierung | Geschäftsprozesse | Kommunikation | Künstliche Intelligenz | Marketing | News | Services | Tipps
KI verändert die Customer Journey: Datenqualität wird zur Managementaufgabe
KI-Antwortsysteme verändern den Weg vom ersten Informationsbedarf bis zum Kauf. Doch zwischen Anspruch und Umsetzung klafft eine Lücke: Laut Lünendonk wollen 79 Prozent der befragten Unternehmen mehr in Digital Experience investieren, während erst ein Drittel generative KI zur Steuerung der gesamten Customer Journey nutzt. [1] Für IT- und Geschäftsverantwortliche heißt das: Daten, Prozesse und Sichtbarkeit…
Business Process Management | Digitale Transformation | Künstliche Intelligenz | News | Strategien | Tipps | Trends 2026 | Trends Geschäftsprozesse | Trends Infrastruktur
Deutsche Unternehmen überschätzen ihre KI-Reife

86 Prozent der Entscheider sagen, ihr Unternehmen stelle sich öffentlich KI-reifer dar, als es ist. Weltweit sind es 75 Prozent. KI-Reife zeigt sich nicht im Selbstbild, sondern im Geschäftsergebnis. Die vorliegenden Studienergebnisse machen deutlich, wie weit Anspruch und Umsetzung auseinanderliegen. Für Geschäftsführung und IT-Verantwortliche wird damit die organisatorische Veränderung zur entscheidenden Aufgabe: Prozesse neu gestalten,…
IT-Security | Künstliche Intelligenz | News | Tipps | Trends 2026 | Trends Security
Angreifer missbrauchen vertrauenswürdige KI- und IT-Tools für Attacken gegen Unternehmen

KI-Agenten beschleunigen Geschäftsprozesse – und eröffnen Angreifern neue Wege in die Unternehmens-IT. Der Elastic-Bericht »Threats, etc.« beschreibt den Missbrauch legitimer KI-Anwendungen, signierter Fernwartungstools und gestohlener Zugangsdaten. Für IT-Verantwortliche lautet die Konsequenz: Nicht die Freigabe einer Software entscheidet über Sicherheit, sondern ihr tatsächliches Verhalten. Gefragt sind begrenzte Rechte, systemübergreifende Transparenz und schnelle Reaktionsprozesse. [1] Management Summary…
Business | Favoriten der Redaktion | IT-Security | Künstliche Intelligenz | News | Tipps | Trends 2026 | Trends Security
KI-Agenten ohne Kontrolle: Warum Unternehmen ihre KI-Identitäten jetzt steuern müssen

KI-Agenten beschleunigen Abläufe, greifen auf Unternehmensdaten zu und übernehmen zunehmend eigenständige Aufgaben. Doch ihr Handlungsspielraum wächst schneller als die passenden Sicherheitskontrollen. Die globale SailPoint-Studie verdeutlicht diese Lücke. Für IT-Verantwortliche kommt es jetzt darauf an, Transparenz, eindeutige Zuständigkeiten und begrenzte Zugriffsrechte miteinander zu verbinden – damit aus Automatisierung kein Kontrollverlust wird. [1, 3] Management Summary Governance…
Business | Business Process Management | Geschäftsprozesse | Künstliche Intelligenz | New Work | News | Services | Strategien | Tipps | Whitepaper
KI-Wertschöpfung: Europas KI-Chance liegt nicht nur im besten Modell

KI muss sich im Prozess rechnen, nicht nur im Benchmark glänzen. Eine Studie der Bertelsmann Stiftung zeigt: In Softwareentwicklung, Bankgeschäft und Private Equity sind Produktivitätsgewinne bislang besser belegt als neue Erlöse. Leistungsfähige Open-Weight-Modelle erweitern dabei die Auswahl – oft zu niedrigeren Nutzungspreisen. Für CIOs zählt deshalb das Zusammenspiel von Qualität, Gesamtkosten, Daten und Governance. [1]…