
Ein neues Architektur- und Betriebsmodell für durchgängige Cyberresilienz
Illustration Absmeier foto ki designer
DevSecResOps © verbindet sichere Softwarebereitstellung, laufende Überwachung und vertrauenswürdige Wiederherstellung zu einem gemeinsamen Betriebsmodell.
DevSecOps beschleunigt die sichere Bereitstellung digitaler Produkte. Resilience Operations, kurz ResOps, sorgt dafür, dass geschäftskritische Dienste auch unter Störung kontrolliert weiterlaufen oder rasch wiederhergestellt werden. DevSecResOps © führt beide Disziplinen zu einem gemeinsamen Architekturprinzip zusammen: Sicherheit, Betriebsfähigkeit und Wiederherstellbarkeit werden von Beginn an entworfen, automatisiert geprüft und im laufenden Betrieb kontinuierlich verbessert.
Management Summary
- DevSecResOps erweitert das Zielbild: Nicht nur sicher ausliefern, sondern Angriffe, Ausfälle und Fehlkonfigurationen beherrschen und nachweisbar wiederherstellen.
- Resilienz wird zur Architektureigenschaft: Wiederanlaufziele, Abhängigkeiten, saubere Wiederherstellungspunkte und alternative Betriebswege fließen in Entwurf und Backlog ein.
- Eine gemeinsame Kontrollkette verbindet Build und Run: Code, Artefakte, Konfigurationen, Telemetrie, Backups und Recovery-Pläne werden versioniert, geprüft und korreliert.
- Automatisierung braucht sichere Leitplanken: Pipelines prüfen nicht nur Schwachstellen, sondern auch Wiederherstellbarkeit, Datenintegrität und die Wirksamkeit von Notfallverfahren.
- Erfolg misst sich am Geschäftsdienst: Entscheidend sind unter anderem Wiederherstellungszeit, tolerierbarer Datenverlust, Änderungsrisiko und die Dauer bis zu einer belastbaren Lageeinschätzung.
 Vom Shift Left zum durchgängigen Resilienzzyklus
Für den täglichen Betrieb gilt ein risikobasierter Mindestumfang. Nicht jede Kontrolle wird bei jeder Änderung vollständig ausgeführt. Kritische Dienste benötigen automatisierte Basisprüfungen in der Pipeline, aktuelle Betriebs- und Recovery-Anweisungen sowie regelmäßig geplante Restore- und Störungstests. Aufwendige Clean-Room-Wiederherstellungen, Angriffssimulationen und vollständige End-to-End-Übungen werden nach Kritikalität, Änderungsrisiko und regulatorischen Anforderungen terminiert. Ausnahmen erhalten einen Eigentümer, eine Begründung und ein Ablaufdatum.
DevSecOps hat die Sicherheitsarbeit näher an Architektur, Entwicklung und Auslieferung gerückt. Bedrohungsmodellierung, automatisierte Tests, Richtlinien als Code und abgesicherte Lieferketten sollen verhindern, dass Risiken erst kurz vor dem Go-live sichtbar werden. Das Prinzip ist unverzichtbar, beantwortet aber nur einen Teil der betrieblichen Realität. Auch gut entwickelte Systeme können durch unbekannte Schwachstellen, kompromittierte Identitäten, fehlerhafte Änderungen, Ausfälle von Abhängigkeiten oder gezielte Datenmanipulation beeinträchtigt werden.
ResOps setzt an diesem Punkt an. Die Disziplin verbindet Security, IT-Betrieb, Plattformteams, Daten- und Backup-Verantwortliche sowie Fachbereiche in abgestimmten Abläufen. Im Mittelpunkt stehen belastbare Daten, die Eindämmung von Vorfällen, kontinuierlich validierte Recovery-Verfahren und ein Wiederanlauf entlang geschäftlicher Prioritäten. DevSecResOps verknüpft diese Perspektive mit DevSecOps und schließt damit die Lücke zwischen sicherer Veränderung und sicherer Wiederherstellung.
Was DevSecResOps bedeutet
DevSecResOps ist ein Architektur- und Betriebsprinzip für digitale Dienste. Es ergänzt bestehende DevSecOps-, Security-, Betriebs- und Wiederherstellungsprozesse, indem vier Fähigkeiten gemeinsam geplant werden: Veränderungen reproduzierbar bereitstellen, Risiken früh erkennen, Störungen begrenzen und den vertrauenswürdigen Betrieb kontrolliert wiederherstellen. Jede Änderung soll deshalb risikoadäquat nicht nur auf Funktion und Sicherheit, sondern auch auf Beobachtbarkeit, Reversibilität und Wiederanlauffähigkeit geprüft werden.
Gegenüber klassischem DevSecOps erweitert sich der betrachtete Verantwortungsbereich über die erfolgreiche Bereitstellung hinaus bis zur nachweisbaren Funktionsfähigkeit des Dienstes unter realistischen Störungen. Gegenüber traditionellem Notfallmanagement beginnt die Resilienzarbeit früher: nicht erst mit Runbooks und Wiederanlaufplänen, sondern bereits bei Anforderungen, Datenmodellen, Schnittstellen und Deployment-Strategien. Die organisatorische Verantwortung bleibt dabei auf Produkt-, Plattform-, Security-, Betriebs- und Fachverantwortliche verteilt.
Sieben Architekturprinzipien
- Geschäftsdienste statt Einzelsysteme betrachten. Schutzbedarf, Abhängigkeiten und Wiederanlaufreihenfolge werden aus Sicht eines End-to-End-Dienstes modelliert.
- Secure, observable and recoverable by design. Sicherheitskontrollen, Telemetrie, Isolation, Datenwiederherstellung und alternative Betriebswege gehören in die Architekturentscheidung.
- Unveränderlichkeit und Nachweisbarkeit. Artefakte, Konfigurationen, Protokolle und geschützte Wiederherstellungspunkte müssen manipulationsgeschützt und revisionsfähig sein.
- Explizite Degradationsmodi. Dienste definieren, welche Kernfunktionen bei Teilstörungen verfügbar bleiben, welche Schnittstellen abgeschaltet und welche Daten nur lesend bereitgestellt werden.
- Automatisierung mit kontrollierter Rückfallebene. Systeme dürfen automatisiert reagieren, benötigen aber nachvollziehbare Freigaben, Abbruchkriterien und manuelle Notverfahren.
- Zero Trust auch für Recovery. Wiederherstellungsumgebungen dürfen kompromittierten Identitäten, Images oder Konfigurationen nicht ungeprüft vertrauen.
- Kontinuierliche Validierung. Architekturannahmen werden durch Restore-Tests, Game Days, Chaos-Experimente und Angriffssimulationen regelmäßig überprüft.
Die Referenzarchitektur: vier eng gekoppelte Ebenen
1. Produkt- und Anwendungsebene
Auf dieser Ebene werden Missbrauchsszenarien, Datenklassifikation, Fehlergrenzen und Wiederanlaufziele als Anforderungen formuliert. Anwendungen verwenden definierte Identitäts- und Geheimnisdienste, liefern strukturierte Telemetrie und unterstützen sichere Rücksetz- oder Roll-forward-Verfahren. Kritische Transaktionen benötigen Idempotenz, konsistente Wiederholbarkeit und überprüfbare Kompensationsmechanismen.
2. Plattform- und Lieferkettenebene
Die Plattform stellt gehärtete Laufzeitumgebungen, standardisierte Deployments, signierte Artefakte, Richtlinien als Code und isolierte Sicherungsräume bereit. Build-Provenienz, Komponentenverzeichnisse und freigegebene Basiskonfigurationen schaffen Transparenz. Progressive Auslieferung, Feature Flags und automatisierte Rollbacks begrenzen den Radius fehlerhafter Änderungen.
3. Daten- und Recovery-Ebene
Backups allein reichen nicht. DevSecResOps fordert klassifizierte Datenbestände, unveränderbare Sicherungskopien, getrennte Vertrauensdomänen, regelmäßige Integritätsprüfungen und wiederholbare Wiederherstellung. Ein Clean Room ermöglicht die Analyse und den Neuaufbau kritischer Systeme, ohne kompromittierte Komponenten ungeprüft zu übernehmen.
4. Steuerungs- und Beobachtungsebene
Richtlinien definieren, wann ein Deployment gestoppt, ein Dienst isoliert, ein Wiederherstellungspunkt verworfen oder ein Krisenstab aktiviert wird. Automatische Maßnahmen werden auf reversible, vorab getestete Reaktionen mit belastbaren Signalen begrenzt. Maßnahmen mit hoher Geschäftswirkung erfordern eine benannte Entscheidungsrolle, dokumentierte Abbruchkriterien und einen manuellen Rückfallweg.
Der DevSecResOps-Lebenszyklus
Planen: Produktverantwortliche, Architektur, Security und Betrieb definieren gemeinsam Schutzbedarf, tolerierbare Ausfallzeiten, tolerierbaren Datenverlust, Degradationsmodi und regulatorische Nachweise. Diese Vorgaben werden als überprüfbare Akzeptanzkriterien in Epics und Stories übersetzt.
Entwickeln und bauen: Quellcode, Infrastrukturdefinitionen, Identitätsrichtlinien und Recovery-Automationen werden versioniert. Prüfungen umfassen Code- und Komponentenanalyse, Geheimniserkennung, Signaturkontrollen, Konfigurationsregeln sowie Tests auf Wiederholbarkeit und sichere Fehlerbehandlung.
Testen und bereitstellen: Neben Funktions- und Sicherheitstests werden Fehlerbilder, Datenkorruption, Ausfall von Abhängigkeiten und der Wiederaufbau aus geschützten Kopien geprüft. Deployments erfolgen schrittweise; beobachtete Risiken können die Auslieferung automatisch stoppen oder eine Rückkehr zur letzten vertrauenswürdigen Version auslösen.
Betreiben, reagieren und lernen: Laufzeitüberwachung erkennt Abweichungen und bewertet deren Dienstwirkung. Im Vorfall arbeiten Entwicklung, Plattform, Security Operations und Recovery-Verantwortliche in einem gemeinsamen Takt. Erkenntnisse fließen anschließend als neue Kontrollen, Architekturentscheidungen und Tests zurück in den Backlog.
Von der CI/CD-Pipeline zur Resilience Pipeline
|
Kontrollpunkt |
Prüffrage |
Beispiel für Evidenz |
|
Design |
Sind Bedrohungen, Abhängigkeiten und Wiederanlaufziele dokumentiert? |
Architekturentscheidung, Datenfluss, Dienstlandkarte |
|
Build |
Ist das Artefakt vertrauenswürdig und reproduzierbar? |
Signatur, Provenienz, Komponentenverzeichnis |
|
Pre-Release |
Funktioniert der Dienst bei Teilstörungen und lässt er sich sauber zurücksetzen? |
Fehlertest, Rollback-Protokoll, Restore-Nachweis |
|
Deployment |
Kann eine riskante Änderung früh begrenzt werden? |
Canary-Metriken, Freigaberegeln, Abbruchkriterien |
|
Run |
Werden Angriffe, Fehlzustände und Datenabweichungen rechtzeitig erkannt? |
Telemetrieabdeckung, Alarmqualität, Dienststatus |
|
Recovery |
Ist der gewählte Wiederherstellungspunkt nach den verfügbaren Integritätsprüfungen, Erkennungsregeln und Untersuchungsbefunden hinreichend vertrauenswürdig, und ist das verbleibende Risiko dokumentiert? |
Integritätsprüfung, Malware-Analyse, Clean-Room-Freigabe |
Operating Model: gemeinsame Verantwortung ohne Zuständigkeitslücken
DevSecResOps verlangt keine Auflösung bestehender Teams, wohl aber eine gemeinsame Ergebnisverantwortung mit eindeutigen Entscheidungsrechten. Produktteams verantworten die Resilienzeigenschaften ihres Dienstes. Plattformteams liefern sichere Standardpfade und Wiederherstellungsbausteine. Security definiert risikobasierte Leitplanken und unterstützt die Untersuchung. Eine klar benannte Recovery-Funktion koordiniert Datenintegrität, Wiederanlauf und Validierung. Fachbereiche priorisieren kritische Geschäftsprozesse, genehmigen zulässige Degradationen und erteilen die Geschäftsfreigabe für den Wiederanlauf.
Praktisch eignet sich ein föderiertes Modell: Ein kleines Enablement-Team pflegt Referenzarchitektur, Kontrollkatalog, Metriken und wiederverwendbare Übungsszenarien. Domänenteams setzen diese Vorgaben risikoadäquat um. Ein Resilience Review prüft kritische Dienste und wesentliche Ausnahmen in einem zur Kritikalität passenden Rhythmus; operative Detailfragen verbleiben in den bestehenden Produkt- und Betriebsprozessen. Im Vorfall gilt ein vorher festgelegtes Entscheidungsmodell für Isolation, Wiederherstellung und Geschäftsfreigabe.
Die wichtigsten Artefakte
- Service Resilience Profile: Kritikalität, Eigentümer, Abhängigkeiten, Schutzbedarf, Wiederanlaufziele und zulässige Degradationen.
- Resilience Backlog: priorisierte Maßnahmen aus Bedrohungsmodellen, Vorfällen, Restore-Tests und Architekturabweichungen.
- Golden Recovery Path: getesteter Standardablauf für Isolation, Identitätsneustart, Datenprüfung, Wiederaufbau und Geschäftsfreigabe.
- Evidence Store: manipulationsgeschützte Sammlung von Entscheidungen, Prüfergebnissen, Artefaktprovenienz und Recovery-Nachweisen.
- Dependency Graph: aktuelle Darstellung technischer und geschäftlicher Abhängigkeiten einschließlich externer Dienste.
- Resilience Scorecard: wenige, gemeinsam interpretierte Kennzahlen für Leitung, Produktteams und Betrieb.
Kennzahlen, die Verhalten steuern
Ein DevSecResOps-Kennzahlensystem darf weder die Zahl gefundener Schwachstellen noch eine isolierte Verfügbarkeitsquote zum Hauptziel machen. Sinnvoll ist ein ausgewogener Satz aus Veränderungs-, Sicherheits- und Wiederherstellungsmetriken: Anteil kritischer Dienste mit validiertem Recovery-Pfad, Zeit bis zur belastbaren Lageeinschätzung, Zeit bis zur Eindämmung, tatsächliche Wiederherstellungszeit, erreichter Datenstand, Erfolgsquote von Restore-Tests, Anteil signierter Artefakte, Richtlinienausnahmen, Abdeckungsgrad der Telemetrie und Änderungsfehlerquote.
Wichtig ist die gemeinsame Interpretation. Eine kurze Wiederherstellungszeit ist nur dann wertvoll, wenn der wiederhergestellte Zustand integer ist. Eine hohe Deployment-Frequenz ist nur dann ein Fortschritt, wenn Änderungen kontrolliert begrenzt und zurückgenommen werden können. Kennzahlen sollten deshalb Trends und Abweichungen sichtbar machen, nicht Teams gegeneinander ausspielen.
Fallbeispiel: kompromittierte Softwarekomponente
Ein Unternehmen entdeckt, dass eine häufig genutzte Bibliothek in mehreren Diensten kompromittiert ist. Ein reines DevSecOps-Verfahren würde betroffene Builds identifizieren, die Komponente aktualisieren und neue Versionen bereitstellen. DevSecResOps erweitert die Reaktion: Die Dienstlandkarte zeigt sofort betroffene Geschäftsprozesse und Abhängigkeiten. Telemetrie und geschützte Protokolle helfen, tatsächliche Ausnutzung zu bewerten. Progressive Deployments begrenzen die Änderung, während kritische Dienste geplant in einen Degradationsmodus wechseln.
Falls eine Kompromittierung bestätigt wird, erfolgt der Wiederaufbau für die betroffenen kritischen Komponenten in einer getrennten Vertrauensdomäne aus signierten Artefakten und geprüften Daten. Identitäten und Geheimnisse werden risikobasiert erneuert, bevor der Dienst wieder freigegeben wird. Externe Abhängigkeiten, Datenabgleiche und die Reihenfolge des Wiederanlaufs werden ausdrücklich in die Freigabeentscheidung einbezogen. Anschließend entstehen aus dem Vorfall neue Pipeline-Regeln, Erkennungsmuster und Übungen. So wird aus Incident Response ein geschlossener Verbesserungszyklus.
Einführung in vier Etappen
- Transparenz schaffen: Kritische Dienste auswählen, Eigentümer und Abhängigkeiten erfassen, bestehende Security-, Delivery- und Recovery-Kontrollen zusammenführen.
- Pilotieren: Für ein relevantes Produkt ein Service Resilience Profile, einen Golden Recovery Path und gemeinsame Kennzahlen entwickeln. Ein realistisches Ausfallszenario testen.
- Standardisieren: Erfolgreiche Muster als Plattformdienste, Pipeline-Vorlagen und Richtlinien als Code bereitstellen. Evidenzen automatisiert sammeln.
- Skalieren und üben: Weitere Dienste risikobasiert anbinden, Lieferanten einbeziehen, regelmäßige Game Days durchführen und Ausnahmen aktiv zurückbauen.
Typische Fehlansätze
- Nur Werkzeuge integrieren: Eine gemeinsame Oberfläche ersetzt weder klare Entscheidungen noch getestete Abläufe.
- Recovery an ein Backup-Team delegieren: Wiederanlauf ist eine Eigenschaft des Geschäftsdienstes und benötigt Anwendungskontext.
- Alles gleich behandeln: Kontrolltiefe und Testfrequenz müssen sich an Kritikalität und Angriffsexposition orientieren.
- Automatisierung ungeprüft vertrauen: Fehlerhafte Automationen können Störungen beschleunigen; deshalb sind Tests, Freigaben und Abbruchwege nötig.
- Nur Happy Paths testen: Übungen müssen fehlende Identitäten, manipulierte Daten, nicht verfügbare Abhängigkeiten und Zeitdruck einschließen.
Wirtschaftlichkeit: Resilienz als Produktivitätsfaktor
DevSecResOps verursacht anfangs Aufwand für Architekturarbeit, Plattformfunktionen, Datenpflege und Übungen. Der Nutzen kann auch im Regelbetrieb entstehen, wenn standardisierte Wiederherstellung, bessere Diensttransparenz, frühere Fehlererkennung und sichere Deployment-Muster Betriebsunterbrechungen und Abstimmungsaufwand tatsächlich reduzieren. Investitionen sollten deshalb vor und nach der Einführung anhand von Ausfallkosten, Wiederherstellungszeiten, manueller Kontrollarbeit und Änderungsfehlern bewertet werden.
Fazit: Sicherheit endet nicht mit dem Deployment
DevSecResOps verbindet sichere Entwicklung mit belastbarem Betrieb zu einem durchgängigen System. Das Architekturprinzip zwingt Organisationen, Sicherheit, Beobachtbarkeit, Eindämmung und Wiederherstellung gemeinsam zu entwerfen. Dadurch entsteht kein absolut störungsfreier Betrieb. Es entsteht jedoch die Fähigkeit, unter Unsicherheit schneller zu erkennen, gezielter zu entscheiden und vertrauenswürdig wiederherzustellen. Für digitale Unternehmen ist genau diese Fähigkeit ein entscheidendes Qualitätsmerkmal ihrer Produkte und Plattformen.
Albert Absmeier & KI
Management-Checkliste
- Sind die wichtigsten Geschäftsdienste mit Eigentümern und Abhängigkeiten erfasst?
- Sind Sicherheits- und Wiederanlaufziele Teil von Architektur und Produkt-Backlog?
- Gibt es für kritische Dienste einen getesteten, vertrauenswürdigen Recovery-Pfad?
- Kann die Organisation im Vorfall schnell zwischen Isolation, Degradation und Wiederherstellung entscheiden?
- Liefern Pipelines und Betriebsplattformen belastbare Evidenzen statt manueller Nachweissammlungen?
- Werden technische Tests regelmäßig mit geschäftlichen Szenarien verbunden?
FAQ: Die 10 wichtigsten Fragen zu DevSecResOps
1. Was ist DevSecResOps?
DevSecResOps ist ein Architektur- und Betriebsprinzip, das sichere Softwareentwicklung, stabilen Betrieb und belastbare Wiederherstellung zusammenführt. Ziel ist es, digitale Dienste nicht nur schnell und sicher bereitzustellen, sondern sie bei Angriffen, Fehlern oder Ausfällen kontrolliert weiterzubetreiben und vertrauenswürdig wiederherzustellen.
2. Worin unterscheidet sich DevSecResOps von DevSecOps?
DevSecOps verankert Sicherheit in Entwicklung und Auslieferung. DevSecResOps erweitert diese Verantwortung bis in den laufenden Betrieb und die Wiederherstellung. Eine Änderung gilt damit erst dann als beherrscht, wenn sie beobachtbar, begrenzbar, reversibel und im Störungsfall wiederanlauffähig ist.
3. Welche Rolle spielt ResOps?
ResOps koordiniert die betriebliche Widerstandsfähigkeit. Dazu gehören Datenintegrität, Eindämmung, Wiederanlauf, die Validierung von Backups sowie die Abstimmung zwischen Security, IT-Betrieb, Plattformteams und Fachbereichen. ResOps macht Recovery zu einem regelmäßig geprüften Prozess statt zu einer Annahme.
4. Braucht DevSecResOps ein eigenes Team?
Nicht zwingend. Entscheidend ist eine gemeinsame Ergebnisverantwortung über bestehende Teams hinweg. Ein kleines Enablement-Team kann Referenzarchitekturen, Kontrollkataloge, Messgrößen und Übungsszenarien pflegen, während Produkt- und Domänenteams die Vorgaben risikogerecht umsetzen.
5. Welche Systeme sollten Unternehmen zuerst einbeziehen?
Der Einstieg sollte bei wenigen geschäftskritischen End-to-End-Diensten erfolgen. Geeignet sind Dienste mit hohem Ausfallrisiko, sensiblen Daten, vielen Abhängigkeiten oder strengen regulatorischen Anforderungen. Ein klar abgegrenzter Pilot liefert schneller belastbare Erkenntnisse als ein unternehmensweiter Werkzeug-Rollout.
6. Was ist ein Golden Recovery Path?
Der Golden Recovery Path ist ein dokumentierter und getesteter Standardweg für die Wiederherstellung. Er beschreibt unter anderem Isolation, Prüfung des Wiederherstellungspunkts, Erneuerung von Identitäten und Geheimnissen, Wiederaufbau, technische Validierung und fachliche Freigabe.
7. Wie verändert DevSecResOps die CI/CD-Pipeline?
Die Pipeline prüft zusätzlich zur Funktion und Sicherheit auch Wiederherstellbarkeit, Datenintegrität und kontrollierte Fehlerbehandlung. Signierte Artefakte, Provenienz, Richtlinien als Code, Restore-Tests, progressive Deployments und definierte Abbruchkriterien werden Teil einer umfassenderen Resilience Pipeline.
8. Welche Kennzahlen sind besonders relevant?
Wichtige Größen sind die tatsächliche Wiederherstellungszeit, der erreichte Datenstand, die Zeit bis zur belastbaren Lageeinschätzung, die Erfolgsquote von Restore-Tests, die Änderungsfehlerquote und der Anteil kritischer Dienste mit validiertem Recovery-Pfad. Einzelwerte sollten immer gemeinsam und im Geschäftskontext interpretiert werden.
9. Wie lässt sich die Wiederherstellung zuverlässig testen?
Geeignet sind regelmäßige Restore-Tests, Game Days, Chaos-Experimente und Angriffssimulationen. Die Tests sollten nicht nur den technischen Start eines Systems prüfen, sondern Identitäten, Abhängigkeiten, Datenintegrität, Degradationsmodi und die fachliche Nutzbarkeit des wiederhergestellten Dienstes einbeziehen.
10. Was sind die größten Hürden bei der Einführung?
Typische Hürden sind getrennte Zuständigkeiten, unvollständige Dienst- und Abhängigkeitsdaten, ungeprüftes Vertrauen in Automatisierung und Recovery sowie eine zu starke Konzentration auf Werkzeuge. Erfolgreiche Programme beginnen mit klaren Geschäftszielen, einem realistischen Piloten und gemeinsam verantworteten Nachweisen.
Text, Management Summary, FAQ und Bild wurden mit Hilfe von KI erstellt
© DevSecResOps Albert Absmeier
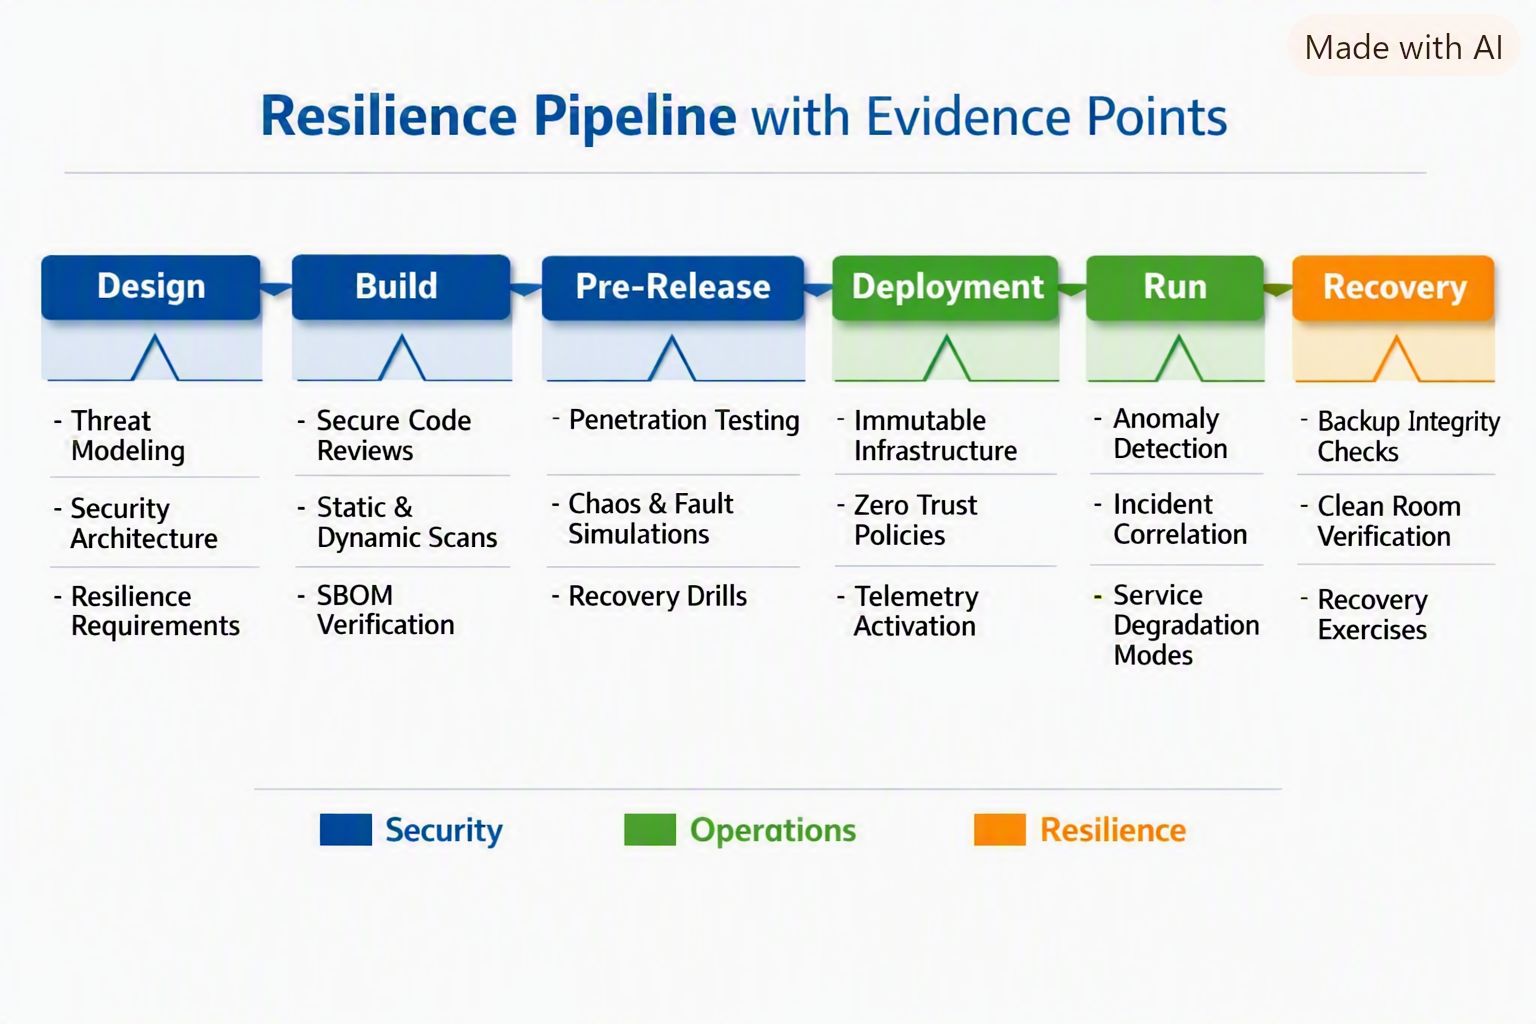
Resilience Pipeline mit regulatorischen Kontrollpunkten
|
Phase |
Kernaktivitäten |
Evidenzpunkte |
Regulatorische |
|
Design |
Architektur, Threat Modeling, Risikoanalyse |
Security Architecture, Resilience Requirements |
NIS2 Art. 21 – Risikomanagement & |
|
Build |
Entwicklung, Code‑Review, SBOM‑Erstellung |
Secure Code Reviews, Static/Dynamic Scans, SBOM Verification |
CRA Art. 10 – Software Bill of Materials |
|
Pre‑Release |
Test, Simulation, Recovery‑Drills |
Penetration Testing, Chaos Simulations, Recovery Drills |
NIS2 Art. 23 – Incident Reporting |
|
Deployment |
Infrastruktur, Policies, Telemetrie |
Immutable Infrastructure, Zero Trust Policies, Telemetry Activation |
NIS2 Art. 21(2) – Technische und |
|
Run |
Betrieb, Monitoring, Incident Response |
Anomaly Detection, Incident Correlation, Degradation Modes |
NIS2 Art. 23 – Meldung von |
|
Recovery |
Wiederherstellung, Nachweisführung |
Backup Integrity Checks, Clean Room Verification, Recovery Exercises |
NIS2 Art. 21(3) – |
720 Artikel zu »DevSecOps«
IT-Security | News | Produktmeldung
DevSecOps: Neue Orchestrierungsfunktionen schließen die Lücke zwischen Entwicklung und Bereitstellung
Die Kombination aus plattformnahem Geheimnis-Management, vollständigen Merge-Request-Workflows, Transparenz über wiederverwendete Komponenten, lokal ausführbaren KI-Modellen und SBOM-basiertem Dependency-Scanning adressiert zentrale Schwachstellen in modernen DevSecOps-Prozessen. Sie ermöglicht Teams, Automatisierung, Sicherheit und Governance in einem einheitlichen Umfeld zu bündeln, wodurch die Lücke zwischen Code-Entwicklung und zuverlässiger Bereitstellung geschlossen wird. Eine aktuelle Plattformversion (siehe Meldung am Ende des…
Business | Effizienz | Favoriten der Redaktion | Kommunikation | Künstliche Intelligenz | New Work | News | Services | Strategien
Die neue Ära von DevSecOps: Solo-Teams, aber Manager von vielen

Die Softwareentwicklung geht in Richtung KI-gestützter Autonomie einzelner Fachkräfte. Doch wie entsteht die Fähigkeit, eigenständig mit KI-Systemen zu arbeiten? Die Antwort liegt in einem scheinbaren Widerspruch: DevSecOps-Kollaboration. Viele Jahre funktionsübergreifender Zusammenarbeit vermitteln jenes breite Wissen über Sicherheit, Infrastruktur und Geschäftslogik, das Ingenieure befähigt, KI-Outputs zu bewerten und Verantwortung zu übernehmen. Einzelne Teammitglieder können heute…
Business | Künstliche Intelligenz | News | Trends 2025
Trends 2025: GenAI & Anwendungsmodernisierung, ROI-Messung von KI und DevSecOps

Experten von GitLab prognostizieren maßgeschneiderte KI-Modelle on-premises, KI-Modelle von Open-Source-Projekten, ein Überdenken des Risikomanagements bei der Nutzung von KI, die wirtschaftliche Modernisierung von Anwendungen im großen Stil, die Verabschiedung isolierter KI-Anwendungen, die Erhöhung der Sicherheit bei DevOps und KI-Agenten als Katalysatoren für die Transformation der Software-Lieferkette. Ashley Kramer Chief Sales & Marketing Officer und…
IT-Security | Künstliche Intelligenz | News | Trends 2024 | Trends Security
DevSecOps-Teams zweifeln an der Sicherheit von KI-generiertem Code

Die Umfrage analysiert das »Tauziehen«, das KI-gestützte Codierungstools im Software-Entwicklungsprozess hervorrufen. Der Bericht »Global State of DevSecOps 2024« von Black Duck Software, Inc. (»Black Duck«) analysiert Trends, Herausforderungen und Chancen, die sich auf die Software-Sicherheit auswirken. Die Daten belegen, dass der umfassende Einsatz von KI die Art und Weise, wie Software entwickelt wird, grundlegend…
Cloud Computing | IT-Security | Künstliche Intelligenz | News
Security First: DevSecOps durch KI und Cloud vorantreiben
Cloud Computing ist wie das Thema künstliche Intelligenz allgegenwärtig. Auch im Kontext der DevSecOps-Methodik spielen beide Technologien eine gewichtige Rolle. Wie können sie Teams unterstützen und worauf müssen Entwickler und Administratoren achten. DevSecOps-Teams sind mit den richtigen Methoden und dem richtigen Mindset in der Lage, einen »Security-First-Ansatz« zu verfolgen, bei dem die Frage nach…
Ausgabe 1-2-2024 | Cloud Computing | IT-Security | News | Security Spezial 1-2-2024
Cyber Security – Die Herausforderungen in 2024: DevSecOps erfordert eine Veränderung der Unternehmenskultur

Cloud Security umfasst die Sicherheitsmaßnahmen, die ergriffen werden müssen, um Cloud Computing zu schützen. DevSecOps ist ein wesentlicher Bestandteil der Cloud Security, der gewährleisten soll, dass Anwendungen und Systeme von Anfang an sicher sind.
Effizienz | Favoriten der Redaktion | Lösungen | News | Strategien
Vier Best Practices sichern den DevSecOps-Erfolg

Das DevOps-Prinzip hat sich für IT-Projekte als enorm wertvoll erwiesen: Entwickler und Administratoren brechen Wissenssilos auf und schaffen es mit den entsprechenden Methoden, die Zusammenarbeit zu verbessern. Wie DevOps-Teams nun auch den Sicherheitsaspekt integrieren und DevSecOps erfolgreich in die Praxis umsetzen, zeigt der IT-Dienstleister Consol anhand von vier goldenen Regeln. Das Kunstwort DevOps setzt…
Business Process Management | Favoriten der Redaktion | IT-Security | News
Der Weg zu DevSecOps: Weiterhin steinig, aber es gibt Fortschritte

Illustration Absmeier Genki Bing DevSecOps ist eine derjenigen Abkürzungen, die man in der hektischen Welt der Softwareentwicklung durchaus unterschiedlich interpretieren kann. So kann man beispielsweise eine Definition wählen, nach der man das Thema Sicherheit als willkommene Ergänzung der Bereiche Entwicklung (Dev) und Betrieb (Ops) betrachtet. Oder Sicherheit gilt eher als der unerwünschte Eindringling, der…
Künstliche Intelligenz | News | Trends 2023
DevSecOps-Bericht zu KI: Cybersicherheits- und Datenschutz-Bedenken erschweren die KI-Einführung

Studie: Unternehmen sind in Bezug auf KI optimistisch, aber bei deren Einführung muss auf Datenschutz und Sicherheit, Produktivität und Weiterbildung geachtet werden. 83 % der Befragten halten die Implementierung von KI in ihre Softwareentwicklungsprozesse für unerlässlich, um nicht ins Hintertreffen zu geraten. 79 % der Befragten haben jedoch Bedenken, dass KI-Tools Zugang zu privaten Informationen…
IT-Security | News
Offenlegung von Zugangsdaten in der DevSecOps-Pipeline: Wo Angreifer (zu) oft sensible Daten finden

Entwickler nutzen fest kodierte Zugangsdaten, um nahtlos auf die Dienste zuzugreifen, die für die Erstellung und Bereitstellung von Anwendungen erforderlich sind, oder sich zu authentifizieren. Diese Praxis rationalisiert zwar die Entwicklung, birgt aber auch Risiken. Wenn Zugangsdaten – wie Kennwörter, API-Schlüssel und Zugriffstoken – im Quellcode öffentlich zugänglich sind, können Angreifer sie nutzen, um…
Ausgabe 3-4-2023 | IT-Security | News | Security Spezial 3-4-2023 | Strategien
DevSecOps – Die Kluft zwischen Entwicklung und Sicherheit überwinden

Kontinuierlich, einmal täglich oder alle paar Tage: So häufig geben 70 Prozent der für die DevSecOps-Studie 2022 von GitLab befragten Entwickler-Teams Software-Code frei. Ein Anstieg von 11 Prozent gegenüber dem Vorjahr. Die Umfrage ergab auch, dass die Befragten am meisten in Sicherheit investieren. Das sind die guten Nachrichten.
IT-Security | News | Trends 2023 | Trends Security
Konvergenz von Observability, DevSecOps und Sicherheit wird immer wichtiger

80 Prozent der CIOs in Deutschland beabsichtigen DevSecOps-Kultur auf mehr Teams auszuweiten: Schlüssel zur schnelleren und sichereren Softwareentwicklung sowie digitaler Transformation. Es wird immer schwieriger, die Zuverlässigkeit und Sicherheit von Software aufrechtzuerhalten. Das ergab eine weltweite Umfrage von Dynatrace unter 1.300 CIOs und leitenden DevOps-Managern [1]. Demnach erhöht die Forderung nach kontinuierlichen Release-Zyklen und…
IT-Security | News | Trends 2022 | Trends Security
Bei DevOps und DevSecOps holpert es in Deutschland noch

Viele Unternehmen in Deutschland hinken ihren Zielen bei der Implementierung von DevOps und DevSecOps hinterher. Eine Hauptursache dafür sind kulturelle Barrieren. Das zeigt eine aktuelle Umfrage von Progress. Die Umfrage »2022 DevSecOps: Simplifying Complexity in a Changing World« untersucht den Status quo der DevOps- und DevSecOps-Adaption. Im Auftrag von Progress befragte das Technologieforschungsunternehmen Insight…
IT-Security | News | Strategien
Was ist DevSecOps?

Wenn man DevSecOps erklären will, beginnt man am besten mit der Definition von DevOps. DevOps kombiniert Praktiken aus der Softwareentwicklung und dem IT-Betrieb. Um es an einem einfachen Beispiel zu illustrieren: Developer brauchen Umgebungen, in denen sie Software entwickeln können. Dazu zählen solche, in denen sie Code programmieren und zu den Repositories hinzufügen, CI/CD-Plattformen, die…
Ausgabe 7-8-2022 | IT-Security | News | Security Spezial 7-8-2022
Sicherheit in der Software Supply Chain – DevOps braucht DevSecOps

Im Gespräch erklärt Frank Fischer, Product Marketing bei Snyk, warum Open Source in Software-Projekten gleichzeitig Fluch und Segen sein kann, warum Sicherheit integraler Bestandteil jedes Prozessschrittes in DevOps werden muss und das Security im Wesentlichen aus den drei Aspekten Technologie, Prozesse und Menschen besteht und die alle gleich bedacht und gestärkt werden müssen.
Effizienz | News | Strategien
DevSecOps: Fünf Aspekte für den optimalen ROI
Entwicklungsteams von Morgen denken nicht nur an Code, Sicherheit und den alltäglichen Arbeitsbetrieb, sondern auch an die Rentabilität – den ROI. In einer zunehmend digitalisierten Welt ist es unerlässlich, dass die Verantwortlichen für den ständigen Wandel bei der Modernisierung ihrer IT-Strukturen Geschäftsziele mitdenken. Spätestens die Covid-19 Pandemie hat Unternehmen vor Augen geführt, wie entscheidend…
Favoriten der Redaktion | IT-Security | News | Strategien
DevSecOps: Schneller sichere Software

Immer wieder sorgen Datenverluste und Datenschutzverletzungen aufgrund fehlerhafter Software für Schlagzeilen. Auf der einen Seite werden Cyberkriminelle immer findiger, wenn es darum geht, Sicherheitslücken auszunutzen. Andererseits verschärfen Regierungen und Regulierungsbehörden zurecht die Bestimmungen zum Datenschutz. Das hat in vielen Unternehmen zu der Situation geführt, dass die IT-Sicherheitsspezialisten der beschleunigten Entwicklung von Software durch den Einsatz…
IT-Security | News | Strategien | Tipps
Security-Praxistipps: Sechs DevSecOps-Metriken für DevOps- und Sicherheitsteams
Mitarbeiter im DevOps-Team bekommen leicht das Gefühl, dass das Sicherheitsteam dazu da ist, ihnen die Arbeit schwerer zu machen. Sicherheitsfachkräfte haben vielleicht das Gefühl, dass DevOps ihre Prioritäten nicht teilt und die Sicherheit nie so ernst nehmen wird, wie sie es gerne hätten. Glücklicherweise muss das nicht so sein. Durch das Festlegen und Verfolgen gemeinsamer…
2347 Artikel zu „Resilienz“
IT-Security | News | Tipps
Vier Best Practices für präventive Cyberresilienz

Klassisches Patchmanagement allein hält mit der Geschwindigkeit moderner Angriffe nicht mehr Schritt. Unternehmen brauchen deshalb eine präventive Cyberresilienz, die den möglichen Ausbreitungsradius schon vor einem Vorfall begrenzt. Identitätsbasierte Mikrosegmentierung, gezielte Kompensationskontrollen und automatisierte Eindämmung schützen kritische Ressourcen, sichern die Geschäftskontinuität und verschaffen IT-Teams die nötige Zeit für getestete, risikoarme Patches. Management Summary Risiko realistisch bewerten:…
Ausgabe 7-8-2026 | Business | Business Process Management | News | Strategien
Transparenz, Governance und Resilienz in der Informationsarchitektur – Data Repatriation

Geopolitische Risiken, strengere Regulierung und wachsende Abhängigkeiten von globalen Cloud-Anbietern zwingen Unternehmen, ihre Datenstrategie neu zu bewerten. Data Repatriation bringt geschäftskritische Informationen gezielt in kontrollierbare Infrastrukturen zurück und verbindet so technologische Flexibilität mit rechtlicher Sicherheit. Damit wird digitale Souveränität zur strategischen Managementaufgabe.
Business | Digitalisierung | Favoriten der Redaktion | News | Strategien | Tipps | Trends 2027 | Trends Geschäftsprozesse | Trends Wirtschaft
Wettbewerbsfähigkeit, Resilienz und Zukunftsfähigkeit 2027: 10 strategische Leittrends
Management Summary Die zehn strategischen Leittrends zeigen, dass digitale Transformation nicht mehr primär aus einzelnen Technologien besteht, sondern aus neuen Führungs-, Betriebs- und Wertschöpfungsmodellen. Für das Management ergibt sich daraus die Aufgabe, KI, Daten, Sicherheit, Automatisierung und Nachhaltigkeit nicht isoliert zu betrachten, sondern als miteinander verbundene Architektur für Wettbewerbsfähigkeit, Resilienz und Zukunftsfähigkeit zu steuern.…
Business Process Management | Infrastruktur | IT-Security | Kommentar | Künstliche Intelligenz | News
Cyberresilienz im Zeitalter von KI: Wie sicher ist das IoT wirklich?
Die Bedrohungslage im Bereich der Cybersicherheit verändert sich rasant. Das Bundesamt für Sicherheit in der Informationstechnik (BSI) warnt aktuell, dass künstliche Intelligenz die Geschwindigkeit, Skalierung und Automatisierung von Cyberangriffen erheblich erhöht und Unternehmen ihre Sicherheitsstrategien entsprechend anpassen müssen [1]. Vor diesem Hintergrund gewinnt der Cyber Resilience Act (CRA) der Europäischen Union zusätzlich an Bedeutung und…
Digitalisierung | Industrie 4.0 | News
Digitale Befähigung als Schlüssel zur Resilienz
Knapp jedes dritte Industrieunternehmen in Deutschland sieht laut ifo-Studie seine Wettbewerbsfähigkeit schwinden. Parallel stieg die Zahl der Unternehmensinsolvenzen 2025 auf 24.064 und damit auf den höchsten Stand seit zehn Jahren. Besonders hart traf es die Branchen Logistik und Automotive. Aktuell drehen sich Diskussionen über Gegenmaßnahmen häufig um Energiepreise, Bürokratie oder Geopolitik. In der Industrie…
Favoriten der Redaktion | Infrastruktur | IT-Security | News | Whitepaper
Resilienz stärken: Verbindliche Standards für sicherheitskritische Systeme
Verbindliche Mindeststandards für kritische Infrastrukturen erhöhen die Widerstandsfähigkeit von Staat, Wirtschaft und Gesellschaft. Unabhängige Prüfungen als Frühwarnsystem in der Resilienz-Architektur nutzen. Physische und digitale Sicherheit integrieren. TÜV-Verband legt Positionspapier vor. Die Resilienz von Staat, Wirtschaft und Gesellschaft ist angesichts geopolitischer Spannungen, hybrider Bedrohungen, regelmäßiger Cyberangriffe und fragiler Lieferketten zu einer drängenden sicherheitspolitischen Aufgabe geworden.…
Business | Business Process Management | Cloud Computing | Digitalisierung | Favoriten der Redaktion | Geschäftsprozesse | IT-Security | News | Strategien
DORA und die Grenzen formaler Compliance: Digitale Resilienz ist eine Architekturfrage

Management Summary Formale Compliance schafft keine Sicherheit: DORA definiert einen verbindlichen Rahmen, doch echte digitale Resilienz entsteht erst, wenn Governance, Technologie und Betrieb architektonisch verzahnt sind – Checklisten allein reichen nicht. Komplexe, historisch gewachsene IT‑Landschaften erhöhen das Risiko: Fragmentierte Zertifikate, dezentrale Schlüsselverwaltung und inkonsistente Identity‑Konzepte erschweren operative Steuerbarkeit und machen Institute anfällig für Angriffe. Identitäten…
Ausgabe 5-6-2026 | IT-Security | News | Security Spezial 5-6-2026
Regulatorien wie NIS2 als Taktgeber für Cyberresilienz – Die eigentliche Botschaft des Gesetzes

Wie NIS2 und eine konsequente Informationssicherheits-Governance- und Compliance-by-Design-Strategie den Unterschied zwischen reaktivem Flickwerk und nachhaltiger Cyberresilienz ausmachen.
Business Process Management | IT-Security | Künstliche Intelligenz | News | Strategien | Tipps
Generalschlüssel für Software-Schwachstellen erfordern neue Resilienzmöglichkeiten
KI beschleunigt Zero-Day-Exploitation: Generative Modelle machen das Finden und Ausnutzen unbekannter Schwachstellen schneller, automatisierter und skalierbar – dadurch steigt die Angriffsfrequenz und mehr Angriffe »rutschen durch«. Risikobewertung verliert an Halt: Wenn Eintrittswahrscheinlichkeiten schneller kippen als Bewertungszyklen, reichen klassische Schutz- und Bewertungslogiken nicht mehr aus. Angreifer gewinnen Zeit und Tiefe im Netz: Über unbekannte Lücken verschaffen…
IT-Security | News | Services | Whitepaper
Cyberresilienz: Ausfallzeiten nach Sicherheitsverstoß minimieren
Ausfallzeiten sind der entscheidende Schadenstreiber – nicht nur der Angriff selbst, sondern die Dauer der Wiederherstellung bestimmt die Gesamtkosten. Prävention genügt nicht mehr – Unternehmen müssen gleichermaßen in Erkennung, Reaktion und Wiederherstellung investieren. NIST CSF 2.0 bietet ein klares Resilienz‑Framework – Govern, Identify, Protect, Detect, Respond, Recover strukturieren Risiken und Prioritäten. Detect, Respond und Recover…
Business | Favoriten der Redaktion | IT-Security | Kommentar | News | Services
Neue Resilienzmaßstäbe setzen: Warum Backup allein nicht mehr ausreicht
Die Mean Time to Clean Recovery ersetzt RPOs und RTOs als Kennzahl für Cyberresilienz. Statement von Marc Molyneux, Field CTO, Commvault 24 oder 5 – diese Zahlen drücken das Dilemma traditioneller Backup- und Disaster-Recovery-Ansätze aus: Die Geschäftsführung geht davon aus, dass Systeme und Daten spätestens nach fünf Tagen wieder online sind. Im Schnitt dauert…
Business Process Management | Favoriten der Redaktion | Geschäftsprozesse | Kommunikation | New Work | News | Services | Strategien | Tipps
Resilienz in der Polykrise: Wie Unternehmen zukunftsfähig bleiben

Unternehmen stehen in einer von Polykrisen geprägten Wirtschaft unter permanentem Veränderungsdruck, fühlen sich laut aktueller Studien jedoch mehrheitlich nicht ausreichend darauf vorbereitet und agieren überwiegend reaktiv. Entscheidend für organisatorische Resilienz sind drei miteinander verknüpfte Treiber: Technologie, eine zukunftsfähig qualifizierte Belegschaft und ein organisatorischer Rahmen, der vorausschauende Planung und schnelle Umsetzung ermöglicht. Unternehmen, die diese Faktoren…
Business | Business Process Management | Favoriten der Redaktion | Infrastruktur | IT-Security | News | Strategien | Tipps
Resilienz: Die unterschätzte Ressource im Datenschutzmanagement

Angesichts zunehmender geopolitischer Unsicherheiten, KI‑gestützter Cyberangriffe und wachsender regulatorischer Anforderungen wird Cyberresilienz zu einer zentralen Voraussetzung wirksamen Datenschutzmanagements. Der Beitrag zeigt, warum rein reaktive Sicherheitsmaßnahmen nicht ausreichen und wie ein mehrschichtiger, systematischer Resilienzansatz den Schutz, die Verfügbarkeit und die Wiederherstellbarkeit von Daten nachhaltig stärkt. Cyberresilienz wird dabei als integraler Bestandteil moderner IT‑ und Datenschutzarchitekturen verstanden,…
Ausgabe 1-2-2026 | Favoriten der Redaktion | News | Tipps | Trends 2026
Mit KI, Nachhaltigkeit und Resilienz zum Unternehmenserfolg 2026 – Zukunft jetzt gestalten

2026 steht im Zeichen des digitalen Umbruchs: Künstliche Intelligenz, nachhaltige Technologien und resiliente Strukturen werden zur Grundlage für den Unternehmenserfolg. Unternehmen müssen sich neuen regulatorischen Anforderungen, Cyberrisiken und dem Fachkräftemangel stellen, um wettbewerbsfähig zu bleiben. Wer jetzt in Innovation, Talente und verantwortungsvolle Datenstrategien investiert, gestaltet die Zukunft aktiv mit.
Favoriten der Redaktion | IT-Security | News | Services | Strategien | Tipps
Mikrosegmentierung: Neue Strategie für Prävention, Resilienz und Sicherheit
Mittels automatisierter Mikrosegmentierung können Unternehmen die möglichen Folgen eines Cyberangriffs effizient und effektiv eindämmen. Zero Networks analysierte über einen Zeitraum von zwölf Monaten (Dezember 2024 bis Dezember 2025) etwa 3,4 Billionen Aktivitäten in 400 Unternehmensumgebungen. Ziel war es, zu verstehen, wie sich erfolgreiche Cyberangriffe nach dem ersten Zugriff weiterentwickeln. Das Ergebnis: Die gefährlichsten Aktivitäten…
Ausgabe 1-2-2026 | Industrie 4.0 | IT-Security | News | Security Spezial 1-2-2026
PKI und OT: Vom digitalen Zertifikat zur Cyberresilienz – Schwierige Gratwanderung
Klassische IT-Sicherheitsansätze lassen sich nicht einfach auf OT übertragen – stattdessen sind hybride, pragmatische Lösungen sowie ein angepasstes Security Posture Management erforderlich. Es gilt den Fokus auf Transparenz und Kontinuität zu legen, anstatt eine perfekte PKI zu fordern, um die Resilienz und Sicherheit kritischer Infrastrukturen zu stärken.
Ausgabe 1-2-2026 | IT-Security | News | Security Spezial 1-2-2026
Warum DDoS-Abwehr heute geschäftskritisch ist – Digitale Resilienz stärken
Gezielte DDoS-Angriffe auf Unternehmen und öffentliche Verwaltungen nehmen rasant zu und bedrohen nicht nur die technische Infrastruktur, sondern auch Geschäftserfolg und Reputation – Standardlösungen stoßen dabei zunehmend an ihre Grenzen. Nur dedizierte, intelligente und skalierbare Abwehrsysteme sichern digitale Resilienz und schützen nachhaltig vor finanziellen Schäden und Vertrauensverlust.
Business | Business Process Management | Favoriten der Redaktion | Infrastruktur | IT-Security | News | Rechenzentrum | Strategien | Tipps
Cyberresilienz beginnt mit Backup: Ein Rahmenwerk für messbare Wiederherstellung
Cyberresilienz entscheidet sich nicht beim Backup, sondern bei der Wiederherstellung. Angesichts von Ransomware, kompromittierten Identitäten und komplexen Cloud‑Abhängigkeiten müssen Unternehmen ihre Backup‑Strategie konsequent auf messbare Recovery‑Ergebnisse ausrichten. Dieser Beitrag zeigt, wie eine architekturgetriebene Enterprise‑Backup‑Strategie Wiederherstellbarkeit, Sicherheit und Resilienz systematisch in den Mittelpunkt stellt. Die Enterprise-Backup-Strategie hat sich weit über ihre traditionelle Rolle als operative…
IT-Security | News | Strategien
Vier Säulen der Cyberresilienz
Trotz langjähriger Investitionen in Abwehrmaßnahmen nehmen Cyberangriffe und kostspielige Ausfallzeiten weiter zu. Traditionelle Sicherheitsmethoden zur Bedrohungsprävention und -erkennung bleiben zwar nach wie vor relevant, doch unter CISOs zeigt sich eine Veränderung in der Herangehensweise. Viele erweitern ihr Aufgabengebiet, um zusätzlich die Leitung von Wiederherstellungsmaßnahmen nach Sicherheitsvorfällen zu übernehmen, damit ihr Unternehmen rasch wieder betriebsbereit ist.…
IT-Security | Künstliche Intelligenz | News | Strategien | Tipps
Wenn KI Cyberangriffe beschleunigt: Diese Maßnahmen sollten Unternehmen jetzt für mehr digitale Resilienz ergreifen
Mit der rasanten Entwicklung künstlicher Intelligenz (KI) erreicht auch die Cyberkriminalität eine neue Dimension. Was früher erheblichen technischen Aufwand und personelle Ressourcen erforderte, lässt sich heute mithilfe intelligenter Algorithmen automatisieren, skalieren und gezielt optimieren. Angriffe werden personalisierter, dynamischer und deutlich schwerer zu erkennen. Unternehmen sehen sich damit einer neuen Qualität digitaler Bedrohungen gegenüber, die klassische…