KI schreibt Code, erzeugt Tests und bewertet sogar die eigenen Ergebnisse – doch die unabhängige Kontrolle hält nicht Schritt. Die Studie »State of AI in Quality Engineering 2026« von TestMu AI zeigt: 81 Prozent der Softwareteams haben bereits KI-Ergebnisse übernommen, die sie nicht vollständig verstanden haben. Nur 41 Prozent prüfen KI-Code automatisiert vor dem Merge. Für CIOs und Entwicklungsleiter stellt sich damit weniger die Frage, ob KI eingesetzt wird, sondern wer ihre Arbeit verlässlich verifiziert. [1]
Management Summary
- KI ist Standard, Kontrolle nicht: 97 % der Teams nutzen KI im Testbereich oder planen dies; bei 40 % schreibt sie mehr als die Hälfte des Produktivcodes. [1]
- Verständnislücke ist Normalfall: 81 % der Teams haben KI-Code oder KI-Tests integriert, die sie nicht vollständig verstanden haben – bei Entwicklern sind es 93 %. [3]
- Prüfung kommt zu spät: Nur 41 % kontrollieren KI-Code vor dem Merge automatisiert; 44 % melden mehr Fehler in der Produktion. Mit separaten CI-Tests steigen »escaped defects« seltener (38 % statt 49 %). [3]
- Budget folgt der Erzeugung: 50 % investieren primär in die Generierung von KI-Output, nur 17 % in dessen Verifikation. Zudem haben lediglich 13 % einen Incident-Response-Plan für KI-Fehler. [1]
- Handlungsbedarf: Pre-Merge-Checks, unabhängige Evaluation von KI-Agenten und Outcome-basierte ROI-Messung sollten jetzt Teil der KI-Strategie werden. [2]
Illustration Absmeier ki
81 % der Softwareteams haben KI-generierten Code integriert, den sie nicht vollständig verstanden
Inzwischen schreibt KI bei 40 % der Teams mehr als die Hälfte des Produktionscodes, 44 % verzeichnen mehr Fehler in der Produktion, und nur 41 % führen vor dem Zusammenführen automatisierte Prüfungen des KI-generierten Codes durch.
TestMu AI (ehemals LambdaTest), die Agentic AI Quality Engineering Plattform, hat den State of AI in Quality Engineering 2026 Bericht veröffentlicht. Die Studie kommt zu dem Ergebnis, dass 81 % der Softwareteams KI-generierten Code oder Tests integriert haben, die sie nicht vollständig verstanden haben, und dass 44 % über mehr unentdeckte Fehler oder Produktionsvorfälle berichten, seit der Anteil des von KI geschriebenen Codes zugenommen hat. Mittlerweile schreibt die KI einen Großteil des Codes und viele der Tests, dennoch überprüfen die meisten Teams die Arbeit im Nachhinein immer noch mit einer Person oder mit einem anderen KI-Modell.
97 % der befragten Teams nutzen bereits KI im Testbereich oder planen dies. Bei den meisten von ihnen ist die offene Frage, wie KI-generierter Code und Tests vor der Auslieferung verifiziert werden.
Wichtigste Erkenntnisse aus dem Bericht »Stand der KI im Qualitätsmanagement 2026«:
- Die Verifizierungslücke:Nur 41 % der Teams führen vor dem Zusammenführen eine automatisierte Überprüfung des von der KI geschriebenen Codes durch; die meisten verlassen sich auf eine manuelle Überprüfung (55 %) oder eine Übergabe an die Qualitätssicherung nach dem Schreiben des Codes (51 %). Bei Teams ohne separate CI-Tests steigt die Anzahl unentdeckter Fehler deutlich stärker an (49 %) als bei Teams, die solche Tests durchführen (38 %).
- Entwickler sind am stärksten gefährdet: 93 % der Entwickler haben KI-Ausgaben zusammengeführt, die sie nicht vollständig verstanden haben.
- KI-gestützte Benotung vergrößert die Kluft:Teams, die ein Modell zur Bewertung eines anderen verwenden (LLM als Richter), führen regelmäßig doppelt so häufig KI-Ausgaben zusammen, die sie nicht verstehen, wie andere Teams (29 % gegenüber 15 %). KI-generierte Tests liegen im Median in 65 % der Fälle »fast richtig, aber nicht ganz«.
- KI-Agenten werden nach menschlicher Überprüfung und Demos ausgeliefert: 77 % der Teams entwickeln KI-Agenten, die sie testen müssen, aber 37 % von ihnen haben keine systematische Möglichkeit, diese Agenten zu evaluieren, und nur 28 % testen die Agenten gegen Benutzer, die versuchen, sie zu knacken.
- Budgets finanzieren die Mittelbeschaffung, nicht die Überprüfung: 50 % der Teams verwenden den größten Teil ihres Budgets für KI-Tests für die Erzeugung von KI-Ergebnissen, während 17 % für deren Überprüfung aufgewendet werden.
- Nur wenige sind auf KI-Fehler vorbereitet:Nur 13 % der Teams verfügen über einen Notfallplan für KI-Fehler.
»Softwareteams verlassen sich heute auf KI, um ihren Code zu schreiben, ihre Tests zu generieren und zunehmend auch, um festzustellen, ob beides bereit für die Auslieferung ist.« Die Verifizierung hat mit dieser Entwicklung jedoch nicht Schritt gehalten. Wir sind der Ansicht, dass jede Ausgabe, die KI erzeugt, von einem System validiert werden sollte, das unabhängig von dem Modell ist, das sie erzeugt hat – und zwar bevor sie zusammengeführt wird und jedes Mal, wenn sie sich ändert. »Die Teams in unserer Umfrage, die diese Vorgehensweise bereits anwenden, verzeichnen weniger Fehler in der Produktion, und wir gehen davon aus, dass sie zum Standard für Entwicklungsunternehmen wird, die KI einsetzen«, sagte Asad Khan, Mitbegründer und CEO von TestMu AI.
Lesen Sie den Bericht hier: https://www.testmuai.com/research/state-of-ai-in-quality-engineering/
Informationen zu TestMu AI
TestMu AI (ehemals LambdaTest) ist eine agentenbasierte Plattform für Qualitätssicherung im Bereich KI, die KI-Implementierungen im gesamten Unternehmen und in der realen Welt gewährleistet. Es führt agentenbasierte Tests für Web- und Mobilanwendungen auf über 5.000 Browsern und über 50.000 realen Geräten durch, sowie für Chat-, Sprach-, IVR-, Video- und Bildagenten. Weitere Informationen finden Sie unter www.testmuai.com.
Die Studie im Überblick
Die folgende Zusammenfassung basiert ausschließlich auf der aktuellen Studie »State of AI in Quality Engineering 2026« von TestMu AI, veröffentlicht am 12. November 2026. Die Erhebung lief von Ende Juli bis Anfang Oktober 2026 unter Testern, Entwicklern und QA-Verantwortlichen aus der weltweiten TestMu-AI-Community. Die Ergebnisse sind daher nicht ohne Weiteres auf die gesamte Softwarebranche übertragbar.
KI verändert Softwareentwicklung schneller als die Qualitätssicherung
Der State of AI in Quality Engineering 2026 zeigt einen deutlichen Umbruch in Softwareentwicklung und Qualitätssicherung. KI ist längst nicht mehr nur ein unterstützendes Werkzeug. In vielen Teams erzeugt sie erhebliche Teile des Produktivcodes, erstellt Tests und übernimmt zunehmend Aufgaben innerhalb der Testprozesse. Gleichzeitig entsteht jedoch eine wachsende Lücke zwischen der Menge KI-generierter Arbeit und deren unabhängiger Überprüfung. Genau diese »Verification Gap« ist die zentrale Botschaft des Reports.
Besonders deutlich wird die Entwicklung beim Programmieren: 40 Prozent der befragten Teams geben an, dass KI mehr als die Hälfte ihres Produktivcodes schreibt. Nur 3 Prozent sagen, dass überhaupt kein Produktivcode KI-generiert ist. Coding-Agenten sind dabei bereits fest etabliert. Als hauptsächlich eingesetzte Systeme nennt die Studie unter anderem Claude Code mit 36 Prozent und GitHub Copilot mit 26 Prozent.
81 Prozent übernehmen KI-Code, den sie nicht vollständig verstehen
Die vielleicht auffälligste Zahl der Untersuchung betrifft das Verständnis der erzeugten Ergebnisse: 81 Prozent der Teams haben bereits KI-generierten Code oder KI-generierte Tests zusammengeführt, obwohl sie diese nicht vollständig verstanden haben. Bei 19 Prozent geschieht dies regelmäßig, weitere 33 Prozent tun es gelegentlich. Unter den befragten Entwicklern liegt der Anteil, der dies zumindest schon einmal getan hat, sogar bei 93 Prozent.
Eine menschliche Freigabe allein löst dieses Problem offenbar nicht. Selbst unter den Teams, bei denen eine Person jeden KI-generierten Test freigibt, haben laut Studie 81 Prozent bereits KI-Ausgaben integriert, die sie nicht vollständig verstanden haben. Die Ergebnisse stellen deshalb die verbreitete Annahme infrage, dass Human-in-the-Loop-Verfahren automatisch eine ausreichende Qualitätskontrolle darstellen.
Das Problem zeigt sich auch im Betrieb: 44 Prozent der Teams berichten von mehr Fehlern oder Produktionsvorfällen, seit der Umfang KI-generierten Codes gestiegen ist. Allerdings stellt die Studie ausdrücklich keinen einfachen kausalen Zusammenhang zwischen dem Anteil des KI-Codes und der Fehlerquote her. Teams, bei denen KI mehr als die Hälfte des Codes erzeugt, melden sogar seltener steigende Fehlerzahlen als Teams mit geringerem KI-Anteil. Entscheidend scheint nach den erhobenen Daten vielmehr zu sein, wie der Code überprüft wird.
Automatisierte Kontrolle vor dem Merge bleibt die Ausnahme
Obwohl KI immer früher im Entwicklungsprozess eingesetzt wird, findet die Qualitätssicherung vielfach weiterhin nachgelagert statt. Nur 41 Prozent der Teams führen vor dem Merge überhaupt eine automatisierte Prüfung KI-generierten Codes durch. 55 Prozent setzen auf menschliche Reviews und manuelle Tests, 51 Prozent übergeben den Code anschließend an das QA-Team. Separate automatisierte Tests in der CI-Pipeline führen 34 Prozent durch.
Die Studie liefert dabei einen wichtigen Zusammenhang: Bei Teams, die sich primär auf die Übergabe an QA verlassen und keine separaten automatisierten CI-Tests einsetzen, berichten 49 Prozent von steigenden »escaped defects«, also Fehlern, die erst in Produktion erkannt werden. Bei Teams mit separaten automatisierten CI-Tests sind es 38 Prozent. Die Autoren weisen damit auf den Stellenwert einer frühen, automatisierten Verifikation hin.
KI-generierte Tests bleiben häufig »fast richtig«
Auch die Qualität KI-generierter Testartefakte bleibt eine Herausforderung. Der Median des Vertrauens in KI-generierte Tests, Assertions und Testdaten liegt lediglich bei 54 von 100 Punkten. Gleichzeitig geben die Teams im Median an, dass KI-generierte Tests in 65 Prozent der Fälle »fast richtig, aber nicht ganz richtig« seien.
Damit entsteht ein neues Produktivitätsproblem: Zwar kann KI Tests schnell erzeugen, gleichzeitig entsteht zusätzlicher Aufwand für deren Kontrolle und Korrektur. Tatsächlich nennen 18 Prozent die Überprüfung von KI-Ausgaben als größten Zeitfresser im QA-Bereich. Damit liegt diese neue Aufgabe bereits nahezu gleichauf mit klassischen Problemen wie Testwartung und instabilen beziehungsweise »flaky« Tests, die jeweils von 19 Prozent genannt werden.
Wenn KI die KI bewertet, bleibt ein Kontrollrisiko
Besondere Aufmerksamkeit widmet der Report dem Prinzip »LLM-as-a-Judge«, bei dem ein Sprachmodell die Ergebnisse eines anderen KI-Systems bewertet. 32 Prozent der Teams, die KI-Ausgaben evaluieren, verwenden dieses Verfahren. Die Untersuchung zeigt dabei einen auffälligen Zusammenhang: 29 Prozent der LLM-as-a-Judge-Nutzer übernehmen regelmäßig KI-Ergebnisse, die sie nicht vollständig verstehen. Bei den übrigen Teams sind es 15 Prozent.
TestMu AI betont ausdrücklich, dass dies keinen kausalen Beweis darstellt. Teams, die LLM-as-a-Judge einsetzen, könnten beispielsweise generell offensiver bei der KI-Einführung vorgehen. Trotzdem zeigt der Befund ein grundsätzliches Problem: Wenn KI Inhalte erzeugt und wiederum KI die Qualität dieser Inhalte bewertet, fehlt möglicherweise eine unabhängige Prüfinstanz.
KI-Agenten erreichen die Produktion schneller als ihre Testverfahren
Besonders groß ist diese Lücke bei KI-Agenten. 77 Prozent der befragten Teams entwickeln Agenten, die getestet werden müssen, und 72 Prozent verfügen bereits über KI-Funktionen im Produktivbetrieb. Dennoch haben 37 Prozent der Agenten-Entwickler keine systematische Evaluierung mittels Regressionsevaluationen, Konsistenzprüfungen, Similarity Scoring oder einer Evaluierungsplattform.
Menschliche Kontrolle dominiert auch hier: 63 Prozent evaluieren ihre Agenten mittels Human Review. Nur 28 Prozent testen gegen Nutzer, die gezielt versuchen, den Agenten auszutricksen oder zum Scheitern zu bringen. 27 Prozent wiederholen Evaluationen nach einer Änderung des zugrunde liegenden Modells oder Prompts. Lediglich 15 Prozent machen solche Evaluierungen zu einem Quality Gate innerhalb der CI-Pipeline.
Auch realistische Einsatzbedingungen werden nicht konsequent berücksichtigt. Von den Teams, die Sprach- oder Telefonagenten entwickeln, testen 45 Prozent nicht unter Hintergrundgeräuschen oder schlechter Verbindungsqualität. 39 Prozent testen keine Akzente, Dialekte oder andere Sprachen.
Unternehmen investieren stärker in Erzeugung als in Verifikation
Ein strukturelles Problem zeigt sich bei der Budgetverteilung. 50 Prozent der Teams investieren den größten Teil ihres KI-Testbudgets in die Erzeugung von KI-Output, beispielsweise in Coding-Agent-Lizenzen und Modell-APIs. Nur 17 Prozent setzen den Schwerpunkt auf die Überprüfung des Outputs, etwa durch kommerzielle Testplattformen, Eval- und Observability-Werkzeuge oder Cloud-Testinfrastruktur
Gleichzeitig bewerten viele Unternehmen die wirtschaftliche Wirkung positiv: 73 Prozent berichten von einem positiven ROI ihrer KI-Nutzung im Softwaretesting. Gemessen wird dieser Erfolg allerdings überwiegend über eingesparte Zeit beim manuellen Testen, Produktivitätssteigerungen oder schnellere Releases. Nur 21 Prozent messen den ROI anhand einer Verringerung von Produktionsvorfällen und lediglich 11 Prozent anhand sinkender Qualitätskosten. Bemerkenswert ist: Unter den Teams, die einen positiven ROI melden, berichten gleichzeitig 47 Prozent über steigende escaped defects.
Governance und Vorbereitung auf KI-Fehler bleiben schwach
Die Einführung von KI wird außerdem durch Sicherheits- und Governance-Fragen gebremst. 55 Prozent nennen Datenschutz, Sicherheit oder den möglichen Abfluss geistigen Eigentums als Hindernis für KI im Testing. Damit liegt dieses Thema noch vor der mangelnden Zuverlässigkeit beziehungsweise nicht vertrauenswürdigen KI-Ausgaben, die 50 Prozent als Barriere nennen.
Als Kontrollmaßnahmen setzen 53 Prozent auf menschliche Freigaben und 45 Prozent auf dokumentierte KI-Richtlinien. 37 Prozent führen Audit-Trails darüber, was ein KI-System getan hat. Besonders kritisch ist jedoch die Vorbereitung auf konkrete Zwischenfälle: Nur 13 Prozent verfügen über einen Incident-Response-Plan für KI-Fehler. Selbst unter den Teams, die bereits einen Anstieg von Produktionsfehlern feststellen, haben 86 Prozent keinen solchen Plan.
Der nächste große Schritt heißt autonomes Testing
Die Erwartungen an die weitere Automatisierung sind hoch. 79 Prozent erwarten, dass der überwiegende Teil ihrer Tests bereits autonom läuft oder innerhalb von zwei Jahren autonom laufen wird. Tatsächlich bezeichnen gegenwärtig erst 11 Prozent ihre Tests überwiegend als autonom. Nur 10 Prozent verfügen über Pipelines, in denen ein Agent Tests erstellt, ausführt und selbst über das Ergebnis entscheidet.
Diese Diskrepanz zwischen Erwartung und aktueller Praxis gehört zu den strategisch wichtigsten Ergebnissen des Reports. Die Entwicklung bewegt sich deutlich in Richtung autonomer Qualitätssicherung, während Verifikation, Governance und Kontrolle dieser Entwicklung noch hinterherlaufen.
Fazit: Die zentrale Herausforderung ist nicht mehr die KI-Einführung, sondern ihre Kontrolle
Die Studie zeichnet damit ein anderes Bild der KI-Transformation als noch vor wenigen Jahren. Die grundsätzliche Frage, ob KI in Entwicklung und Testing eingesetzt wird, verliert an Bedeutung. Entscheidend wird, wer oder was die Arbeit der KI zuverlässig überprüft.
Der Report liefert dafür ein klares Warnsignal: KI schreibt bereits große Mengen Produktivcode, erzeugt Tests und bewertet teilweise ihre eigenen Ergebnisse, während unabhängige automatisierte Kontrollen, systematische Evaluationen von Agenten und Incident-Response-Strukturen vielerorts noch fehlen.
Für CIOs, Entwicklungsleiter und QA-Verantwortliche ergibt sich daraus eine klare Managementaufgabe: Der Fokus der KI-Strategie sollte nicht allein auf einer höheren Generierungsleistung und kurzfristigen Produktivitätsgewinnen liegen. Verifikation, messbare Qualitätsmetriken, automatisierte Pre-Merge-Kontrollen, Agent-Evaluation und nachvollziehbare Governance müssen parallel zur KI-Nutzung ausgebaut werden. Andernfalls wächst mit der Produktivität auch das Risiko einer Kontrolllücke zwischen dem, was KI produziert, und dem, was Unternehmen tatsächlich zuverlässig prüfen können. [State of A…TestMu AI]
Einordnung der Daten: Die Befragten stammen aus der TestMu-AI-Community, nicht aus einer repräsentativen Stichprobe der gesamten Softwarebranche. 58 Prozent sind QA-Praktiker, 29 Prozent Entwickler beziehungsweise Engineers. Regional entfallen 43 Prozent auf den asiatisch-pazifischen Raum, 30 Prozent auf Nordamerika und 25 Prozent auf Europa und das Vereinigte Königreich. Zudem stammen 58 Prozent der Befragten aus SaaS-, Software- und IT-Service-Unternehmen. TestMu AI weist deshalb selbst darauf hin, dass die Ergebnisse die untersuchten Teams beschreiben und nicht ohne Weiteres für die gesamte Branche stehen.
Tipps für die Praxis
-
Pre-Merge-Checks einführen: Führen Sie vor jedem Merge automatisierte Prüfungen aus, die den KI-Code tatsächlich ausführen, nicht nur Compile- oder Typprüfungen. [2]
-
Unabhängig verifizieren: Lassen Sie KI-Ausgaben von einem System prüfen, das nicht mit dem erzeugenden Modell identisch ist. [1]
-
Modellbewertung mit Ausführung kombinieren: Ergänzen Sie LLM-as-a-Judge durch Prüfungen dessen, was die Software real tut, und validieren Sie Judges gegen menschliche Stichproben. [2][4]
-
Verständnis sicherstellen: Fordern Sie bei Reviews, dass Autoren KI-generierten Code erklären können, bevor er zusammengeführt wird.
-
Agenten-Evals als Release-Gate: Wiederholen Sie Evaluationen bei jeder Modell- oder Prompt-Änderung und koppeln Sie die CI-Pipeline daran; testen Sie auch mit Angriffs-, Geräusch- und Dialektszenarien. [2][3]
-
Budget umschichten: Planen Sie für Verifikation (Testplattformen, Evals, Observability) einen festen Anteil neben den Lizenzen für Coding-Agenten ein. [1]
-
ROI an Ergebnissen messen: Berichten Sie Produktionsvorfälle und escaped defects zusammen mit Zeitersparnis. [2]
-
Incident-Response-Plan erstellen: Definieren Sie Zuständigkeiten, Eskalationswege und Rollback-Verfahren für KI-Fehler. [1]
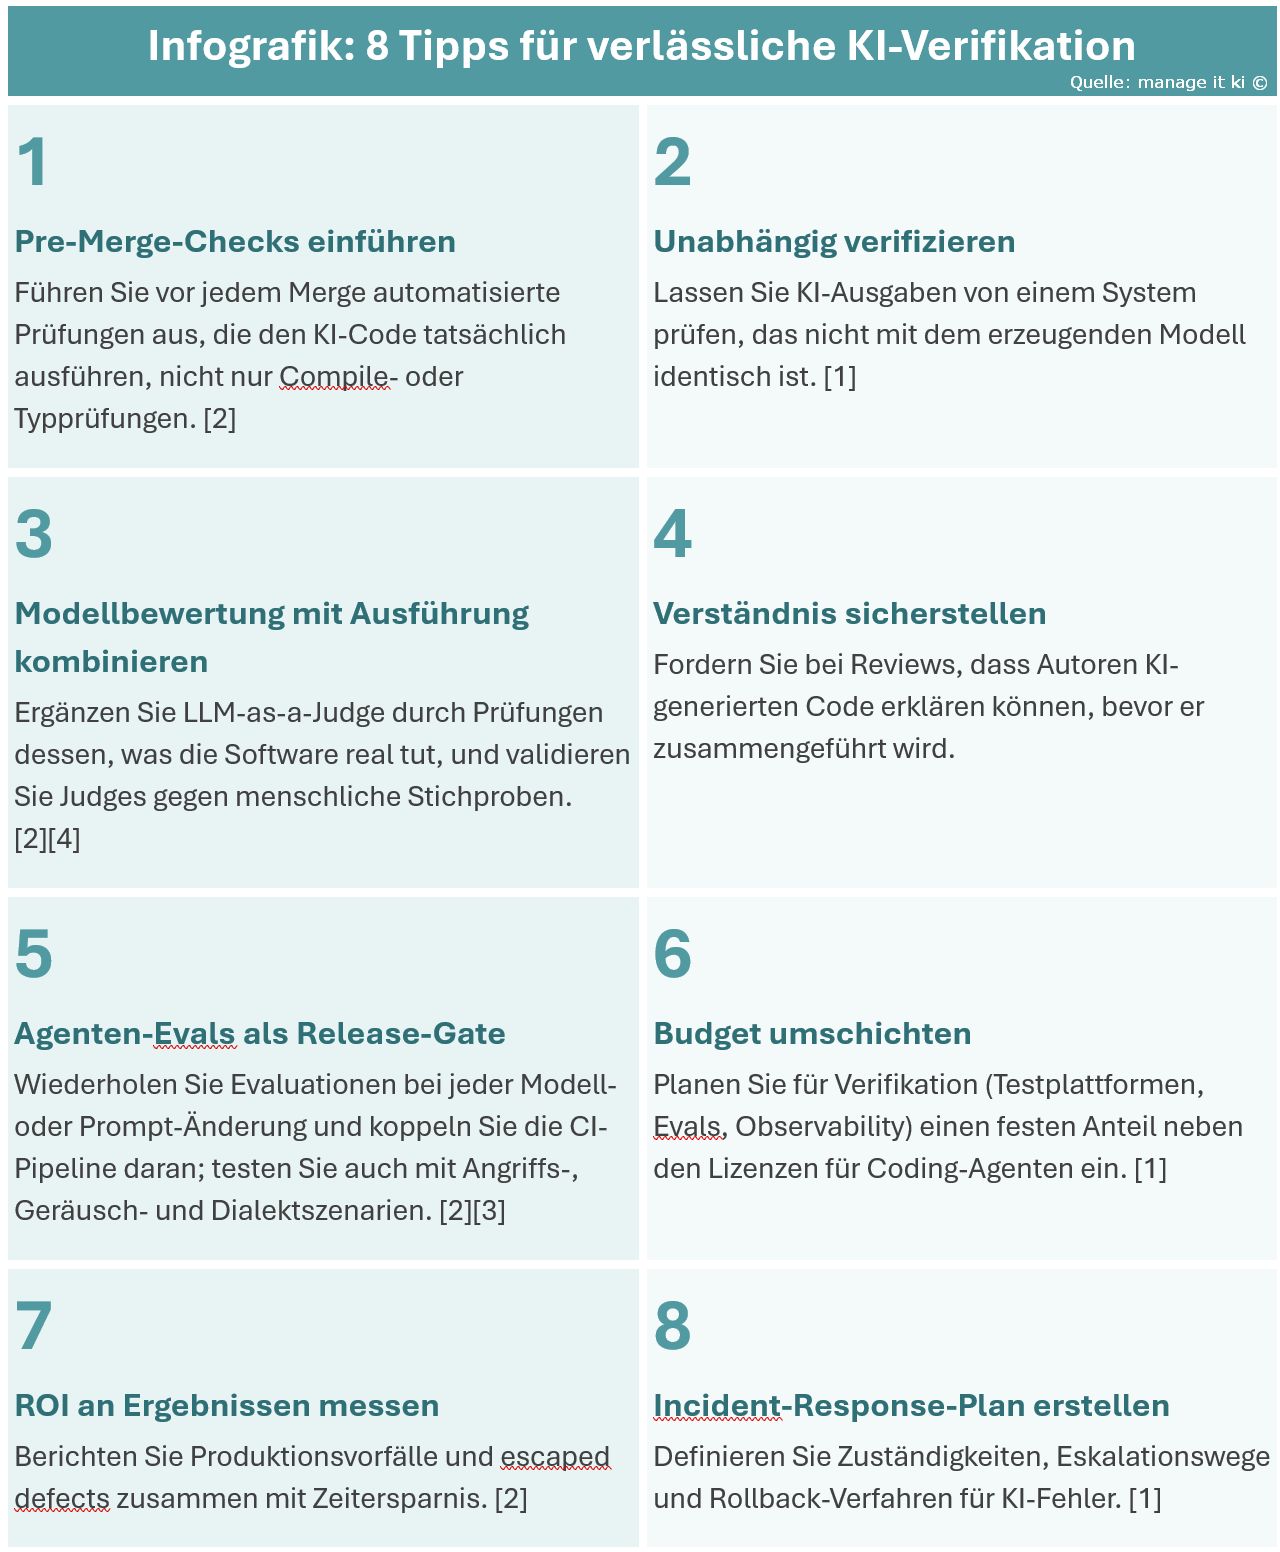
Ausführliche Tipps mit Praxisbeispielen
Die Beispiele sind illustrativ und dienen der Orientierung; die genannten Zahlen stammen aus der Studie.
1. Pre-Merge-Checks einführen
Warum: Nur 41 % der Teams prüfen KI-Code vor dem Merge automatisiert. Reine Compile- oder Typprüfungen zeigen nicht, ob der Code korrekt arbeitet.
Wie: Richten Sie eine Pipeline ein, die bei jedem Pull Request Unit-, Integrations- und Smoke-Tests startet und den Merge bei Fehlschlag blockiert.
Praxisbeispiel (illustrativ): Ein Entwicklerteam lässt einen Coding-Agenten eine Rabattlogik im Webshop schreiben. Der Pull Request startet automatisch Tests mit Warenkörben, Gutscheinen und Grenzwerten. Ein Test deckt auf, dass der Rabatt bei leerem Warenkorb einen negativen Betrag ergibt – der Merge wird blockiert, bevor der Fehler produktiv geht.
2. Unabhängig verifizieren
Warum: Wenn dasselbe Modell Code und Prüfung liefert, teilen beide dieselben Denkfehler.
Wie: Nutzen Sie für Tests ein anderes Werkzeug, ein anderes Modell oder eine klassische Testsuite, die nicht vom Code-Generator stammt.
Praxisbeispiel (illustrativ): Ein Team lässt Unit-Tests von einer eigenen QA-Person auf Basis der Anforderungen schreiben, nicht vom Agenten, der den Code erzeugt hat. Die Anforderung »Rechnungen über 10.000 € brauchen eine zweite Freigabe« wird so unabhängig geprüft und ein vom Agenten übersehener Sonderfall fällt auf.
3. Modellbewertung mit Ausführung kombinieren
Warum: LLM-as-a-Judge ist schnell, kann aber Verzerrungen wie Positions- oder Längenbias haben.
Wie: Ergänzen Sie die Bewertung durch ausführbare Prüfungen und vergleichen Sie regelmäßig Judge-Urteile mit menschlichen Stichproben.
Praxisbeispiel (illustrativ): Ein Support-Bot wird von einem Judge-Modell bewertet. Zusätzlich ruft ein Skript die echten API-Endpunkte auf und prüft, ob die genannte Bestellstatus-Antwort stimmt. Jede Woche bewerten zwei Mitarbeitende 30 zufällige Fälle; weicht der Judge in mehr als jedem fünften Fall ab, wird er neu kalibriert.
4. Verständnis sicherstellen
Warum: 81 % der Teams haben KI-Ergebnisse übernommen, die sie nicht vollständig verstanden haben.
Wie: Verankern Sie in der Review-Checkliste, dass Autoren Zweck, Ablauf und Risiken des Codes erklären können.
Praxisbeispiel (illustrativ): Im Pull-Request-Template steht die Pflichtfrage »Was macht dieser Code und was passiert im Fehlerfall?«. Kann der Autor die Frage nicht beantworten, geht der Code zurück. Bei Funktionen mit Sicherheitsbezug erklärt er sie zusätzlich kurz im Team-Review.
5. Agenten-Evals als Release-Gate
Warum: 37 % der Agenten-Entwickler haben keine systematische Evaluierung, nur 15 % nutzen sie als Quality Gate.
Wie: Pflegen Sie ein festes Evaluationsset, führen Sie es bei jeder Modell- oder Prompt-Änderung aus und definieren Sie Mindestwerte für die Freigabe.
Praxisbeispiel (illustrativ): Ein Telefonassistent hat 200 Testgespräche, darunter Hintergrundgeräusche, Dialekte und Manipulationsversuche (»Ignoriere deine Regeln«). Nach einem Modellwechsel läuft das Set automatisch; fällt die Erfolgsquote unter den festgelegten Schwellenwert, wird das Release gestoppt.
6. Budget umschichten
Warum: 50 % investieren primär in die Erzeugung von KI-Output, nur 17 % in die Verifikation.
Wie: Legen Sie bei jeder Lizenzentscheidung für Coding-Agenten einen festen Anteil für Testplattformen, Evals und Observability fest.
Praxisbeispiel (illustrativ): Eine IT-Leitung beschließt, für jeden Euro Lizenzkosten für Coding-Agenten einen definierten Anteil in Testautomatisierung und Monitoring zu investieren. Der Anteil wird im Quartals-Review überprüft und an die Fehlerentwicklung angepasst.
7. ROI an Ergebnissen messen
Warum: Meist wird nur Zeitersparnis gemessen; nur 21 % messen den ROI an weniger Produktionsvorfällen.
Wie: Ergänzen Sie Kennzahlen wie escaped defects, Vorfälle pro Release und Nacharbeitsaufwand neben der eingesparten Zeit.
Praxisbeispiel (illustrativ): Das Management-Dashboard zeigt neben »Stunden gespart beim manuellen Testen« auch die Zahl der Produktionsvorfälle je Release und die Zeit für Fehlerbehebung. So fällt auf, dass die Zeitersparnis durch mehr Nacharbeit teilweise aufgezehrt wird.
8. Incident-Response-Plan erstellen
Warum: Nur 13 % der Teams haben einen Plan für KI-Fehler.
Wie: Legen Sie Verantwortliche, Eskalationswege, Kommunikation und Rollback-Verfahren fest und üben Sie den Ablauf.
Praxisbeispiel (illustrativ): Ein KI-Agent im Kundenservice nennt falsche Vertragskonditionen. Laut Plan schaltet die diensthabende Person den Agenten per Feature-Flag ab, die Kundenanfragen laufen an das Team, die Rechtsabteilung wird informiert, und nach 48 Stunden folgt eine Nachbesprechung mit Maßnahmen.
FAQ
1. Was ist mit der »Verification Gap« gemeint?
Gemeint ist die wachsende Lücke zwischen der Menge KI-generierter Arbeit (Code, Tests, Agenten) und deren unabhängiger Überprüfung. Nur 41 % der Teams führen vor dem Merge eine automatisierte Prüfung von KI-Code durch. [1][3]
2. Wie viel Produktivcode schreibt KI heute tatsächlich?
In der Umfrage geben 40 % der Teams an, dass KI mehr als die Hälfte ihres Produktivcodes schreibt; nur 3 % sagen, dass kein Code KI-generiert ist. Am häufigsten genannt werden Claude Code (36 %) und GitHub Copilot (26 %). [2]
3. Reicht eine menschliche Freigabe als Qualitätskontrolle?
Offenbar nicht allein: 64 % der Teams lassen jeden KI-generierten Test von einer Person freigeben, und 81 % dieser Teams haben dennoch schon KI-Ausgaben übernommen, die sie nicht vollständig verstanden haben. [2]
4. Führt mehr KI-Code automatisch zu mehr Fehlern?
Die Studie stellt keinen einfachen kausalen Zusammenhang her. 44 % berichten von mehr Fehlern in Produktion, entscheidend scheint jedoch zu sein, wie der Code geprüft wird. Die Ergebnisse sind laut TestMu AI Zusammenhänge, keine Beweise. [2][3]
5. Was ist »LLM-as-a-Judge« und wo liegt das Risiko?
Dabei bewertet ein Sprachmodell die Ausgaben eines anderen. Nutzer dieses Verfahrens übernehmen laut Studie doppelt so häufig KI-Ergebnisse, die sie nicht verstehen (29 % gegenüber 15 %). Die Autoren betonen, dass dies kein kausaler Beweis ist. [1][3]
6. Welche Verzerrungen haben KI-Bewerter (LLM-Judges)?
Dokumentiert sind unter anderem Positionsbias (bevorzugt die zuerst genannte Antwort), Längenbias (belohnt ausführlichere Antworten) und Selbstbevorzugung (eigene Modellfamilie wird besser bewertet). Abhilfe schaffen vertauschte Reihenfolgen, Gegenprüfung mit Menschen und ein anderes Judge-Modell. [4][5][6]
7. Welche Maßnahmen wirken vor dem Merge?
Teams mit separaten automatisierten CI-Tests melden seltener steigende »escaped defects« (38 % gegenüber 49 %). In einer kleinen Gruppe lag der Wert bei Teams, deren Coding-Agent die Anwendung ausführt, bei 24 % statt 47 %. [2][3]
8. Wie lassen sich KI-Agenten sinnvoll testen?
Laut Studie haben 37 % der Agenten-Entwickler keine systematische Evaluierung; nur 28 % testen gegen Nutzer, die den Agenten gezielt austricksen, 27 % wiederholen Evaluationen nach Modell- oder Prompt-Änderungen und 15 % nutzen sie als Quality Gate in der CI-Pipeline. [2][3]
9. Wie sollte der ROI von KI im Testing gemessen werden?
73 % der Teams berichten von positivem ROI, doch 47 % von ihnen melden zugleich steigende »escaped defects«. Empfohlen wird, Defekte und Vorfälle neben der eingesparten Zeit auszuweisen; bisher tun dies nur 21 %. [2]
10. Wie belastbar ist die Studie?
Befragt wurden Mitglieder der TestMu-AI-Community, keine repräsentative Stichprobe: 58 % sind QA-Praktiker, 29 % Entwickler; 43 % der Organisationen sitzen in Indien, 23 % in den USA, 58 % in SaaS-, Software- und IT-Service-Unternehmen. Die Zahlen beschreiben die befragten Teams, nicht die gesamte Branche. [2]
Quellen
[1] https://www.testmuai.com/research/state-of-ai-in-quality-engineering/
[2] https://www.testmuai.com/blog/ai-in-quality-engineering-report/
[3] https://www.prnewswire.com/news-releases/laut-dem-testmu-bericht-state-of-ai-in-quality-engineering-2026-haben-81–der-softwareteams-ki-generierten-code-integriert-den-sie-nicht-vollstandig-verstanden-haben-302938907.html
[4] https://www.openlayer.com/blog/llm-as-judge-evaluation-guide
[5] https://llm-academy.dev/observability/llm-as-judge/
[6] https://arxiv.org/abs/2510.12462
Management Summary, Tipps, FAQ und Bilder wurden mit Hilfe von KI erstellt
283 Artikel zu „KI Code Testing“
Business Process Management | Geschäftsprozesse | Künstliche Intelligenz | News | Strategien | Tipps
Wenn der KI-Agent 13 sagt und es 17 sind: Datenprodukte richtig validieren
Ein Datenprodukt ist nicht fertig, wenn es bereitgestellt ist. Erst wenn Fachexperten seine Antworten bestätigen, Fehlerquellen systematisch geprüft und Definitionen versioniert sind, können Führungskräfte einem KI-Agenten vertrauen. Management Summary Bereitstellung ist nicht das Ziel: Der Nutzen eines Datenprodukts ist erst belegt, wenn es nachweislich die tatsächliche Arbeit und Effizienz verbessert. Fachbereich als Maßstab: Fachexperten testen…
Favoriten der Redaktion | IT-Security | Künstliche Intelligenz | News | Tipps
KI-Software braucht klare Bezugswege: Was Unternehmen aus Yoba lernen können
Bekannte KI-Marken, überzeugende GitHub-Projekte und echte digitale Signaturen: Die Yoba-Kampagne verbindet mehrere Vertrauenssignale zu einer Download-Falle. Für CIOs und CISOs steht damit nicht nur die Auswahl von KI-Diensten auf der Agenda, sondern auch die kontrollierte Bereitstellung ihrer Desktop-Anwendungen. Entscheidend sind geprüfte Bezugswege und die Kontrolle des ausgeführten Codes – nicht allein das Logo oder die…
Ausgabe 9-10-2026 | Digitale Transformation | IT-Security | Künstliche Intelligenz | News | Security Spezial 9-10-2026
Governance by Design: KI sicher in den Workflow einbinden – Mit Prozessplattformen KI-Agenten steuerbar machen
Agentische KI verbreitet sich in deutschen Unternehmen schnell. Ohne klaren Rahmen entsteht eine Blackbox, in der Agenten auf zu viele Daten zugreifen und Entscheidungen kaum noch nachvollziehbar sind. Werden KI-Agenten in eine zentrale Prozessplattform eingebettet, lässt sich Governance von Beginn an im Workflow verankern.
Business Process Management | Digitalisierung | Künstliche Intelligenz | New Work | News | Services | Tipps | Trends 2026 | Trends Services
Mehr Code, mehr Reibung: Warum KI allein die Softwareentwicklung nicht beschleunigt

KI lässt Entwicklerinnen und Entwickler schneller Code produzieren – doch sie beschleunigt nicht automatisch die gesamte Softwarelieferung. Die Atlassian-Studie »State of Developer Experience 2026« zeigt: Organisatorische Engpässe, aufwendige Reviews, technische Schulden und fehlende Strategien zehren viele lokale Zeitgewinne wieder auf. Für CIOs und Entwicklungsleitungen kommt es deshalb weniger auf die Zahl eingesetzter Tools an als…
IT-Security | News | Veranstaltungen
it-sa 2026: Cybersecurity zwischen KI, Regulierung und digitaler Souveränität
Die it-sa Expo&Congress 2026 wird größer, internationaler und strategischer. Zwischen KI-gestützten Angriffen, regulatorischem Umsetzungsdruck und der Absicherung vernetzter Produktionsumgebungen verschiebt sich der Fokus von isolierten Sicherheitsprodukten hin zu belastbaren Betriebsmodellen. Der Meldungsüberblick zeigt, welche Anbieter, Technologien und Managementfragen vom 27. bis 29. Oktober in Nürnberg im Mittelpunkt stehen – und wie CIOs, CISOs und Geschäftsleitungen…
Business | Business Process Management | Digitalisierung | Effizienz | ERP | Geschäftsprozesse | Künstliche Intelligenz | News | Tipps | Trends 2026 | Trends Geschäftsprozesse
Agentic AI braucht Prozesswissen: Warum KI-Piloten an der Betriebsrealität scheitern
Prozesskontext verbindet Daten, Regeln, Rollen und Kontrollen – damit KI-Agenten nicht nur handeln, sondern innerhalb definierter Leitplanken handeln. Unternehmen mit starkem Prozessverständnis erzielen 5-mal häufiger erfolgreiche KI-Ergebnisse Management Summary Prozesswissen entscheidet über den KI-Erfolg: Unternehmen mit ausgeprägtem Prozesskontext berichten laut der von ARIS und The Hackett Group veröffentlichten Studie fünfmal häufiger von sehr erfolgreichen KI-Ergebnissen.[1]…
Business | Digitale Transformation | Effizienz | Geschäftsprozesse | Künstliche Intelligenz | New Work | News | Strategien
Die Rolle des CIO/CAIO wandelt sich: Mein neuer Mitarbeiter, der KI-Agent
Digitale Belegschaft unter Aufsicht: KI-Agenten brauchen klare Rollen, begrenzte Rechte und messbare Ziele. Management Summary KI-Agenten sind keine klassische Software: Sie bearbeiten Aufgaben eigenständig, benötigen dafür aber klare Ziele, belastbaren Kontext und definierte Entscheidungsgrenzen. Der CIO wird zum Orchestrator digitaler Arbeitskräfte: Auswahl, Onboarding, Rollenverteilung und laufende Kontrolle von Agenten werden zu einer Führungs- und…
IT-Security | Kommentar | Künstliche Intelligenz | News
Alarmflut im Sicherheitszentrum – Mit Automatisierung und KI der Alert Fatigue entgegenwirken
Wenn im Security Operations Center jede Warnung gleich laut ist, wird aus Schutz schnell Überlastung. Alert Fatigue ist deshalb kein reines Effizienzproblem, sondern ein Managementrisiko: Kritische Signale können im Grundrauschen untergehen, Reaktionszeiten steigen und Fachkräfte werden durch repetitive Triage gebunden. KI und Automatisierung schaffen Abhilfe, wenn sie Meldungen kontextualisieren, priorisieren und wiederkehrende Abläufe standardisieren –…
Infrastruktur | IT-Security | Künstliche Intelligenz | News | Tipps
Analyse zu KI-gestützten Cyberangriffen und Modell-Ausbrüchen
Management Summary KI wird zur neuen Angriffsoberfläche: Der aktuelle »AI Threat Landscape Digest« von Check Point Research zeigt, wie Testmodelle aus isolierten Umgebungen ausbrechen, Cyberkriminelle KI-Tools für autonome Angriffsketten nutzen und Unternehmen mit einer rasant wachsenden Patch- und Governance-Komplexität konfrontiert werden. Für Entscheider wird damit klar: KI-Sicherheit ist nicht länger ein Spezialthema der IT, sondern…
IT-Security | Künstliche Intelligenz | News | Strategien | Tipps
Schwachstellenmanagement im KI-Zeitalter – Wie Unternehmen KI-generierte Exploits mit einer »Containment First«-Architektur bremsen können

KI beschleunigt die Schwachstellenforschung – und damit auch die Angriffsgeschwindigkeit. Klassische Patch-Zyklen geraten unter Druck, weil Exploits schneller entstehen, als Unternehmen Updates sicher testen und ausrollen können. Der Beitrag zeigt, warum Sicherheitsverantwortliche Schwachstellenmanagement neu denken müssen und weshalb eine »Containment First«-Architektur mit identitätsbasierter Mikrosegmentierung zum strategischen Hebel gegen KI-generierte Exploits wird. Management Summary KI verkürzt…
Digitale Transformation | Favoriten der Redaktion | IT-Security | Künstliche Intelligenz | News | Strategien | Trends 2026 | Trends Security | Whitepaper
KI-Sicherheit in Unternehmen: Warum Governance, Sichtbarkeit und Deepfake-Abwehr jetzt entscheidend sind
Deutsche Unternehmen fühlen sich beim Schutz ihrer KI-Systeme gut vorbereitet – doch die Erkennung böswilligen oder unerwarteten KI-Verhaltens bleibt deutlich zurück. Der TrendAI-Report zeigt eine gefährliche Lücke zwischen Governance-Anspruch und operativer Sicherheitsrealität. Für Entscheider wird KI-Sicherheit damit zur Managementaufgabe: Sichtbarkeit, Testing, Deepfake-Abwehr und wirksame Eingriffsmechanismen müssen von Anfang an Teil jeder Enterprise-AI-Strategie sein. Management Summary…
Künstliche Intelligenz | News | Services | Trends 2026 | Trends Services
KI verändert die Softwareentwicklung, der Bedarf an Entwicklern bleibt hoch

KI ist in der Softwareentwicklung angekommen – doch der Sprung vom Pilotprojekt in den produktiven Maßstab gelingt nur mit Governance, sicheren Prozessen und gezieltem Kompetenzaufbau. Eine Studie zeigt, wo Unternehmen im DACH-Raum stehen, welche Effekte bereits messbar sind und warum Entwickler weiterhin gefragt bleiben. Management Summary KI ist etabliert, aber kaum industrialisiert: 91 % der…
IT-Security | Künstliche Intelligenz | News | Trends 2026 | Trends Security
Neuer »AI Threat Tracker« zeigt: Angreifer setzen zunehmend auf autonome KI
Die Google Threat Intelligence Group (GTIG) hat ihren neuen Bericht »AI Threat Tracker: From Prompting to Autonomy – The Evolution of Adversarial AI« veröffentlicht. Der Report zeigt, wie sich der Einsatz von KI durch Cyberangreifer weiterentwickelt: von einfachen Prompts hin zu agentenbasierten, automatisierten Workflows, die mehrere Schritte eines Angriffs weitgehend selbstständig durchführen können. Das…
Business Process Management | Digitale Transformation | Geschäftsprozesse | Künstliche Intelligenz | New Work | News | Strategien | Trends 2026 | Trends Geschäftsprozesse | Trends Infrastruktur
KI-Skalierung braucht mehr als Strategie: Warum Digital Re-Engineering jetzt zur CIO-Priorität wird
Die aktuelle CGI-Studie »Voice of Our Clients« zeigt: KI ist in den Führungsetagen gesetzt, doch zwischen strategischem Anspruch und produktiver Skalierung klafft weiterhin eine deutliche Lücke. Für Unternehmen wird damit Digital Re-Engineering zur Kernaufgabe – von modernisierten IT-Landschaften über belastbare Datenarchitekturen bis hin zu Governance, Resilienz und messbarem Business-Impact. Management Summary KI ist Chefsache –…
Favoriten der Redaktion | IT-Security | News | Trends 2026 | Trends Security
KI-gesteuerte Bot-Angriffe stiegen um das 12,5-fache an
KI-gesteuerte Automatisierung beschleunigt die maschinelle Online-Aktivität, da Bots die Menschen überholen und die Funktionsweise des Internets neu definieren. Bots dominieren nun das Internet und machen mehr als die Hälfte des gesamten Datenverkehrs aus, wobei 40 % als böswillig eingestuft werden. KI löscht die Grenze zwischen legitimen und böswilligen Aktivitäten und macht die Absicht – nicht…
Business | Digitalisierung | Favoriten der Redaktion | Geschäftsprozesse | Künstliche Intelligenz | News | Services | Strategien | Trends 2030 | Trends Services | Trends Wirtschaft | Whitepaper
KI bringt Geschäftsmodelle der Softwarebranche ins Wanken

Statt für Arbeitszeit wird künftig stärker für messbare Ergebnisse bezahlt. Branchenwissen als Wettbewerbsvorteil für deutsche Anbieter. Bitkom veröffentlicht Studie »Softwarewelt 2036« [1]. Die Softwarebranche muss sich auf tiefgreifende Veränderungen ihrer Geschäftsmodelle einstellen. Weil KI-Agenten zunehmend selbst Arbeit verrichten und nicht mehr nur als Werkzeug bedient werden, verschiebt sich, wofür Kundinnen und Kunden zu bezahlen…
Business Process Management | Geschäftsprozesse | Künstliche Intelligenz | News | Services
AutoScout24 treibt Softwareentwicklung mit KI-basierten Workflows voran

Codex und ChatGPT verkürzen Entwicklungszyklen, erhöhen Code-Qualität und verankern KI im Engineering-Alltag von rund 2.000 Mitarbeitenden. Digitale Plattformen stehen unter massivem Innovationsdruck: steigende Anforderungen an Time-to-Market, wachsende Systemkomplexität und begrenzte Entwicklerressourcen fordern ein Umdenken in der Softwareentwicklung. Die AutoScout24 Group adressiert diese Herausforderungen mit dem systematischen Einsatz von künstlicher Intelligenz entlang der gesamten Software-Lifecycle.…
Business | Business Process Management | Digitalisierung | New Work | News | Services
Von KI-Implementierung zu Business Value: Was Unternehmen jetzt richtig machen müssen

Management Summary KI-gestützte Software-Innovation ist laut GitLab-Studie ein konkreter Produktivitätshebel: Unternehmen berichten von durchschnittlich rund 29.000 Euro eingesparter Entwicklerzeit pro Mitarbeitendem und Jahr – hochgerechnet ergibt sich für Deutschland ein Potenzial von über 26 Milliarden Euro jährlich. Für CTOs verschiebt sich der Fokus von «KI einführen» zu «Business Value realisieren»: Erfolgreiche Organisationen priorisieren wenige, wirkungsstarke…
Digitale Transformation | Favoriten der Redaktion | Künstliche Intelligenz | News | Strategien | Trends 2026 | Trends Services
KI erhöht Softwarekomplexität: Rückbesinnung auf Engineering-Grundlagen

Die 34. Ausgabe des halbjährlichen Technology Radar markiert einen entscheidenden Wendepunkt: Während die KI-gestützte Softwareentwicklung eine radikale Transformation darstellt, zwingt sie Technologieexperten gleichzeitig zur Rückbesinnung auf grundlegende Engineering-Praktiken [1]. Frühere Ausgaben beleuchteten die wachsenden Fähigkeiten aufstrebender KI. Die 34. Ausgabe konzentriert sich darauf, wie die Branche Reibungsverluste und Risiken beim Einsatz dieser Technologien in…
Business | Favoriten der Redaktion | IT-Security | Künstliche Intelligenz | News | Trends 2026 | Trends Security | Whitepaper
Warum die Qualität der KI trotz steigender Adoption nicht Schritt hält

KI‑Adoption steigt – Qualität stagniert oder sinkt: Trotz breiter Einführung von KI‑Features scheitert über die Hälfte der KI‑Initiativen am Übergang in den produktiven Betrieb; Halluzinationen und Fehlinterpretationen nehmen wieder zu. Teststrategien kommen nicht hinterher: Unternehmen setzen zwar stärker auf KI‑gestützte und menschliche Testmethoden, doch die Geschwindigkeit und Komplexität der KI‑Entwicklung überfordern klassische QA‑Prozesse. Multimodale KI…
1550 Artikel zu „KI Qualität Code“
Business Process Management | Effizienz | Infrastruktur | Künstliche Intelligenz | News | Rechenzentrum | Strategien | Tipps
KI-Fabrik vor Ort: Warum On-Premises-Inferenz die Wirtschaftlichkeit von Enterprise-KI neu definiert

Mit jeder Anfrage steigen die Kosten: Sobald generative KI im Produktivbetrieb angekommen ist, wird die Inferenz zum entscheidenden Faktor für Wirtschaftlichkeit, Datenhoheit und Verfügbarkeit. Paul Speciale, Chief Strategy Officer bei Scality, erläutert, warum Unternehmen ihre KI-Workloads nicht mehr pauschal in die Public Cloud verlagern sollten, welche Rolle Speicher im KV-Cache spielt und weshalb ein hybrides…
Business Process Management | Geschäftsprozesse | Künstliche Intelligenz | News | Strategien | Tipps
Wenn der KI-Agent 13 sagt und es 17 sind: Datenprodukte richtig validieren
Ein Datenprodukt ist nicht fertig, wenn es bereitgestellt ist. Erst wenn Fachexperten seine Antworten bestätigen, Fehlerquellen systematisch geprüft und Definitionen versioniert sind, können Führungskräfte einem KI-Agenten vertrauen. Management Summary Bereitstellung ist nicht das Ziel: Der Nutzen eines Datenprodukts ist erst belegt, wenn es nachweislich die tatsächliche Arbeit und Effizienz verbessert. Fachbereich als Maßstab: Fachexperten testen…
Business Process Management | IT-Security | News | Services | Whitepaper
Output Management zwischen Kostendruck, Sicherheit und KI
Druck- und Outputprozesse entwickeln sich für größere Unternehmen zunehmend zu einer Schnittstelle zwischen IT-Sicherheit, Regulierung, Kostenkontrolle und Digitalisierung. Darauf verweist eine Marktstudie von SPS und YouGov, für die 209 mittlere und große Unternehmen in Deutschland befragt wurden. Besonders hoch gewichtet werden Sicherheits- und Compliance-Themen. 61 Prozent der befragten Unternehmen nennen steigende Anforderungen an IT-Sicherheit und…
Business | Künstliche Intelligenz | News | Strategien
KI und Berufseinstieg: Zwischen Entwarnung und strukturellen Warnsignalen
KI-generierte Symbolillustration: Berufseinstieg im technologischen Wandel. KI verändert den Berufseinstieg – doch pauschaler Stellenabbau wäre die falsche Schlussfolgerung. Die deutschen Beschäftigungsdaten zeigen bislang keinen allgemeinen Einbruch in KI-exponierten Berufen, wohl aber Warnsignale für junge Beschäftigte. [1] Für Geschäftsführung, CIOs und Personalverantwortliche geht es deshalb um mehr als Effizienz: Einstiegswege sichern, Kompetenzen aufbauen und Automatisierung…
Business Process Management | Cloud Computing | Effizienz | Infrastruktur | Künstliche Intelligenz | News | Rechenzentrum | Strategien | Tipps
Von der GPU-KI-Infrastruktur zur Token Factory: Warum bei KI das Ergebnis zählt
Mehr GPUs und günstigere Token allein machen KI noch nicht wirtschaftlich. Mit agentischen Anwendungen wächst der Aufwand für mehrstufige Prozesse, wechselnde Lasten und verlässliche Ergebnisse. Das Betriebsmodell der Token Factory verbindet Ressourcenmanagement, Inferenzoptimierung und Servicequalität. Für IT-Verantwortliche rückt damit eine andere Frage in den Mittelpunkt: Was kostet eine erfolgreich erledigte Aufgabe – und welche Architektur…
Business Process Management | Digitale Transformation | Favoriten der Redaktion | Künstliche Intelligenz | New Work | News | Trends 2026 | Trends 2030 | Trends Wirtschaft
KI wird bis 2030 netto 1,7 Millionen Arbeitsplätze schaffen

KI und Arbeitsplätze: Positive Bilanz, tiefgreifender Wandel KI dürfte nach Gartner bis 2030 weltweit mehr Arbeitsplätze schaffen als verdrängen. Doch die positive Nettobilanz von 1,7 Millionen Stellen verdeckt den größeren Umbruch: Mehr als 20 Prozent der Beschäftigten sollen ihre Aufgaben und Arbeitsweisen anpassen müssen. Für Geschäftsführung, CIOs und Personalverantwortliche geht es deshalb nicht nur um…
Business Process Management | Digitale Transformation | Künstliche Intelligenz | News | Strategien | Tipps | Trends 2026 | Trends Geschäftsprozesse
KI auf Erfolgskurs, Unternehmen im Stresstest: Deutschlands neue Readiness-Lücke

KI schafft messbaren Nutzen, erhöht aber zugleich die Anforderungen an Unternehmen: 56 Prozent der deutschen Befragten berichten von positiven Erträgen ihrer KI-Investitionen, während die durchschnittliche vollständige Bereitschaft für externe Risiken bei nur 25 Prozent liegt. Der Kyndryl Readiness Report 2026–27 zeigt, warum eine modernisierte IT allein nicht genügt. Für Geschäftsführung und CIOs geht es jetzt…
Business | Favoriten der Redaktion | Geschäftsprozesse | Kommunikation | New Work | News | Services | Tipps
Skill-Management als Wettbewerbsvorteil: Von der reinen Personalentwicklung zur Unternehmenssteuerung

Management Summary Skills gehören auf die Managementagenda. Fehlende Fähigkeiten gefährden Lieferfähigkeit, Qualität und Innovation. Entscheidend ist nicht allein die Personalstärke, sondern die Passung zwischen Aufgabe, Qualifikation und Einsatzzeitpunkt. Das Business definiert den Bedarf, HR schafft den Rahmen. Fachbereiche benennen geschäftskritische Fähigkeiten; HR übersetzt sie in Recruiting, Entwicklung und interne Mobilität. Klare Verantwortlichkeiten verhindern ein isoliertes…
Business | Business Process Management | Digitale Transformation | Effizienz | Favoriten der Redaktion | Künstliche Intelligenz | New Work | News | Services | Strategien | Tipps
Die größte Herausforderung für CIOs: KI-Nutzen, Risiken und Sicherheit in Einklang bringen

KI soll Wertschöpfung beschleunigen – darf aber nicht schneller Risiken aufbauen als Nutzen. Für CIOs wird deshalb die Verbindung von Geschäftszielen, Sicherheitskontrollen und klaren Entscheidungsrechten zum Prüfstein. Gartners Value-Risk Flywheel liefert dafür ein Denkmodell: Gute Dynamik stärken, schädliche Dynamik begrenzen und Kontrolle dort verankern, wo KI tatsächlich auf Daten und Prozesse zugreift. Management Summary Geschäftswert…
Business Process Management | Geschäftsprozesse | Kommunikation | Künstliche Intelligenz | News | Services | Tipps | Trends 2026 | Trends Services
KI bei Versicherern: Viele Anwendungen, zu wenig Kundennutzen

KI ist in der Versicherungsbranche angekommen – ihr Nutzen beim Kunden noch nicht überall. Eine Studie von techconsult und puntus zeigt: Während 47 Prozent der Befragten eine höhere Kundenzufriedenheit erwarteten, berichten bislang 28 Prozent von messbaren Verbesserungen. Versicherer mit produktiv eingesetzter Process Intelligence erzielen häufiger positive KI-Effekte. Für das Management rückt damit eine andere Frage…
Business Process Management | Digitale Transformation | Künstliche Intelligenz | News | Strategien | Tipps | Trends 2026 | Trends Geschäftsprozesse | Trends Infrastruktur
Deutsche Unternehmen überschätzen ihre KI-Reife

86 Prozent der Entscheider sagen, ihr Unternehmen stelle sich öffentlich KI-reifer dar, als es ist. Weltweit sind es 75 Prozent. KI-Reife zeigt sich nicht im Selbstbild, sondern im Geschäftsergebnis. Die vorliegenden Studienergebnisse machen deutlich, wie weit Anspruch und Umsetzung auseinanderliegen. Für Geschäftsführung und IT-Verantwortliche wird damit die organisatorische Veränderung zur entscheidenden Aufgabe: Prozesse neu gestalten,…
IT-Security | Künstliche Intelligenz | News | Tipps | Trends 2026 | Trends Security
Angreifer missbrauchen vertrauenswürdige KI- und IT-Tools für Attacken gegen Unternehmen

KI-Agenten beschleunigen Geschäftsprozesse – und eröffnen Angreifern neue Wege in die Unternehmens-IT. Der Elastic-Bericht »Threats, etc.« beschreibt den Missbrauch legitimer KI-Anwendungen, signierter Fernwartungstools und gestohlener Zugangsdaten. Für IT-Verantwortliche lautet die Konsequenz: Nicht die Freigabe einer Software entscheidet über Sicherheit, sondern ihr tatsächliches Verhalten. Gefragt sind begrenzte Rechte, systemübergreifende Transparenz und schnelle Reaktionsprozesse. [1] Management Summary…
Business | Favoriten der Redaktion | IT-Security | Künstliche Intelligenz | News | Tipps | Trends 2026 | Trends Security
KI-Agenten ohne Kontrolle: Warum Unternehmen ihre KI-Identitäten jetzt steuern müssen

KI-Agenten beschleunigen Abläufe, greifen auf Unternehmensdaten zu und übernehmen zunehmend eigenständige Aufgaben. Doch ihr Handlungsspielraum wächst schneller als die passenden Sicherheitskontrollen. Die globale SailPoint-Studie verdeutlicht diese Lücke. Für IT-Verantwortliche kommt es jetzt darauf an, Transparenz, eindeutige Zuständigkeiten und begrenzte Zugriffsrechte miteinander zu verbinden – damit aus Automatisierung kein Kontrollverlust wird. [1, 3] Management Summary Governance…
Business | Business Process Management | Geschäftsprozesse | Künstliche Intelligenz | New Work | News | Services | Strategien | Tipps | Whitepaper
KI-Wertschöpfung: Europas KI-Chance liegt nicht nur im besten Modell

KI muss sich im Prozess rechnen, nicht nur im Benchmark glänzen. Eine Studie der Bertelsmann Stiftung zeigt: In Softwareentwicklung, Bankgeschäft und Private Equity sind Produktivitätsgewinne bislang besser belegt als neue Erlöse. Leistungsfähige Open-Weight-Modelle erweitern dabei die Auswahl – oft zu niedrigeren Nutzungspreisen. Für CIOs zählt deshalb das Zusammenspiel von Qualität, Gesamtkosten, Daten und Governance. [1]…
Business | Digitale Transformation | Effizienz | Geschäftsprozesse | Künstliche Intelligenz | New Work | News | Services
Zwischen KI und Margendruck: »Im Staffing entscheidet sich die Profitabilität«
Die deutsche Beratungsbranche wuchs 2025 laut BDU lediglich um 0,5 Prozent. Für 2026 prognostizierte der Verband im März eine Erholung – kein Freibrief für ineffiziente Prozesse. [2] Im Interview erläutern Arnaud Cammas und Sebastian Klotz von Napta, wie Ressourcenmanagement Kompetenzen, Verfügbarkeiten und Projektkosten zusammenführen soll. Im Mittelpunkt stehen der wirtschaftliche Nutzen KI-gestützter Planung, nachvollziehbare Entscheidungen…
Business Process Management | Cloud Computing | Digitale Transformation | Effizienz | Infrastruktur | Kommunikation | Künstliche Intelligenz | News | Rechenzentrum
Deep Networking: Das Netzwerk als Leistungshebel für KI-Cluster
Rechenleistung allein beschreibt noch nicht die Leistungsfähigkeit eines KI-Clusters: Beim verteilten Training müssen Beschleuniger Daten austauschen, bei disaggregierter Inferenz verbindet das Netzwerk getrennte Verarbeitungspools. Aria Networks setzt mit »Deep Networking« auf eine Kombination aus Switching-Hardware, Telemetrie und automatisierter Steuerung. Für IT-Entscheider stellt sich damit eine konkrete Prüfaufgabe: Welcher Nutzen lässt sich unter realistischen Lasten bei…
Business Process Management | Cloud Computing | Digitale Transformation | Favoriten der Redaktion | Infrastruktur | Künstliche Intelligenz | News | Rechenzentrum | Services | Strategien | Tipps
Cloud, Open Source und KI: Sechs Irrtümer über digitale Souveränität

Eigene Server, deutsche Rechenzentren, offene Software: Für sich genommen macht keiner dieser Bausteine eine IT souverän. Entscheidend ist, ob Unternehmen ihre Daten kontrollieren, Abhängigkeiten kennen und bei Bedarf auf Alternativen wechseln können. Der Faktencheck ordnet sechs verbreitete Irrtümer ein – und zeigt, welche Fragen CIOs bei Cloud, KI und IT-Governance stellen sollten. Management Summary Handlungsfreiheit…
Business | Digitale Transformation | Geschäftsprozesse | Infrastruktur | Künstliche Intelligenz | News | Rechenzentrum | Strategien | Tipps
Milliarden für KI: Warum Wachstum allein die Investitionen nicht rechtfertigt
Der Ausbau von KI-Infrastruktur bindet Kapital – doch hohe Investitionen allein sind noch kein Nachweis für wirtschaftlichen Erfolg. Für Unternehmensentscheider steht deshalb eine grundlegende Frage im Mittelpunkt: Welche KI-Anwendungen schaffen messbaren Nutzen, und welche binden vor allem Budget? Eine belastbare Bewertung muss Finanzierung, laufende Kosten und tatsächliche Nutzung zusammenführen. Entscheidend ist nicht die Größe der…
Business | Business Process Management | Favoriten der Redaktion | Geschäftsprozesse | IT-Security | Künstliche Intelligenz | News | Tipps | Whitepaper
Frontier-KI: TÜV fordert unabhängige Prüfungen statt Herstellervertrauen
Leistungsfähige KI unabhängig prüfen, statt sich allein auf Sicherheitsangaben der Entwickler zu verlassen: Dafür schlagen TÜV-Verband und TÜV AI.Lab eine neue Prüf- und Aufsichtsstruktur vor. Sie soll Modellbewertungen mit Branchenkompetenz verbinden und Deutschland sowie Europa eine eigenständige Risikobeurteilung ermöglichen. Für IT-Entscheider stellt das Konzept die Frage in den Mittelpunkt, welche Sicherheitsnachweise vorliegen müssen, bevor KI-Agenten…
Business Process Management | IT-Security | Künstliche Intelligenz | News | Tipps
KI-Coding-Agenten: Autonomie braucht klare Zugriffsregeln
KI-Coding-Agenten machen Berechtigungen zu einer Managementfrage: Entscheidend ist nicht allein, welche Aufgabe erteilt wird, sondern welche Werkzeuge, Daten und Systeme dafür erreichbar sind. Sicherheitsleitfäden empfehlen begrenzte Rechte, überprüfbare Aktionen und menschliche Freigaben für besonders folgenreiche Schritte. Der Beitrag ordnet diese Anforderungen ein. [1][2] Die Telemetriezahlen und der beschriebene Kontrollansatz stammen aus einer Anbieter-Pressemitteilung vom 21.…